

Lab 51 – Notifiche, metriche e log: target SMTP e Gotify, matcher, InfluxDB e Grafana, log centralizzati
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- Lab 07: container da template;
- Lab 04: il proxy del laboratorio, configurato nel Datacenter e per
apt; - Lab 41: i container da immagine OCI e il download con
skopeodietro proxy; - Lab 32 e lab 33: firewall del Datacenter, IPSet
management; - Lab 46 e lab 49: i job di backup e il fencing che hanno generato notifiche.
- Sistemi: il cluster
deso-cluster(desopve01-03), gli storagecephfs(template) erbd-vm(dischi dei container). - Indirizzi nuovi: CT 151
mailpit172.27.199.151, CT 152gotify172.27.199.152, CT 153monitor172.27.199.153. - Credenziali:
root@pame la password del laboratorio → Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Le notifiche dei lab precedenti ritrovate e consegnate: coda di Postfix vuota sui tre nodi, messaggi visibili in un server di posta di prova (Mailpit).
- Un target SMTP, un target Gotify e il target
sendmailpredefinito, smistati da due matcher: un backup fallito notificato su tutti e tre, con priorità 9 in Gotify. - Le metriche del cluster in un bucket InfluxDB 2, scritte con un token di sola scrittura e mostrate in Grafana con un token di sola lettura.
- I log dei tre nodi raccolti da un server rsyslog centrale, un file per nodo e per programma, con orari che coincidono con quelli dei nodi.
- Il container di monitoraggio dietro il suo firewall: solo i nodi scrivono metriche e log, solo la rete di gestione raggiunge Grafana, e un guest che non è un nodo viene bloccato.
Come funziona
Sezione intitolata “Come funziona”Notifiche. Dalla versione 8.1 ogni evento che Proxmox VE vuole comunicare (backup, replica, fencing, aggiornamenti disponibili, posta di sistema) passa per un unico sistema di notifiche, configurato in Datacenter → Notifications e salvato in /etc/pve/notifications.cfg (i segreti in /etc/pve/priv/notifications.cfg).
- Un target è una destinazione:
sendmail(usa l’MTA locale, cioè Postfix),smtp(parla direttamente con un server di posta),gotify(notifiche push) ewebhook(una richiesta HTTP con un corpo personalizzabile). - Un matcher decide quali notifiche vanno a quali target. Le regole guardano la gravità (
info,notice,warning,error), i campi dell’evento (per esempiotype=vzdump,type=fencing,type=replication,type=package-updates,hostname,job-id) e il calendario. La modalitàallrichiede che tutte le regole valgano,anyche ne basti una. - Ogni notifica viene confrontata con tutti i matcher e va ai target di tutti quelli che la accettano. Un target la riceve al massimo una volta, anche se compare in più matcher; due target diversi che consegnano alla stessa casella, invece, producono due copie (passo 6).
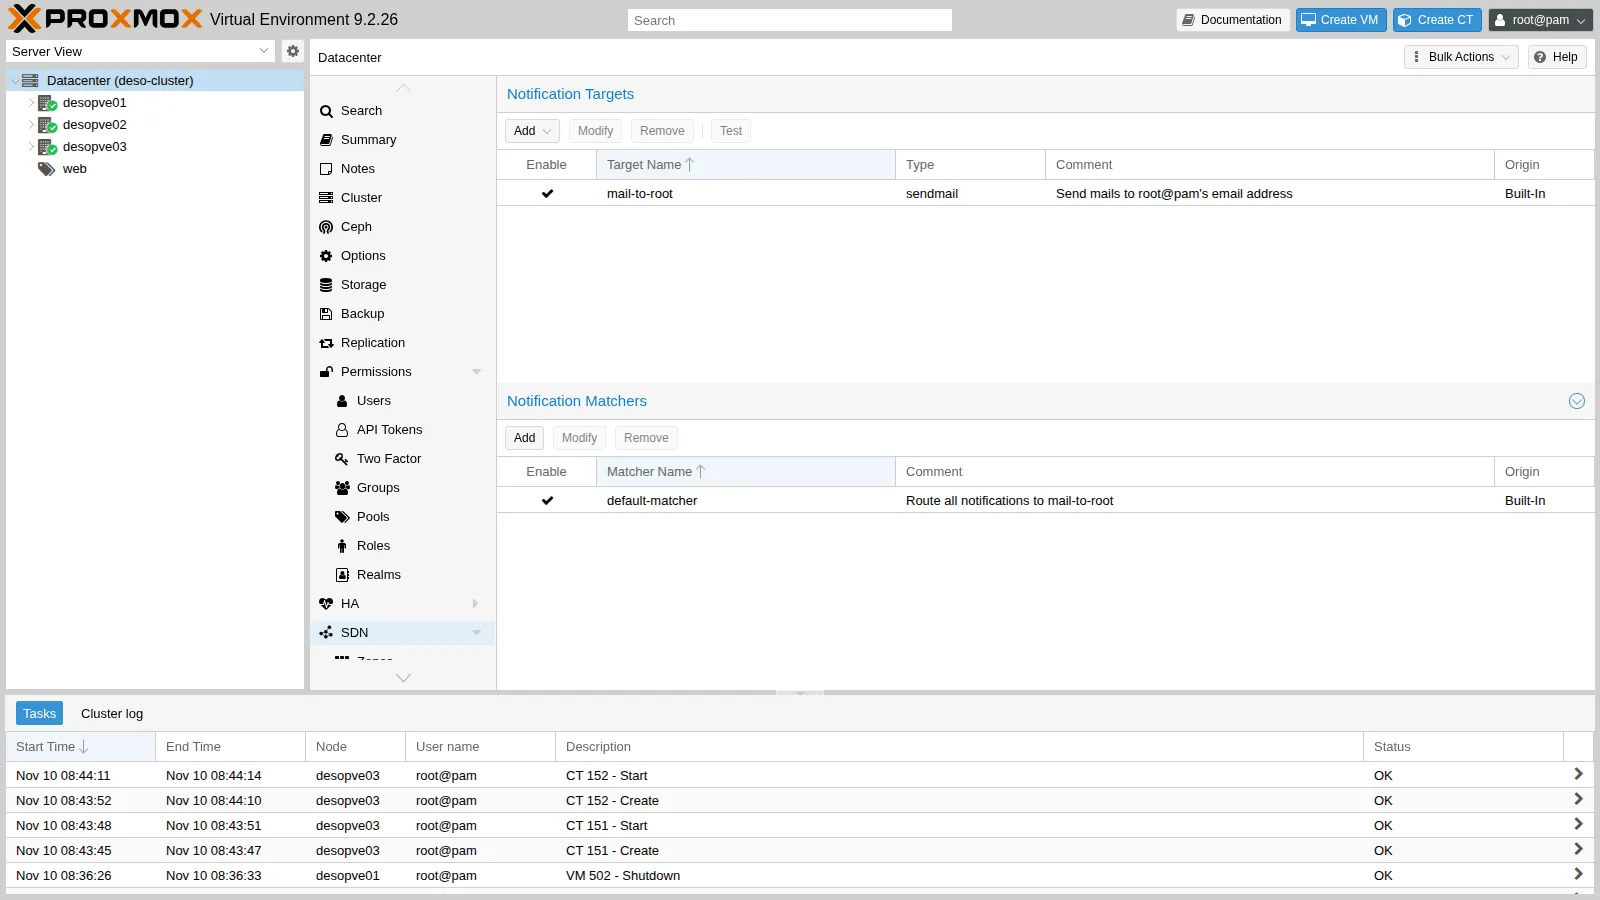
La configurazione predefinita ha un solo target, mail-to-root, che invia con sendmail all’indirizzo email di root@pam, e un matcher default-matcher che gli manda tutto. Anche la posta che i servizi locali, come smartd, mandano all’utente root entra nel sistema di notifiche, come eventi di tipo system-mail.
Metriche. Ogni nodo invia periodicamente le statistiche di nodi, guest e storage a uno o più metric server: Graphite o InfluxDB (la documentazione attuale elenca anche OpenTelemetry). Con InfluxDB 2 si usa il protocollo HTTP(S) con organizzazione, bucket e token. Proxmox VE non conserva lo storico oltre i suoi grafici RRD: per storico lungo, allarmi e dashboard si usa un database esterno come InfluxDB e uno strumento come Grafana.
Log. I servizi di Proxmox VE scrivono nel journal di systemd: pveproxy (interfaccia web e API), pvedaemon (operazioni privilegiate), pve-cluster (filesystem /etc/pve), corosync, pve-ha-crm e pve-ha-lrm (alta disponibilità), pvestatd (statistiche). Ogni operazione avviata dall’interfaccia o dall’API è un task con un identificativo (UPID) e un log proprio in /var/log/pve/tasks/. Per avere i log di tutti i nodi in un posto solo, e conservarli anche se un nodo si guasta, si inoltrano a un server centrale.
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Gli output di questo lab vengono da una prova eseguita il 10 novembre 2026, la data che compare nei log e nei task, nella configurazione descritta qui sotto. Alcuni comportamenti dipendono da versioni e impostazioni predefinite, per esempio quali target usano il proxy o il formato degli orari nei log inoltrati: su un sistema diverso vanno ricontrollati.
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve, cluster deso-cluster di tre nodi, con fuso orario Europe/Rome (Lab 03, Lab 04) |
| Posta sui nodi | Postfix come lo installa Proxmox VE, senza relayhost fino al passo 6 |
| Proxy del laboratorio | filtro su una lista di domini (Lab 01), impostato come proxy HTTP del Datacenter (Lab 04) |
| CT 151 e CT 152 | immagini OCI axllent/mailpit:latest e gotify/server:latest, scaricate il 10 novembre 2026; l’interfaccia web di Gotify mostra la versione 3.1.1, la versione di Mailpit non è stata annotata |
CT 153 monitor |
Debian 13 (template debian-13-standard_13.6-1), InfluxDB 2.9.1, Grafana 13.3.0, rsyslog 8.2504.0; fuso orario UTC alla creazione |
| Inoltro dei log | rsyslog installato sui nodi dai repository Debian, omfwd su TCP con il suo template predefinito |
Cosa mostra la prova e cosa no. Ogni percorso (email, push, metriche, log) è verificato con almeno un messaggio reale, in questa configurazione. La prova non copre la consegna con il server di posta fermo (il target SMTP non riprova), la regola di critici-push sul fencing (dopo la creazione del matcher non c’è stato nessun fencing), la coda di rsyslog durante un fermo del server centrale, il tempo che i dati impiegano ad arrivare e il comportamento sotto carico.
Procedura
Sezione intitolata “Procedura”1. Dove sono finite le notifiche?
Sezione intitolata “1. Dove sono finite le notifiche?”La configurazione predefinita, con il solo target mail-to-root:
L’indirizzo di root@pam è [email protected], impostato all’installazione nel lab 03. Le notifiche dei lab precedenti, però, nessuno le ha mai lette. La coda di Postfix su desopve01:
postqueue -p | head -8-Queue ID- --Size-- ----Arrival Time---- -Sender/Recipient-------4339E298E9* 9722 Tue Nov 10 04:37:39 [email protected]
C321B2A7B8 7395 Tue Nov 10 05:09:22 [email protected] (connect to proxmox.community[fd27:199::20]:25: Connection timed out)Sui tre nodi 31 messaggi sono in attesa nella coda, tra cui le notifiche del fencing del lab 49:
desopve01 7A1F02D550 | Subject: Trying to fence node 'desopve03'desopve01 93AAE2D572 | Subject: Successfully fenced node 'desopve03'desopve02 1EE3118167 | Subject: Replication Job: '100-1' faileddesopve01 4339E298E9 | Subject: vzdump backup status (desopve01.proxmox.community): backup successful…Perché non erano stati consegnati:
- Osservato: per il secondo messaggio Postfix registra il motivo
connect to proxmox.community[fd27:199::20]:25: Connection timed out;fd27:199::20è l’indirizzo IPv6 del domain controller (lab 25). I due messaggi mostrati sono entrati in coda alle 04:37 e alle 05:09 del 10 novembre, il giorno della prova. - Interpretazione: il comportamento è compatibile con un dominio senza record MX nel DNS del laboratorio. In quel caso un client SMTP consegna agli indirizzi del dominio stesso (l’MX implicito della RFC 5321), che qui appartengono al domain controller, su cui non gira nessun servizio di posta (lab 02). Postfix continua a riprovare un messaggio rinviato, per impostazione predefinita fino a cinque giorni (
maximal_queue_lifetime), e solo dopo lo considera non consegnabile: fino ad allora non succede niente di visibile. Un timeout, a differenza di una connessione rifiutata, non dice se sulla porta 25 non c’è nessun servizio in ascolto o se un filtro scarta la connessione. - Verifica: sul domain controller,
Resolve-DnsName proxmox.community -Type MX -DnsOnlynon dovrebbe restituire record MX, mentreResolve-DnsName proxmox.community -DnsOnlyelenca gli indirizzi che Postfix prova. Su un nodo,journalctl -t postfix/smtp | grep deferredmostra ogni tentativo fallito con il suo motivo, epostqueue -pl’ora di arrivo di ogni messaggio ancora in coda.
Una notifica che nessuno riceve è come nessuna notifica. Il primo controllo, dopo l’installazione di un cluster, è verificare che le email arrivino davvero.
2. Un server di posta di prova: Mailpit
Sezione intitolata “2. Un server di posta di prova: Mailpit”In laboratorio non serve un vero server di posta: basta un “sink” SMTP che accetta tutti i messaggi e li mostra in una pagina web. Mailpit è un’immagine OCI di 15 MB. Come nel lab 41, skopeo non usa il proxy del Datacenter, quindi lo si passa nella variabile d’ambiente:
cd /mnt/pve/cephfs/template/cacheHTTPS_PROXY=http://proxy.proxmox.community:3128 skopeo copy \  docker://docker.io/axllent/mailpit:latest oci-archive:axllent_mailpit_latest.tarHTTPS_PROXY=http://proxy.proxmox.community:3128 skopeo copy \  docker://docker.io/gotify/server:latest oci-archive:gotify_server_latest.tar
# su desopve03pct create 151 cephfs:vztmpl/axllent_mailpit_latest.tar --hostname mailpit --unprivileged 1 \ --memory 256 --rootfs rbd-vm:2 --net0 name=eth0,bridge=vmbr0,ip=172.27.199.151/24,gw=172.27.199.1pct start 151Detected OCI archiveAuto-Enabling host-managed network for network device net0.Detected container architecture: amd64Proxmox VE prende dall’immagine il processo da avviare (entrypoint: /mailpit). Mailpit riceve la posta sulla porta 1025 e mostra i messaggi su http://172.27.199.151:8025.
3. Target SMTP
Sezione intitolata “3. Target SMTP”Datacenter → Notifications → Add → SMTP: Endpoint Name mailpit, server 172.27.199.151, porta 1025, cifratura None (insecure) perché il sink non ha TLS, senza autenticazione, mittente [email protected], destinatario [email protected].
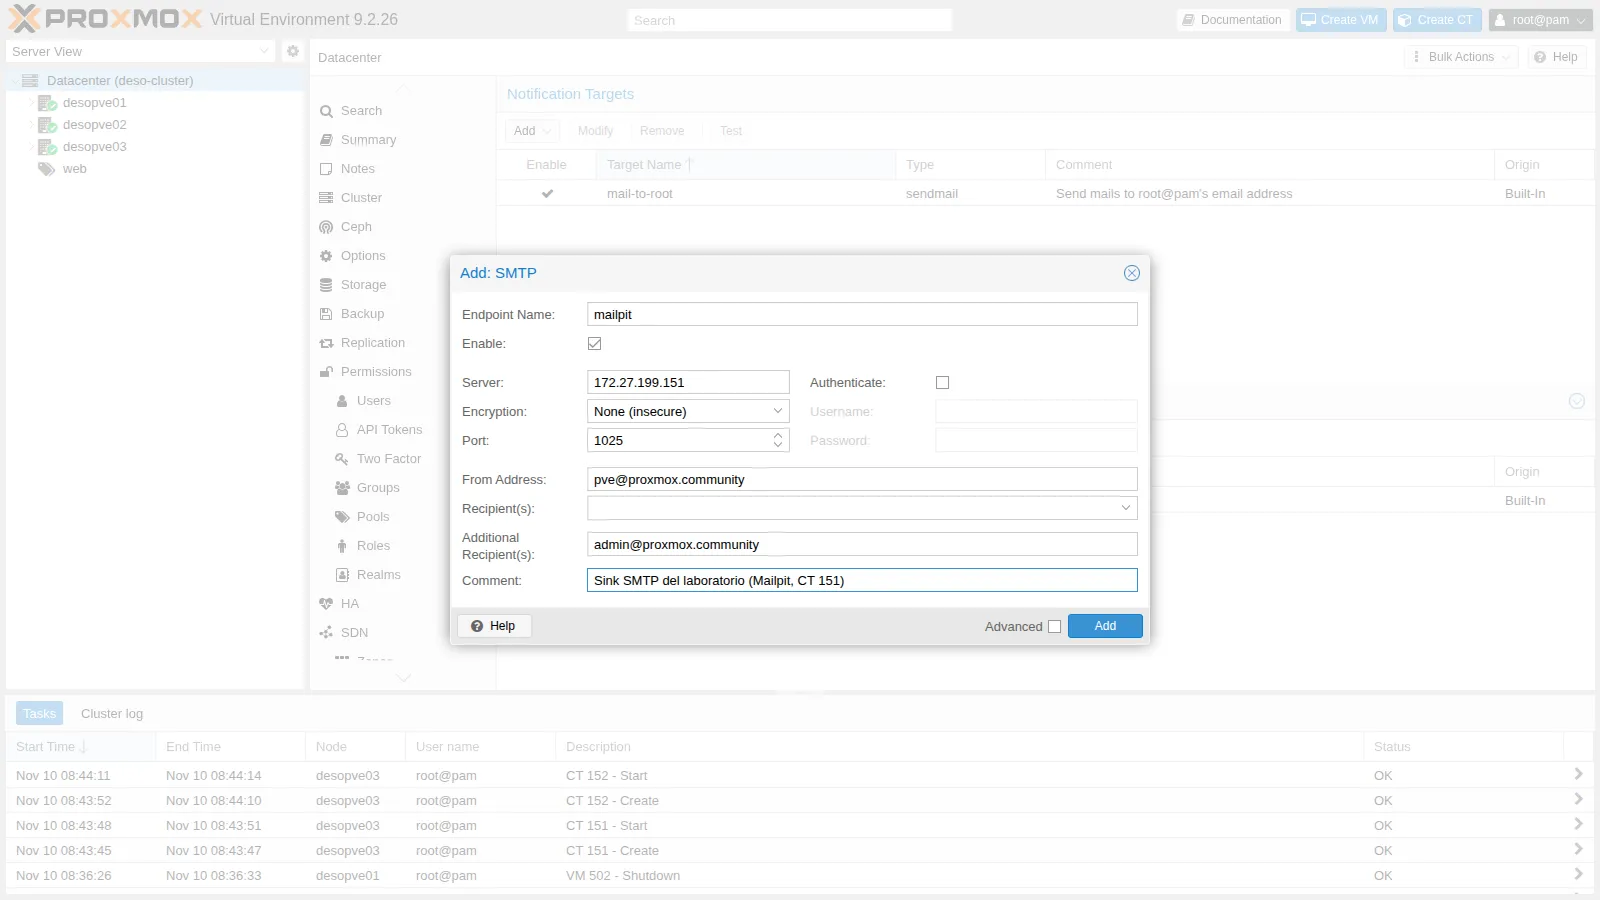
In produzione si usa il server di posta aziendale o un servizio esterno con STARTTLS o TLS e un utente dedicato. La password finisce in /etc/pve/priv/notifications.cfg, leggibile solo da root.
A differenza di sendmail, il target SMTP non passa da Postfix: Proxmox VE si collega da solo al server di posta, quindi i messaggi fermi nella coda locale non lo ostacolano. Il rovescio della medaglia, secondo la documentazione, è che il target SMTP non ha una coda e non riprova: una notifica inviata mentre il server di posta è irraggiungibile va persa. Questo lab non prova quel caso. Il pulsante Test invia un messaggio di prova, che arriva subito in Mailpit.
4. Target Gotify e una trappola: il proxy del Datacenter
Sezione intitolata “4. Target Gotify e una trappola: il proxy del Datacenter”Gotify è un server di notifiche push con un’app per smartphone. Il container 152 nasce dall’immagine scaricata al passo 2, come il 151, sullo stesso nodo desopve03:
pct create 152 cephfs:vztmpl/gotify_server_latest.tar --hostname gotify --unprivileged 1 --memory 256 \ --rootfs rbd-vm:2 --net0 name=eth0,bridge=vmbr0,ip=172.27.199.152/24,gw=172.27.199.1pct start 152Al primo avvio l’utente è admin/admin: si cambia la password e si crea un’applicazione, che fornisce il token per inviare messaggi:
curl -s -u admin:admin -X POST http://172.27.199.152/current/user/password \ -H 'Content-Type: application/json' -d '{"pass":"<password-lab>"}'curl -s -u 'admin:<password-lab>' -X POST http://172.27.199.152/application \ -H 'Content-Type: application/json' -d '{"name":"Proxmox VE","description":"Notifiche del cluster deso-cluster"}'Il token va nel target Gotify (Endpoint Name gotify):
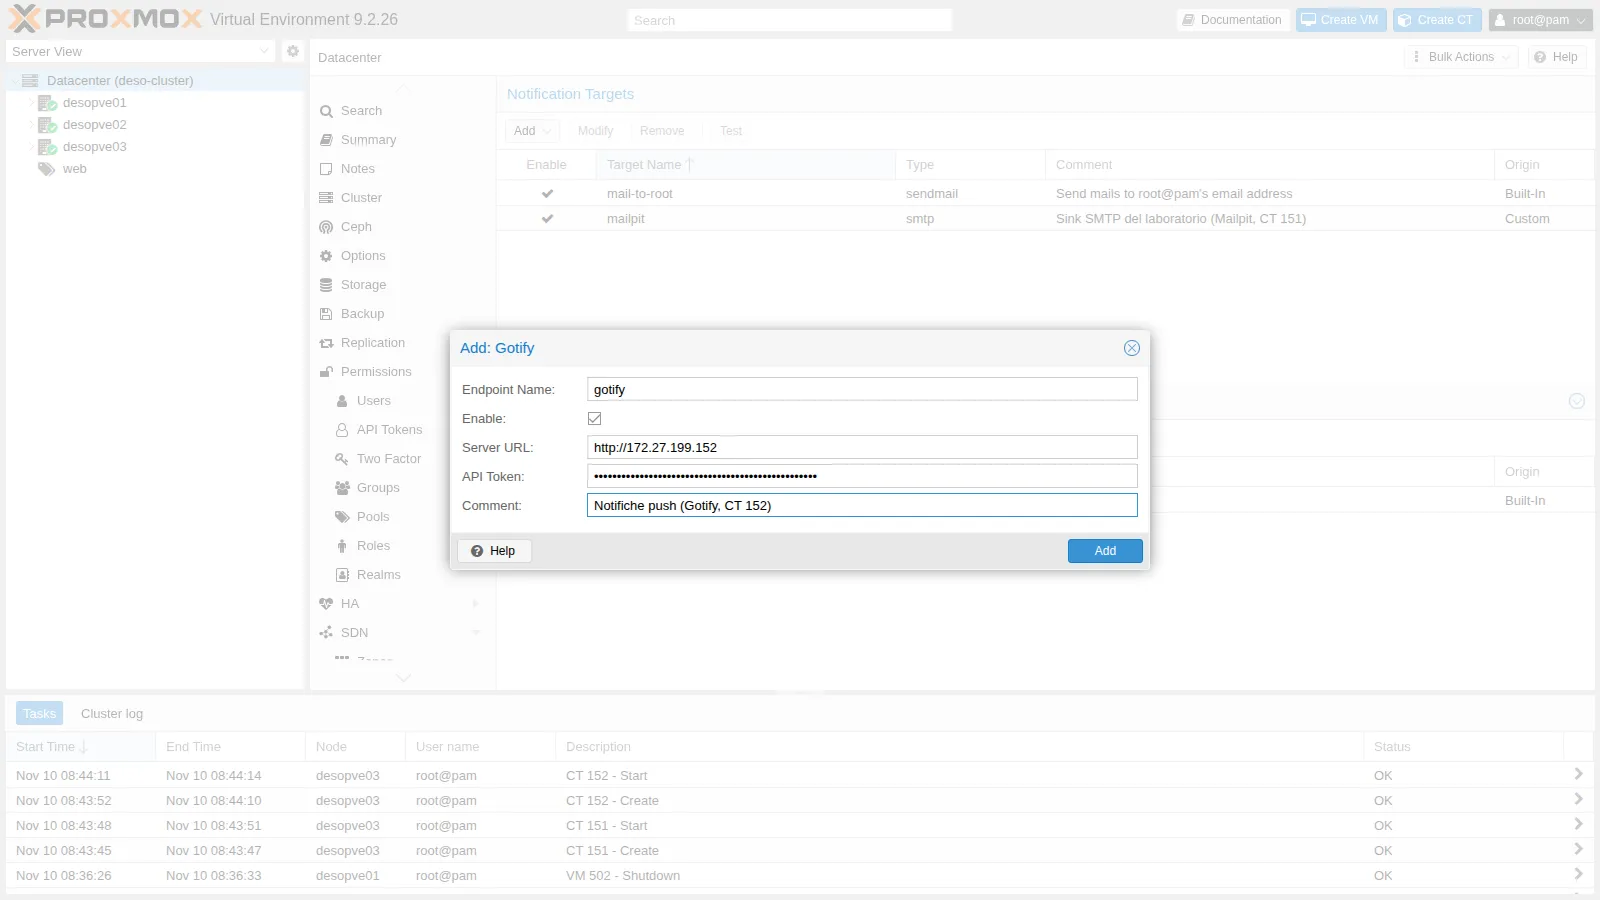
Configurazione provata. Il target Gotify punta a http://172.27.199.152, mentre il proxy HTTP del Datacenter del lab 04 è ancora impostato.
Errore osservato. Il test fallisce:
pvesh create /cluster/notifications/targets/gotify/test500 Could not test target: could not notify via endpoint(s): gotify: CONNECT proxy failed: proxy server responded 403/403Il log del proxy mostra la richiesta verso l’indirizzo interno, rifiutata dal filtro:
CONNECT Nov 10 07:49:34.599 [91799]: Request (file descriptor 5): CONNECT 172.27.199.152:80 HTTP/1.1NOTICE Nov 10 07:49:34.603 [91799]: Proxying refused on filtered domain "172.27.199.152"Il target Gotify ha quindi mandato la richiesta attraverso il proxy HTTP del Datacenter, anche se la destinazione è un indirizzo interno. La documentazione lo dice per il target Gotify. Per il target Webhook non dice niente, ma nel codice sorgente attuale anche quel target costruisce il suo client HTTP con la stessa impostazione del proxy. Questo lab ha provato solo Gotify; per verificare il target Webhook, provane uno e cerca la sua richiesta nel log del proxy.
Decisione. Il proxy del laboratorio accetta solo una lista di domini esterni: si lasciano passare anche le destinazioni interne della rete di gestione (172.27.199.0/24 e *.proxmox.community), come descritto nel lab 01. In un’azienda si chiede la stessa eccezione a chi gestisce il proxy.
Risultato. Il messaggio di prova arriva in Gotify:
Test notification | 1 | ``` This is a test of the notification target 'gotify'. ```Il target SMTP e il metric server InfluxDB del passo 7 invece non passano dal proxy: nel log del proxy non compare nessuna richiesta verso le loro porte.
5. Matcher: chi riceve cosa
Sezione intitolata “5. Matcher: chi riceve cosa”Due matcher nuovi, creati da riga di comando:
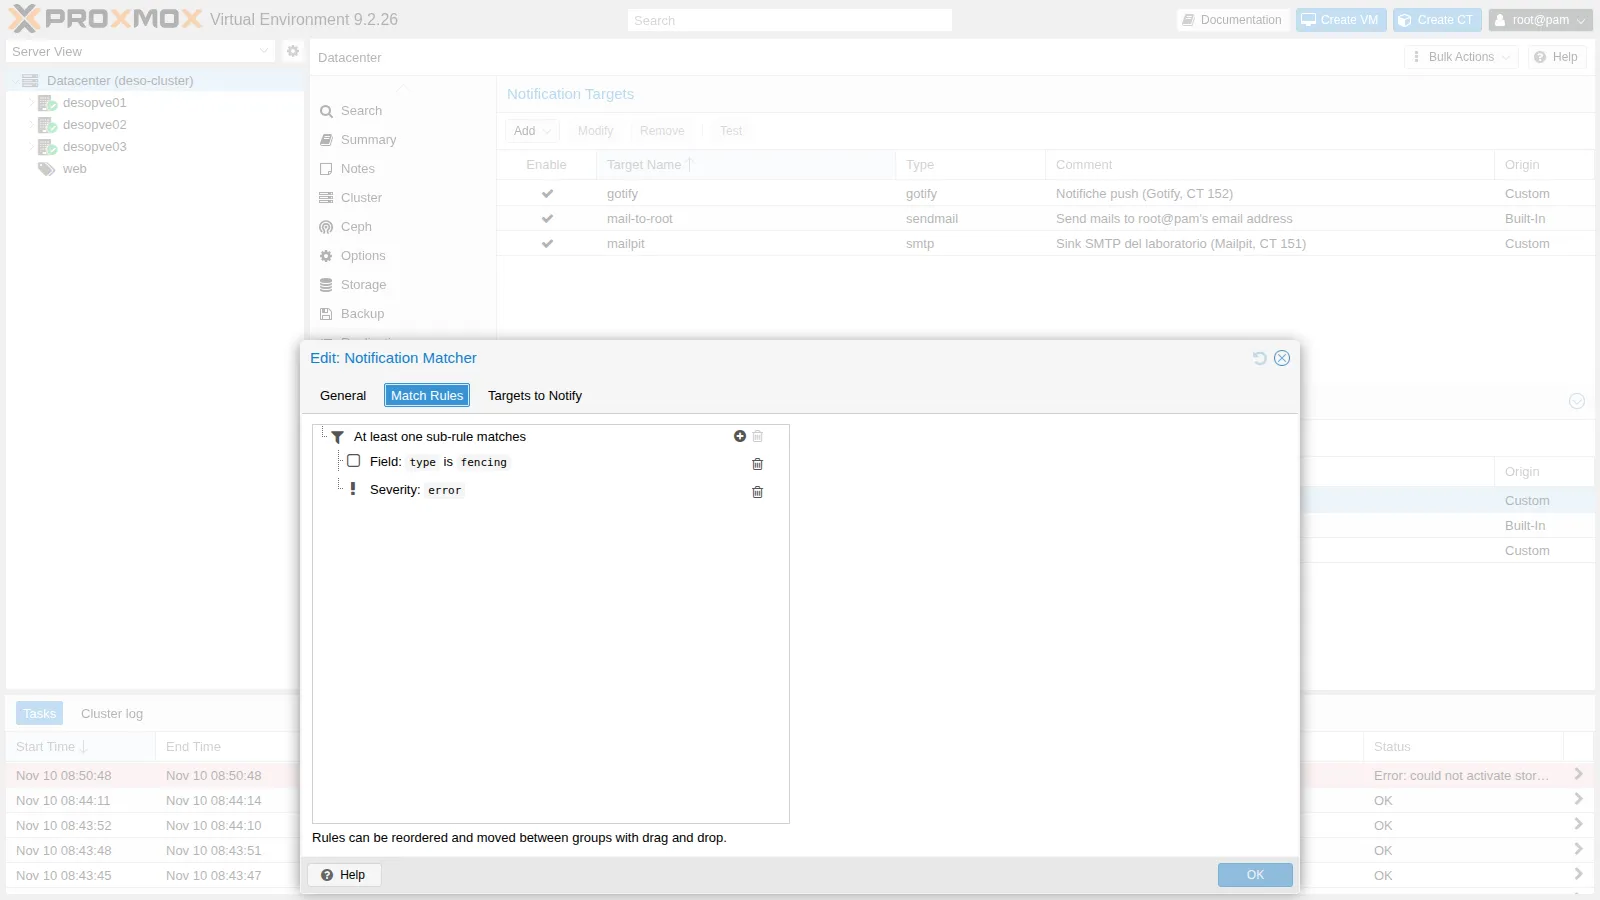
pvesh create /cluster/notifications/matchers --name tutto-a-mailpit --mode all \ --target mailpit --comment "Ogni notifica anche al sink SMTP del laboratorio"pvesh create /cluster/notifications/matchers --name critici-push --mode any \ --match-severity error --match-field exact:type=fencing \ --target gotify --comment "Errori e fencing anche su Gotify"Il risultato in /etc/pve/notifications.cfg:
matcher: tutto-a-mailpit  comment Ogni notifica anche al sink SMTP del laboratorio  mode all  target mailpit
matcher: critici-push  comment Errori e fencing anche su Gotify  match-field exact:type=fencing  match-severity error  mode any  target gotify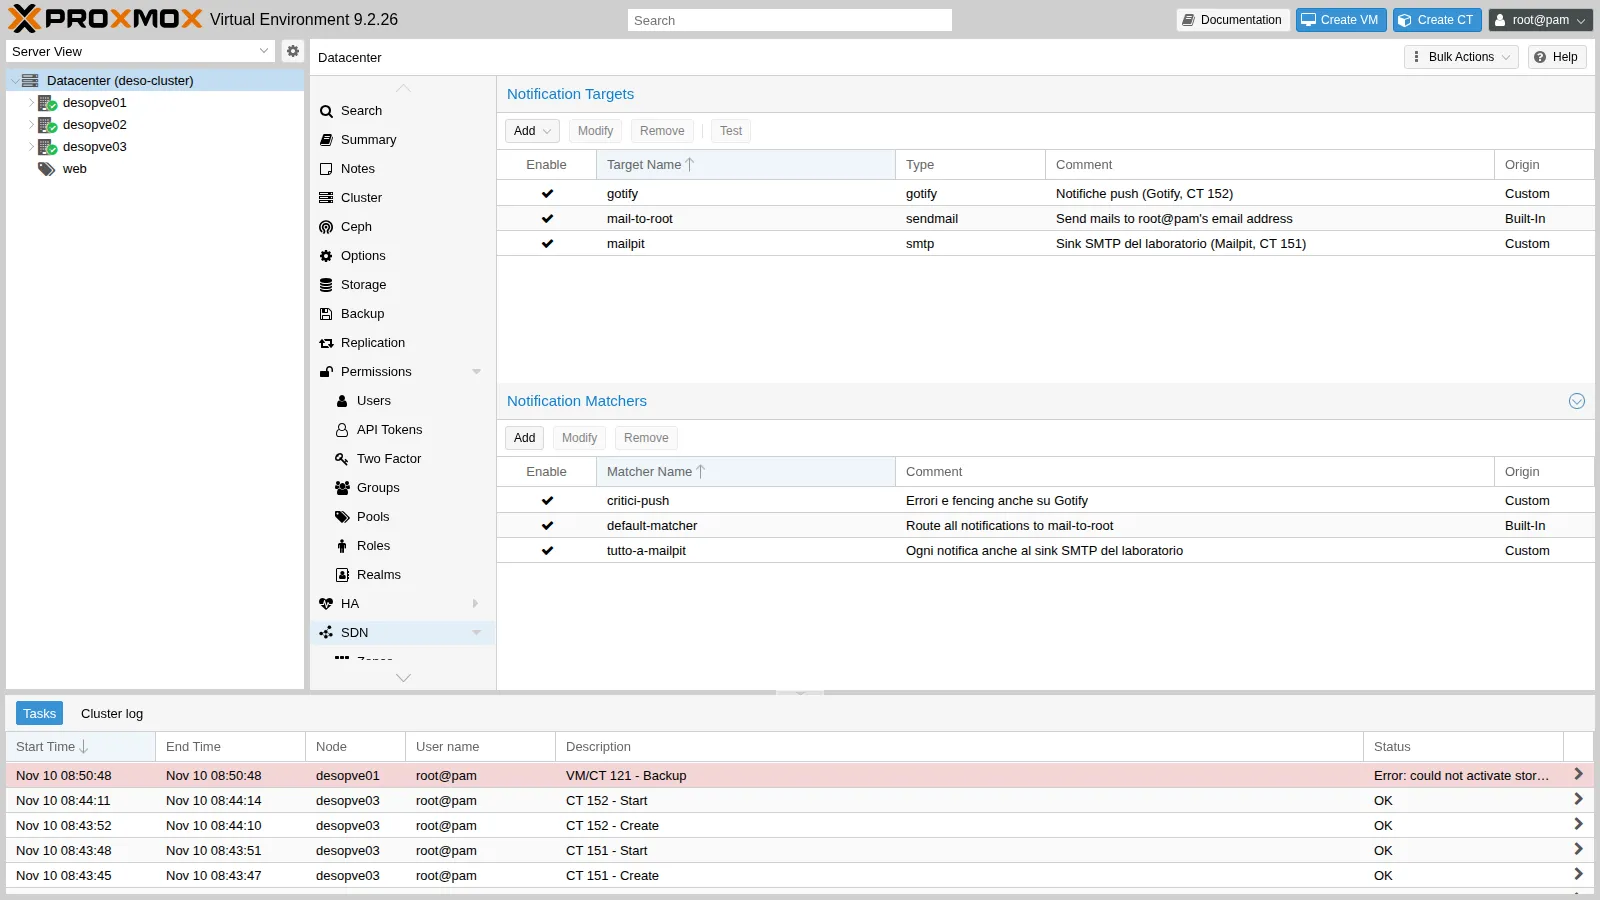
Nel matcher critici-push la modalità any lo fa scattare con un errore oppure con un fencing: la regola sul campo type cattura le notifiche di fencing qualunque sia la loro gravità, anche quella di un fencing riuscito. Dopo la creazione del matcher, nel laboratorio non c’è stato nessun fencing: la regola su type=fencing non è stata messa alla prova. Al prossimo fencing, per esempio ripetendo la prova del lab 49, i messaggi dovrebbero comparire in Gotify, e il journal di pve-ha-crm dovrebbe registrare notified via target `gotify`.
6. Sbloccare la coda di Postfix e provare un errore vero
Sezione intitolata “6. Sbloccare la coda di Postfix e provare un errore vero”Postfix serve ancora: il target sendmail (mail-to-root) gli consegna i suoi messaggi, e i servizi locali come smartd e cron mandano attraverso di lui la loro posta per root, che Proxmox VE poi inserisce nel sistema di notifiche come system-mail. Si fa consegnare Postfix al server di posta del laboratorio, su ogni nodo:
postconf -e 'relayhost = [172.27.199.151]:1025'postfix reloadpostqueue -fpostqueue -p | tail -1Mail queue is emptyLe parentesi quadre dicono a Postfix di non cercare i record MX e di usare direttamente quell’indirizzo. I 31 messaggi in attesa arrivano in Mailpit, insieme al messaggio di prova del passo 3:
totale 3228 vzdump backup status1 Replication Job: '100-1' failed1 Successfully fenced node 'desopve03'1 Trying to fence node 'desopve03'1 Test notification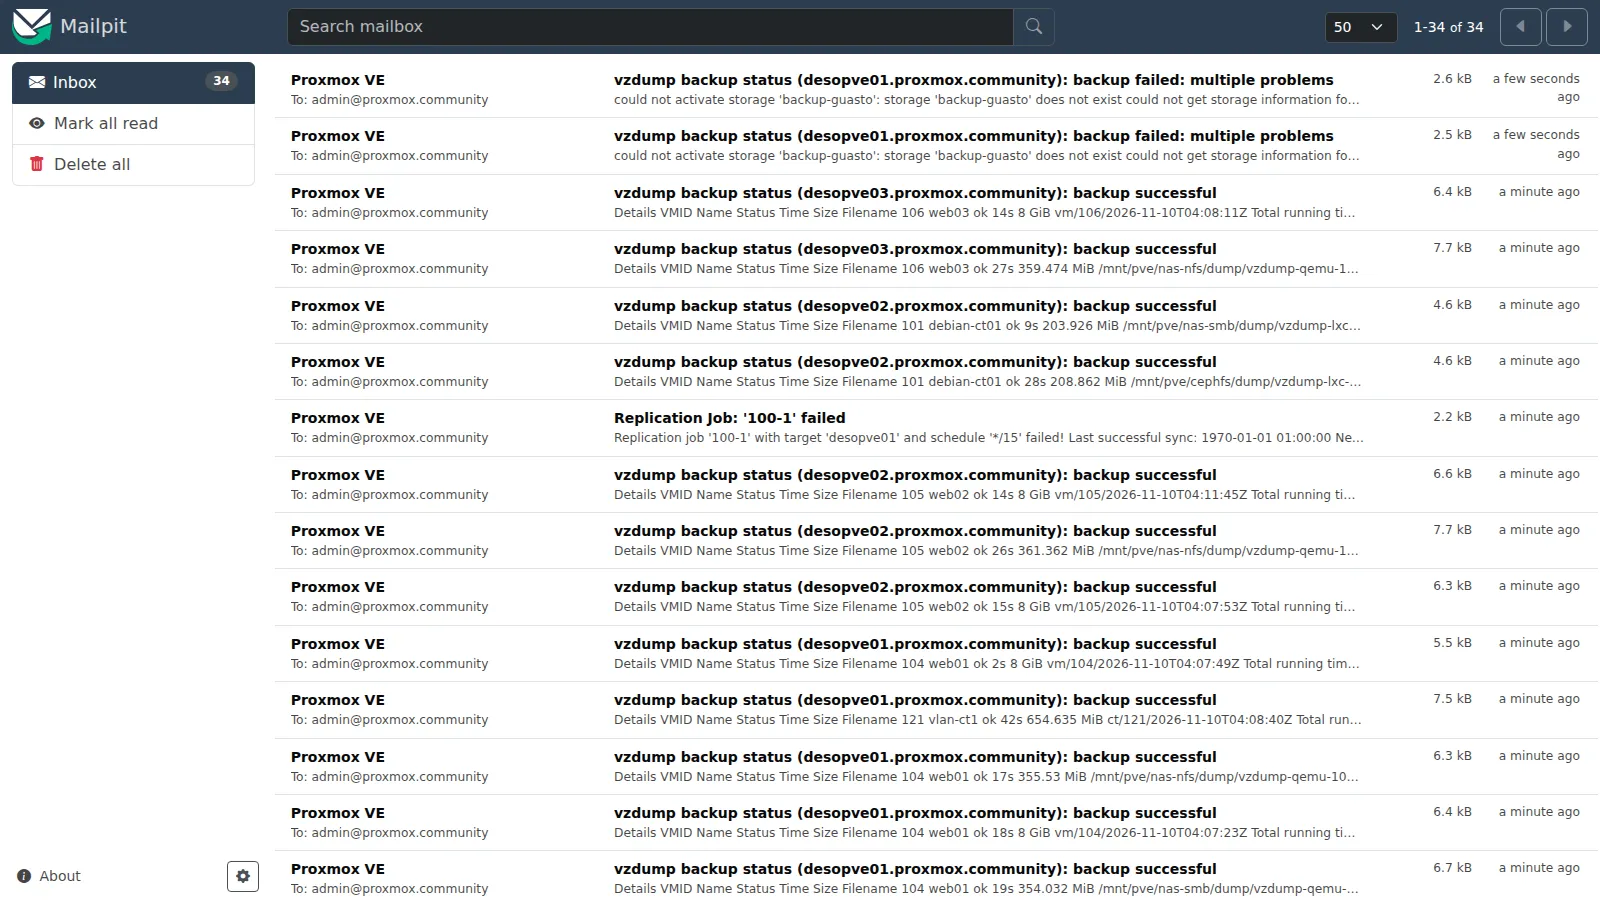
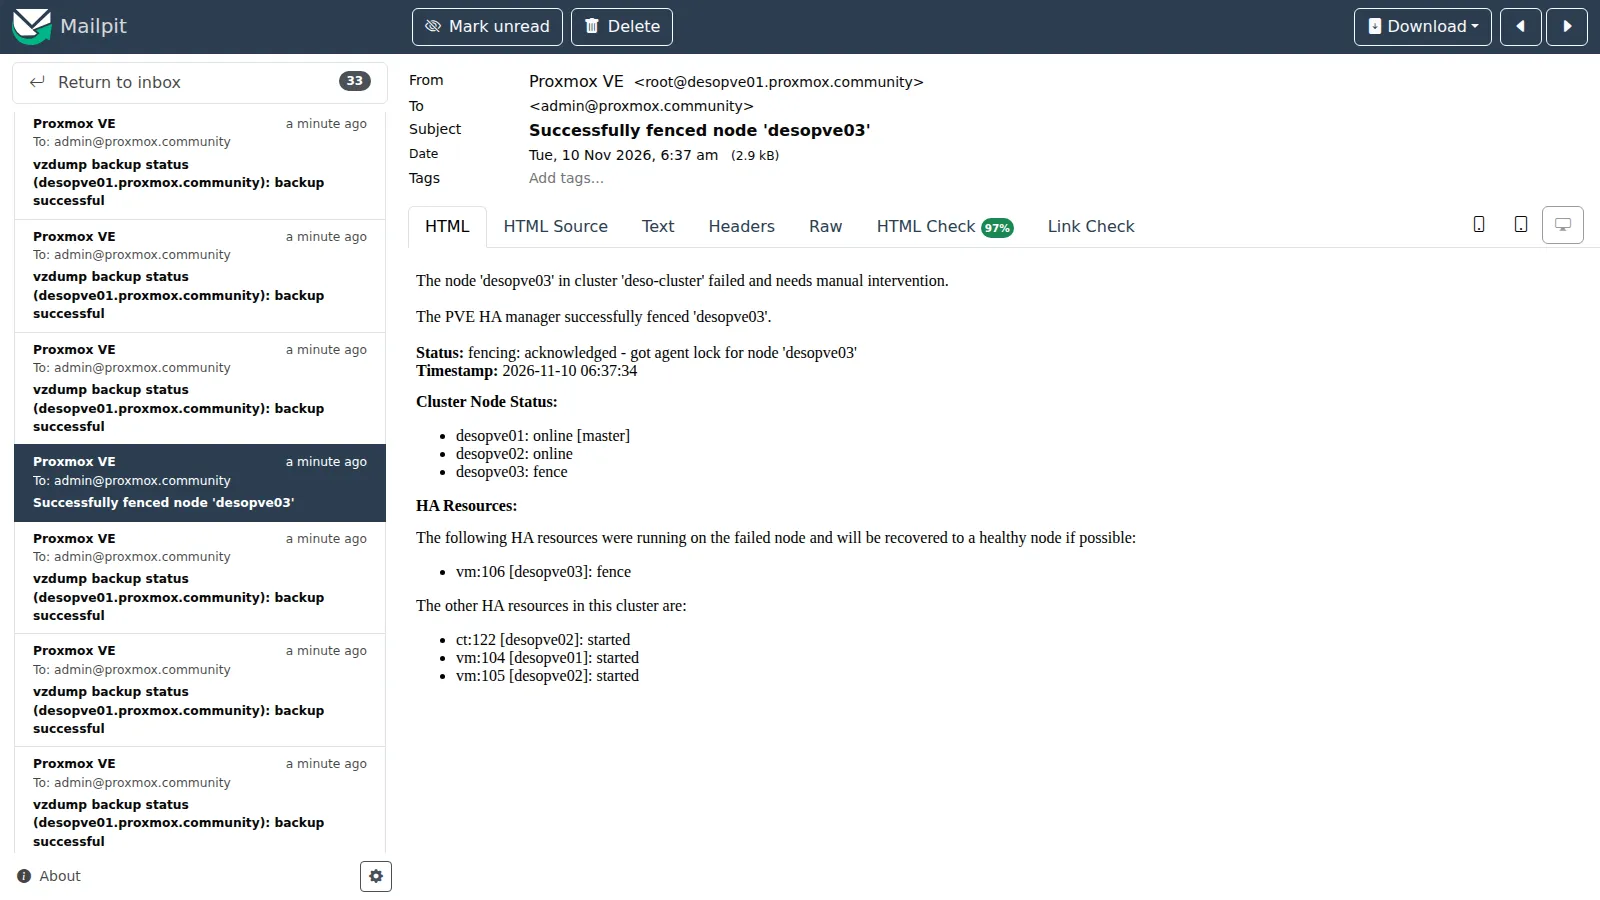
La notifica di fencing del lab 49 descrive cosa è successo e quali risorse HA sono state recuperate:
Per provare il percorso degli errori serve un errore vero. Un backup verso uno storage che non esiste:
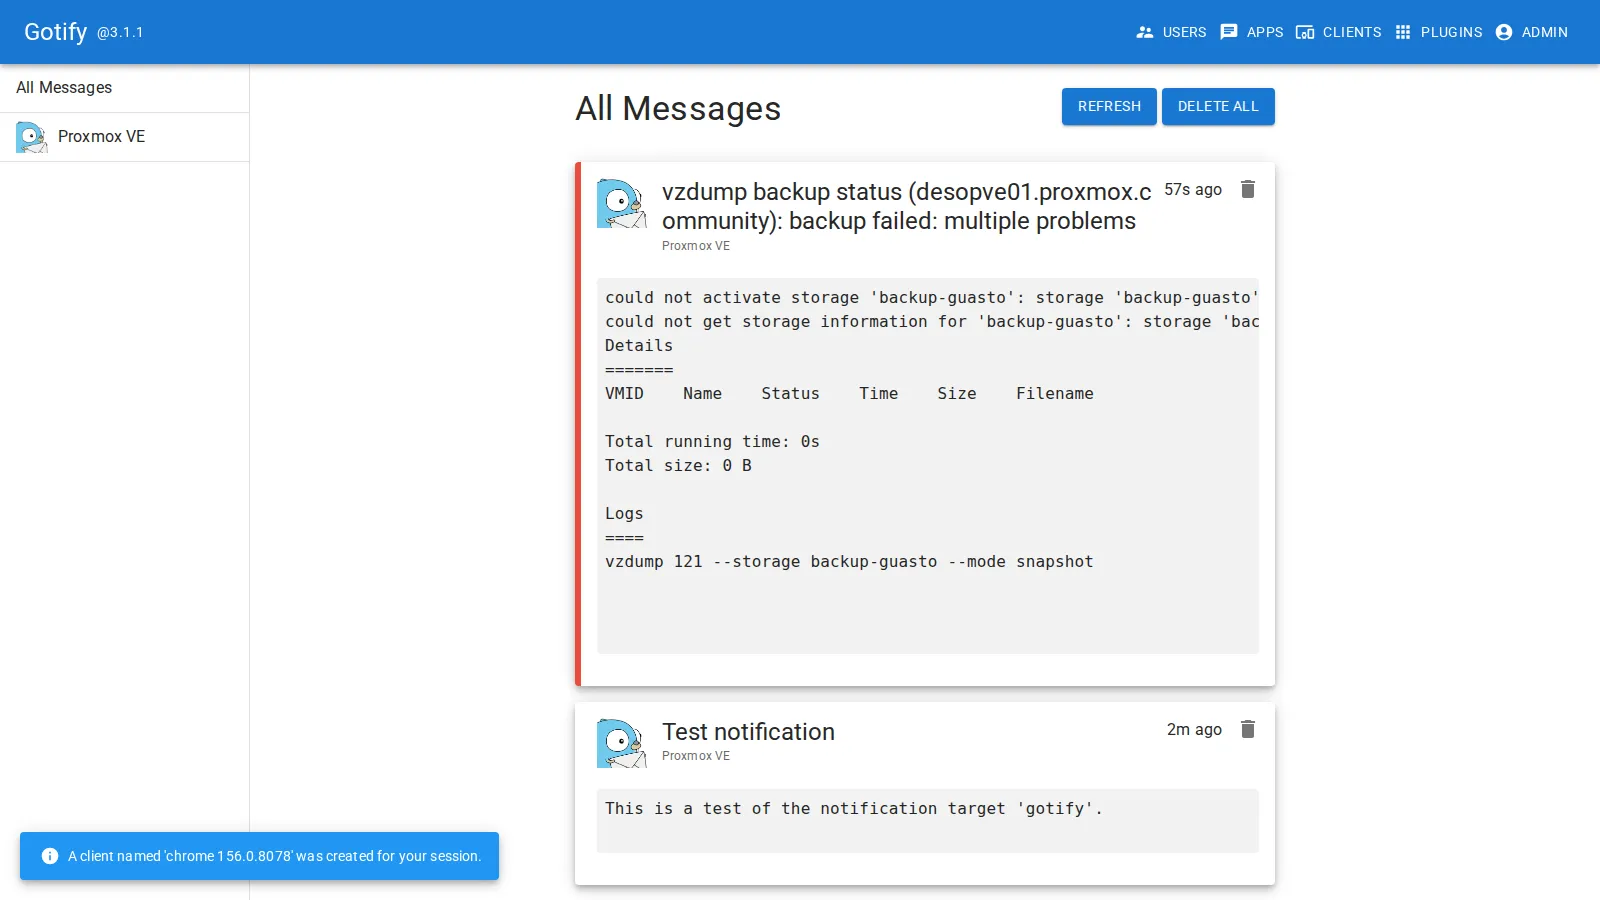
vzdump 121 --storage backup-guasto --mode snapshotINFO: notified via target `mail-to-root`INFO: notified via target `mailpit`INFO: notified via target `gotify`could not activate storage 'backup-guasto': storage 'backup-guasto' does not exist could not get storage information for 'backup-guasto': storage 'backup-guasto' does not existIl log del task nomina tre target, e in Mailpit la notifica arriva due volte. È coerente con i due percorsi che ora finiscono in Mailpit: mail-to-root attraverso Postfix e il suo relayhost, e il target SMTP direttamente. Per verificarlo, confronta le intestazioni delle due copie: solo quella passata da Postfix ha un’intestazione Received aggiunta dal Postfix del nodo. In Gotify il messaggio ha priorità 9. Il target Gotify ricava la priorità dalla gravità: nel codice sorgente della libreria delle notifiche, error diventa 9, il valore più alto che usa (warning 5, notice 3, info 1):
7. Metriche: InfluxDB 2 e Grafana
Sezione intitolata “7. Metriche: InfluxDB 2 e Grafana”Un container Debian 13 dedicato, il CT 153 monitor, con InfluxDB 2, Grafana e rsyslog dai repository ufficiali (via proxy):
# su desopve03pct create 153 cephfs:vztmpl/debian-13-standard_13.6-1_amd64.tar.zst --hostname monitor \ --unprivileged 1 --features nesting=1 --cores 2 --memory 2048 --swap 512 --rootfs rbd-vm:10 \ --net0 name=eth0,bridge=vmbr0,ip=172.27.199.153/24,gw=172.27.199.1 \ --nameserver 172.27.199.20 --searchdomain proxmox.community --password '<password-lab>'pct start 153pct enter 153Dentro il container:
echo 'Acquire::http::Proxy "http://proxy.proxmox.community:3128";' > /etc/apt/apt.conf.d/80proxyexport https_proxy=http://proxy.proxmox.community:3128apt-get update && apt-get install -y curl gpginstall -d -m 0755 /etc/apt/keyringscurl -fsSL https://repos.influxdata.com/influxdata-archive.key | gpg --dearmor -o /etc/apt/keyrings/influxdata.gpgcurl -fsSL https://apt.grafana.com/gpg.key | gpg --dearmor -o /etc/apt/keyrings/grafana.gpgecho "deb [signed-by=/etc/apt/keyrings/influxdata.gpg] https://repos.influxdata.com/debian stable main" > /etc/apt/sources.list.d/influxdata.listecho "deb [signed-by=/etc/apt/keyrings/grafana.gpg] https://apt.grafana.com stable main" > /etc/apt/sources.list.d/grafana.listapt-get update && apt-get install -y influxdb2 influxdb2-cli grafana rsyslogsystemctl enable --now influxdb grafana-servergrafana 13.3.0influxdb2 2.9.1-1rsyslog 8.2504.0-1+deb13u2Configurazione iniziale di InfluxDB: organizzazione proxmox, bucket pve con 30 giorni di conservazione, e due token separati, uno che può solo scrivere (per Proxmox VE) e uno che può solo leggere (per Grafana):
influx setup --org proxmox --bucket pve --username admin --password '<password-lab>' --retention 30d --forceBID=$(influx bucket list --org proxmox --name pve --hide-headers | cut -f1)influx auth create --org proxmox --write-bucket $BID --description pve-scritturainflux auth create --org proxmox --read-bucket $BID --description grafana-letturaIn Proxmox VE: Datacenter → Metric Server → Add → InfluxDB, ID influx-monitor, protocollo HTTP, server 172.27.199.153, porta 8086, organizzazione proxmox, bucket pve, token di scrittura.
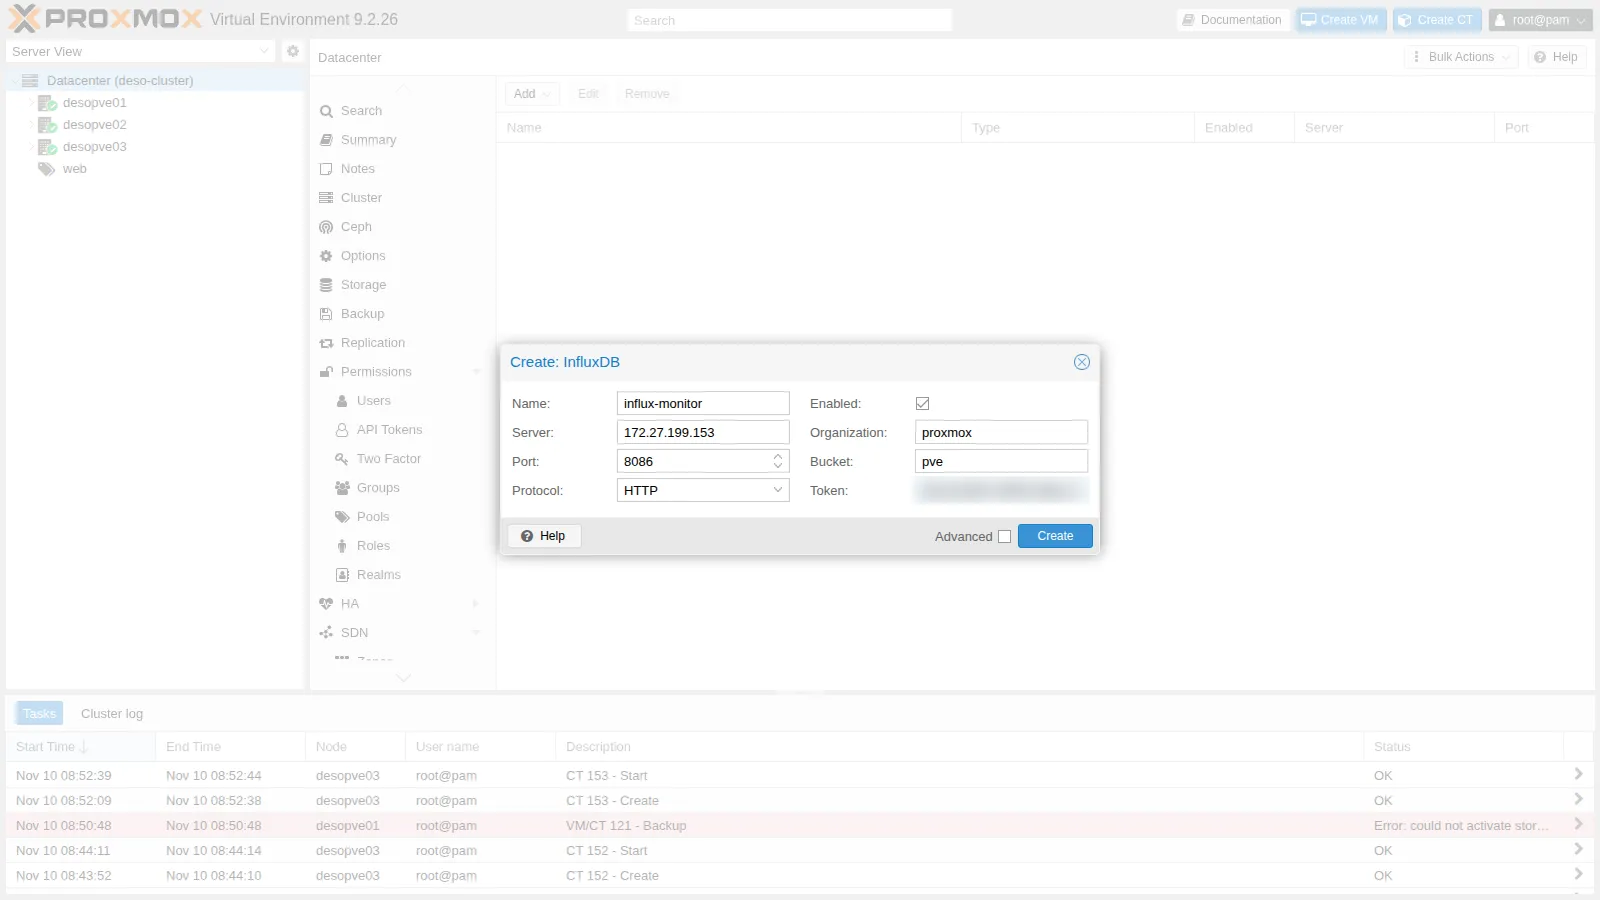
La configurazione finisce in /etc/pve/status.cfg, valida per tutti i nodi:
influxdb: influx-monitor port 8086 server 172.27.199.153 bucket pve influxdbproto http organization proxmoxDopo pochi secondi arrivano i dati. Le misure presenti nel bucket e l’ultimo valore di CPU di due nodi:
ballooninfo blockstat cpustat memory nics proxmox-support system host:string _value:float---------------------- ---------------------------- desopve02 0.146134663341646 desopve03 0.2536In Grafana (http://172.27.199.153:3000) si aggiunge una data source di tipo InfluxDB con linguaggio Flux, organizzazione proxmox, bucket pve e il token di sola lettura. La verifica risponde datasource is working. 1 buckets found. Poi si importa la dashboard pubblica “Proxmox Cluster [Flux]” (ID 15356 su grafana.com). L’import per ID lo scarica il servizio grafana-server, non il browser, e in questo laboratorio il servizio non ha un proxy: la variabile https_proxy esportata prima vale solo per quella shell. Si scarica quindi il JSON dal container, attraverso il proxy (che deve ammettere il dominio grafana.com), e lo si carica con Dashboards → New → Import → Upload dashboard JSON file, associandolo a questa data source:
curl -x http://proxy.proxmox.community:3128 -fsS -o /root/proxmox-flux.json \ https://grafana.com/api/dashboards/15356/revisions/latest/download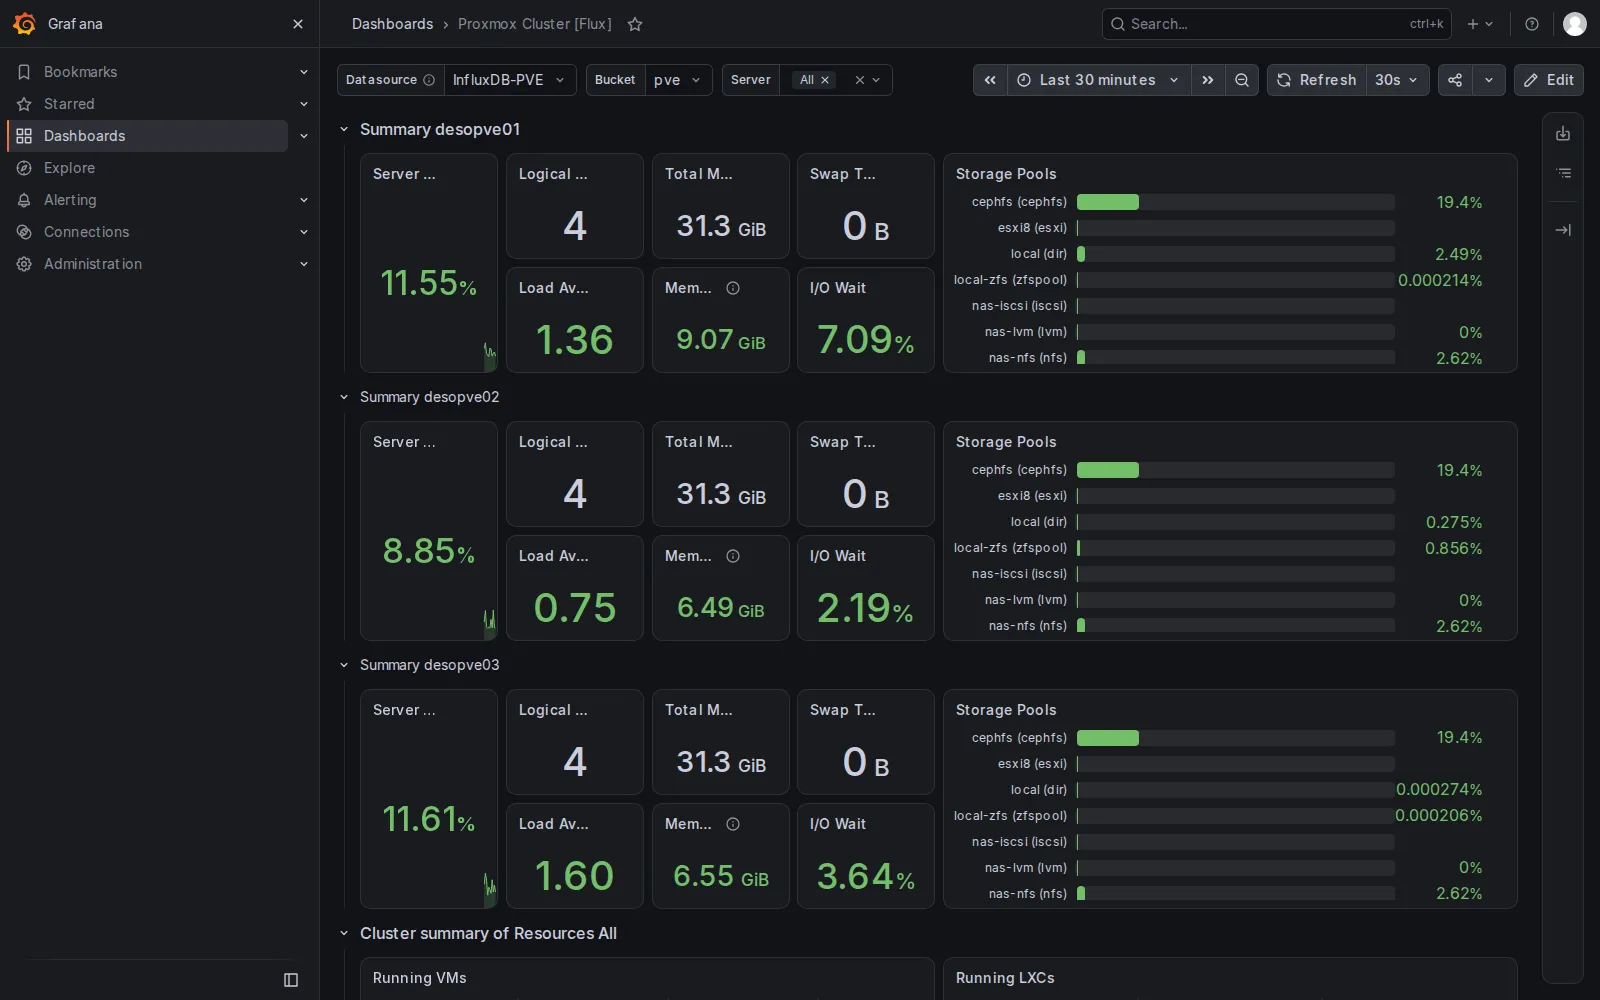
Se hai svolto il lab 50, nell’elenco degli storage compare anche lo storage di import, che non ha spazio proprio.
8. Log: journal, task e inoltro centralizzato
Sezione intitolata “8. Log: journal, task e inoltro centralizzato”Il journal conserva la storia dei servizi. Il fencing del lab 49, visto dal gestore HA su desopve01:
journalctl -u pve-ha-crm --since "2026-11-10 06:35" --until "2026-11-10 06:40" -o short-iso | grep -iE "fenc|recover|node .desopve03"2026-11-10T06:35:54+01:00 desopve01 pve-ha-crm[1679]: node 'desopve03': state changed from 'online' => 'unknown'2026-11-10T06:36:44+01:00 desopve01 pve-ha-crm[1679]: service 'vm:106': state changed from 'started' to 'fence'2026-11-10T06:36:44+01:00 desopve01 pve-ha-crm[1679]: node 'desopve03': state changed from 'unknown' => 'fence'2026-11-10T06:37:44+01:00 desopve01 pve-ha-crm[1679]: fencing: acknowledged - got agent lock for node 'desopve03'2026-11-10T06:37:44+01:00 desopve01 pve-ha-crm[1679]: recover service 'vm:106' from fenced node 'desopve03' to node 'desopve02'Corosync, sullo stesso nodo, aveva registrato la perdita di entrambi i link verso l’host 3, cioè desopve03, 16 secondi prima:
2026-11-10T06:35:38+01:00 desopve01 corosync[120106]: [KNET ] link: host: 3 link: 0 is down2026-11-10T06:35:38+01:00 desopve01 corosync[120106]: [KNET ] link: host: 3 link: 1 is down2026-11-10T06:35:38+01:00 desopve01 corosync[120106]: [KNET ] host: host: 3 has no active linksI due servizi registrano eventi diversi: Corosync la perdita dei link, il gestore HA il cambio di stato, il fencing e il recupero. Il lab 49 discute i tempi tra un evento e l’altro.
I task del nodo, con il backup fallito del passo 6:
pvenode task list --limit 4tail -n 1 /var/log/pve/tasks/index│ UPID:desopve01:000AED42:0064A85D:6AF2CCD8:vzdump:121:root@pam: │ vzdump │ 121 │ root@pam │ 2026-11-10 08:50:48 │ 2026-11-10 08:50:48 │ ERROR │UPID:desopve01:000AED42:0064A85D:6AF2CCD8:vzdump:121:root@pam: 6AF2CCD8 could not activate storage 'backup-guasto': storage 'backup-guasto' does not exist …Il server centrale è rsyslog nel CT 153, che riceve su TCP 514 e scrive un file per nodo e per programma:
# /etc/rsyslog.d/10-ricezione.conf (CT 153)module(load="imtcp")input(type="imtcp" port="514" ruleset="remoti")template(name="PerHost" type="string" string="/var/log/remote/%HOSTNAME%/%PROGRAMNAME%.log")ruleset(name="remoti") { action(type="omfile" dynaFile="PerHost" createDirs="on")}I nodi Proxmox VE 9 usano solo il journal: rsyslog va installato. Su ogni nodo:
apt-get install -y rsyslogcat > /etc/rsyslog.d/90-remoto.conf <<'EOF'*.* action(type="omfwd" target="172.27.199.153" port="514" protocol="tcp" queue.type="LinkedList" queue.filename="inoltro-remoto" queue.saveOnShutdown="on" action.resumeRetryCount="-1")EOFsystemctl restart rsysloglogger -t lab51 "prova di inoltro da $(hostname)"Con queue.filename la coda di inoltro diventa disk-assisted: finché il server centrale è irraggiungibile, rsyslog conserva i messaggi e riprova senza limiti (action.resumeRetryCount="-1"). Secondo la documentazione di rsyslog, però, i messaggi restano in memoria e vanno su disco solo quando la coda in memoria si riempie o a uno spegnimento ordinato (queue.saveOnShutdown): un crash o una mancanza di corrente del nodo perde quello che era ancora in memoria. Questo lab non ha provato un fermo del server centrale. Per verificarlo, ferma rsyslog sul CT 153, manda qualche messaggio con logger da un nodo, riavvia rsyslog e cerca i messaggi in /var/log/remote/.
Sul CT 153 arrivano le prove e, riavviando il CT 101 su desopve02, anche i task reali:
2026-11-10T08:57:33+00:00 desopve01 lab51: prova di inoltro da desopve012026-11-10T08:57:40+00:00 desopve02 lab51: prova di inoltro da desopve022026-11-10T08:57:48+00:00 desopve03 lab51: prova di inoltro da desopve032026-11-10T08:58:03+00:00 desopve02 pct[632504]: <root@pam> end task UPID:desopve02:0009A6B9:0053EFD3:6AF2CE89:vzstop:101:root@pam: OK2026-11-10T08:58:07+00:00 desopve02 pct[632503]: <root@pam> end task UPID:desopve02:0009A6D8:0053F113:6AF2CE8C:vzstart:101:root@pam: OKConfigurazione provata. I nodi inoltrano con omfwd e il suo template predefinito; il CT 153 mantiene il fuso orario con cui è nato, UTC.
Comportamento osservato. Sul CT 153 le righe hanno lo scostamento +00:00, mentre il journal dei nodi mostra +01:00. L’UPID di ogni task contiene in esadecimale l’ora di inizio (date -u -d @$((16#6AF2CE89)) la decodifica): vzstop inizia alle 07:58:01 UTC, il vzstart successivo alle 07:58:04 UTC. Il CT 153 registra la fine di vzstop alle 08:58:03+00:00. Letto come UTC, l’arresto sarebbe durato un’ora e sarebbe finito dopo l’inizio del task successivo; letto con lo scostamento dei nodi, finisce alle 07:58:03 UTC, due secondi dopo l’inizio. Gli orari del CT 153 sono quindi l’ora locale dei nodi, etichettata come UTC.
Interpretazione. È compatibile con i nodi che inviano la loro ora locale senza fuso orario, e con il CT 153 che le attribuisce il proprio, UTC. Il template predefinito di omfwd, RSYSLOG_TraditionalForwardFormat, usa l’orario tradizionale, che non porta né il fuso né le frazioni di secondo, proprio come le righe ricevute. Per verificarlo, manda un messaggio con logger da un nodo e confronta la riga ricevuta con date -u sul nodo, oppure guarda i messaggi inoltrati con tcpdump -A -i vmbr0 tcp port 514 sul nodo.
Decisione. Portare il CT 153 sul fuso orario dei nodi con timedatectl set-timezone Europe/Rome.
Risultato. Gli orari coincidono con quelli dei nodi. Funziona perché nodi e server hanno lo stesso fuso. Un formato di inoltro che porta con sé lo scostamento, come RSYSLOG_ForwardFormat (template="RSYSLOG_ForwardFormat" nell’azione omfwd), renderebbe gli orari indipendenti dal fuso del server; nel laboratorio non è stato provato.
9. Firewall per i servizi nuovi
Sezione intitolata “9. Firewall per i servizi nuovi”Nella configurazione del lab 33 il firewall degli host dei nodi non ha regole in uscita e mantiene la politica di uscita predefinita, ACCEPT: metriche, log e notifiche escono dai nodi come connessioni in uscita, e non ne sono toccate. Il container monitor, invece, espone tre servizi e va protetto. Un IPSet con i nodi e le regole del container:
pvesh create /cluster/firewall/ipset --name nodi-pve --comment "Nodi Proxmox VE del laboratorio"for i in 21 22 23 24; do pvesh create /cluster/firewall/ipset/nodi-pve --cidr 172.27.199.$i; doneCrea /etc/pve/firewall/153.fw con questo contenuto (oppure le stesse regole da CT 153 → Firewall):
# /etc/pve/firewall/153.fw[OPTIONS]enable: 1policy_in: DROP
[RULES]IN ACCEPT -source +nodi-pve -p tcp -dport 8086 -log nolog # metriche dai nodi verso InfluxDBIN ACCEPT -source +nodi-pve -p tcp -dport 514 -log nolog # log dei nodi verso rsyslogIN ACCEPT -source +management -p tcp -dport 3000 -log nolog # Grafana dalla rete di gestioneIN SSH(ACCEPT) -source +management -log nologIN Ping(ACCEPT) -log nolog
Infine firewall=1 sulla scheda del container (pct set 153 --net0 …,firewall=1).
Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se ogni percorso consegna almeno un messaggio reale: una notifica in Mailpit e in Gotify, dati nel bucket InfluxDB e in Grafana, una riga da ogni nodo in /var/log/remote/ sul CT 153. Il firewall del CT 153 deve poi bloccare una connessione da un guest che non è un nodo, senza fermare metriche e log.
| Prova | Criterio di successo | Osservato nel laboratorio |
|---|---|---|
Coda di Postfix prima del passo 6 (postqueue -p su ogni nodo) |
diagnosi: ci sono notifiche mai consegnate? | 31 notifiche in attesa, fencing compreso |
| Test del target SMTP | messaggio in Mailpit | messaggio in Mailpit |
| Test del target Gotify con il proxy che filtra | diagnosi: il log del proxy mostra la richiesta rifiutata | errore CONNECT proxy failed: 403; nel log del proxy, Proxying refused on filtered domain |
| Test del target Gotify dopo l’eccezione sul proxy | messaggio in Gotify | messaggio in Gotify |
postqueue -f con relayhost verso Mailpit |
coda vuota su ogni nodo | coda vuota, 31 messaggi consegnati |
Backup fallito (vzdump verso uno storage inesistente) |
una notifica su ogni target, gravità error |
tre target, due copie in Mailpit, priorità 9 in Gotify |
| Metriche in InfluxDB | le misure inviate dai nodi nel bucket pve |
misure system, cpustat, memory, nics, blockstat, ballooninfo, proxmox-support |
| Grafana | data source verificata, dashboard con i tre nodi | datasource is working. 1 buckets found; dashboard con i dati dei tre nodi |
logger sui nodi e riavvio del CT 101 |
un file per nodo e per programma in /var/log/remote/<nodo>/, orari coerenti con quelli dei nodi |
righe da tutti e tre i nodi; orari allineati dopo aver impostato il fuso del CT 153 |
| Porta 8086 dal CT 101 (non è un nodo), con il firewall del CT 153 | bloccata | bloccata |
Porta 8086 da desopve01, Grafana dalla rete di gestione, log dopo il firewall |
consentiti | consentiti |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Notifiche (
/etc/pve/notifications.cfg):- target
mail-to-root(sendmail, predefinito),mailpit(SMTP verso 172.27.199.151:1025) egotify(http://172.27.199.152, token in/etc/pve/priv/notifications.cfg); - matcher
default-matcher(tutto amail-to-root),tutto-a-mailpit(tutto amailpit),critici-push(errori o fencing agotify).
- target
- Postfix sui nodi 01-03:
relayhost = [172.27.199.151]:1025, coda vuota. - Proxy del laboratorio: ammesse anche le destinazioni interne
172.27.199.0/24e*.proxmox.community. - CT 151
mailpitsudesopve03, acceso (immagine OCI, 172.27.199.151, SMTP 1025, web 8025). I messaggi stanno in memoria: si perdono al riavvio del container. - CT 152
gotifysudesopve03, acceso (immagine OCI, 172.27.199.152, utenteadmin, applicazione “Proxmox VE”). - CT 153
monitorsudesopve03, acceso (Debian 13, 172.27.199.153, fuso orarioEurope/Rome): InfluxDB 2.9 (organizzazioneproxmox, bucketpve, 30 giorni, tokenpve-scritturaegrafana-lettura), Grafana 13.3 (admin, dashboard “Proxmox Cluster [Flux]”), rsyslog in ascolto su TCP 514; firewall attivo con le regole del passo 9. - Metric server
influx-monitornel Datacenter. - rsyslog installato sui nodi 01-03 con
/etc/rsyslog.d/90-remoto.conf. - IPSet
nodi-pve(172.27.199.21-24) nel firewall del Datacenter. - I template OCI
axllent_mailpit_latest.taregotify_server_latest.tarrestano sucephfs.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Verificare che le notifiche escano davvero dal cluster. Con la configurazione predefinita dipendono da Postfix e dall’indirizzo di
root@pam. Se il dominio non ha un server di posta raggiungibile, restano in coda senza errori visibili: dopo un’installazione il primo controllo èpostqueue -psu ogni nodo, e la soluzione è unrelayhosto un target SMTP. - Scegliere tra i target
sendmaile SMTP. Il target SMTP non dipende dalla coda locale, ma non ha una coda propria e non riprova;sendmailpassa il messaggio a Postfix, che riprova. Usarli entrambi, come in questo lab, costa un duplicato quando consegnano alla stessa casella. - Tenere conto del proxy. Il target Gotify, e secondo il codice sorgente anche il target Webhook, passa dal proxy del Datacenter anche verso indirizzi interni: con un proxy che filtra, serve un’eccezione per le destinazioni interne. Il target SMTP e il metric server InfluxDB si collegano direttamente.
- Progettare i matcher. Un target riceve una notifica al massimo una volta, ma due target che consegnano alla stessa casella producono due copie. Una regola su un campo come
type=fencing, in modalitàany, cattura quell’evento qualunque sia la sua gravità. - Separare scrittura e lettura delle metriche. Un token di sola scrittura per Proxmox VE e uno di sola lettura per Grafana: chi legge le dashboard non può alterare i dati.
- Centralizzare i log con orari affidabili. I log dei servizi stanno nel journal, quelli delle operazioni nei task. Nell’inoltro, usa un formato che porti il fuso orario oppure tieni il server sul fuso dei nodi, e controlla gli orari su un evento noto, come l’inizio di un task scritto nel suo UPID. Una coda disk-assisted supera un fermo del server e un riavvio ordinato, non un crash del nodo.
- Proteggere i servizi di monitoraggio. Solo i nodi scrivono, solo la rete di gestione legge.
Riferimenti
Sezione intitolata “Riferimenti”- Proxmox VE – Notifications: target SMTP (senza coda né nuovi tentativi), target Gotify (proxy del Datacenter), matcher (ogni target al massimo una volta), inoltro della posta di sistema
- Proxmox – codice sorgente del target Gotify (proxy, priorità dalla gravità) e del target Webhook (proxy)
- Proxmox VE – External Metric Server
- Postfix –
relayhost(parentesi quadre) emaximal_queue_lifetime - RFC 5321, sezione 5.1 – consegna senza record MX (MX implicito)
- InfluxDB OSS v2 – Installazione
- Grafana – Installazione su Debian o Ubuntu
- Grafana – dashboard “Proxmox Cluster [Flux]”
- Mailpit e Gotify
- rsyslog – omfwd e il suo template predefinito, template riservati (
RSYSLOG_TraditionalForwardFormat,RSYSLOG_ForwardFormat), code disk-assisted