

Lab 41 – Container LXC: privilegiati e non privilegiati, mount point, funzionalità, limiti e confronto con le VM
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- Lab 07: il primo container (il template
debian-13-standardqui si scarica anche sucephfs, al passo 3); - Lab 13: l’export NFS del NAS
172.27.199.10:/mnt/dati/nfs; - Lab 17: gli storage condivisi
rbd-vmecephfs; - Lab 22: la rete di migrazione sulla VLAN 100;
- Lab 40: il template
9000, per il confronto con una VM.
- Lab 07: il primo container (il template
- Nodi e storage: cluster
desopve01-03; template sucephfs, dischi dei container surbd-vmelocal-zfs. - Rete: il proxy
proxy.proxmox.community:3128per template, immagini e pacchetti. - Indirizzi: CT 141 su 172.27.199.141, CT 142 su .142, CT 143 su .143, VM 144 su .144, CT 150-159 su .150-.159.
- Credenziali:
rootdei container con<password-lab>→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Scaricare template di sistema, TurnKey e immagini OCI, e capire cosa fare quando il download passa da un proxy.
- Capire la differenza tra container privilegiati e non privilegiati guardando gli UID dal nodo.
- Usare mount point su storage e bind mount dal nodo, risolvendo i permessi con la mappatura degli UID.
- Attivare le funzionalità
nesting,fuse,mounte passare un device al container. - Applicare limiti di CPU e RAM e misurarne l’effetto.
- Migrare un container e confrontarlo con una VM: tempi di avvio, RAM e densità.
Come funziona
Sezione intitolata “Come funziona”Un container non è una VM. I processi di un container LXC girano sul kernel del nodo, isolati con i namespace (PID, rete, mount, utenti) e limitati con i cgroup v2. Non c’è un sistema operativo virtualizzato: per questo un container parte in pochi secondi e occupa pochi MiB.
Privilegiato o non privilegiato.
| Non privilegiato (default) | Privilegiato | |
|---|---|---|
root del container sul nodo |
UID 100000 (nessun privilegio) | UID 0, cioè root del nodo |
| Mappatura | /etc/subuid e /etc/subgid: 65536 UID a partire da 100000 |
nessuna |
| Se un processo evade dal container | è un utente qualsiasi del nodo | è root del nodo |
| Limiti | non può montare NFS/CIFS, alcuni device richiedono configurazione | quasi tutto, quindi più rischi |
Mount point.
mpX: storage:dimensionecrea un volume sullo storage, gestito da Proxmox VE: incluso nei backup (backup=1), migrabile se lo storage è condiviso.mpX: /percorso/sul/nodoè un bind mount: una cartella del nodo vista dentro il container. Non va nei backup e blocca la migrazione.
Template. Tre fonti, tutte nello storage con contenuto CT Templates:
- immagini di sistema di Proxmox (
pveam, sezionesystem); - appliance TurnKey Linux (sezione
turnkeylinux); - da Proxmox VE 9.1, immagini OCI (gli stessi formati di Docker/Podman) da un registry: diventano application container con il loro entrypoint.
Procedura
Sezione intitolata “Procedura”1. Template di sistema e TurnKey
Sezione intitolata “1. Template di sistema e TurnKey”Aggiornamento dell’indice e ricerca:
pveam updatepveam available --section turnkeylinux | wc -lpveam available --section system | grep -E "debian-13|alpine-3.23|ubuntu-2[46]"update successful112system alpine-3.23-default_20261105_amd64.tar.xz amd64system debian-13-standard_13.6-1_amd64.tar.zst amd64system debian-13-standard_13.6-1_arm64.tar.zst arm64system ubuntu-24.04-standard_24.04-2_amd64.tar.zst amd64system ubuntu-26.04-standard_26.04-1_amd64.tar.zst amd64system ubuntu-26.10-standard_26.10-1_amd64.tar.zst amd64La stessa lista si vede dalla GUI: storage cephfs → CT Templates → Templates, con la ricerca turnkey:
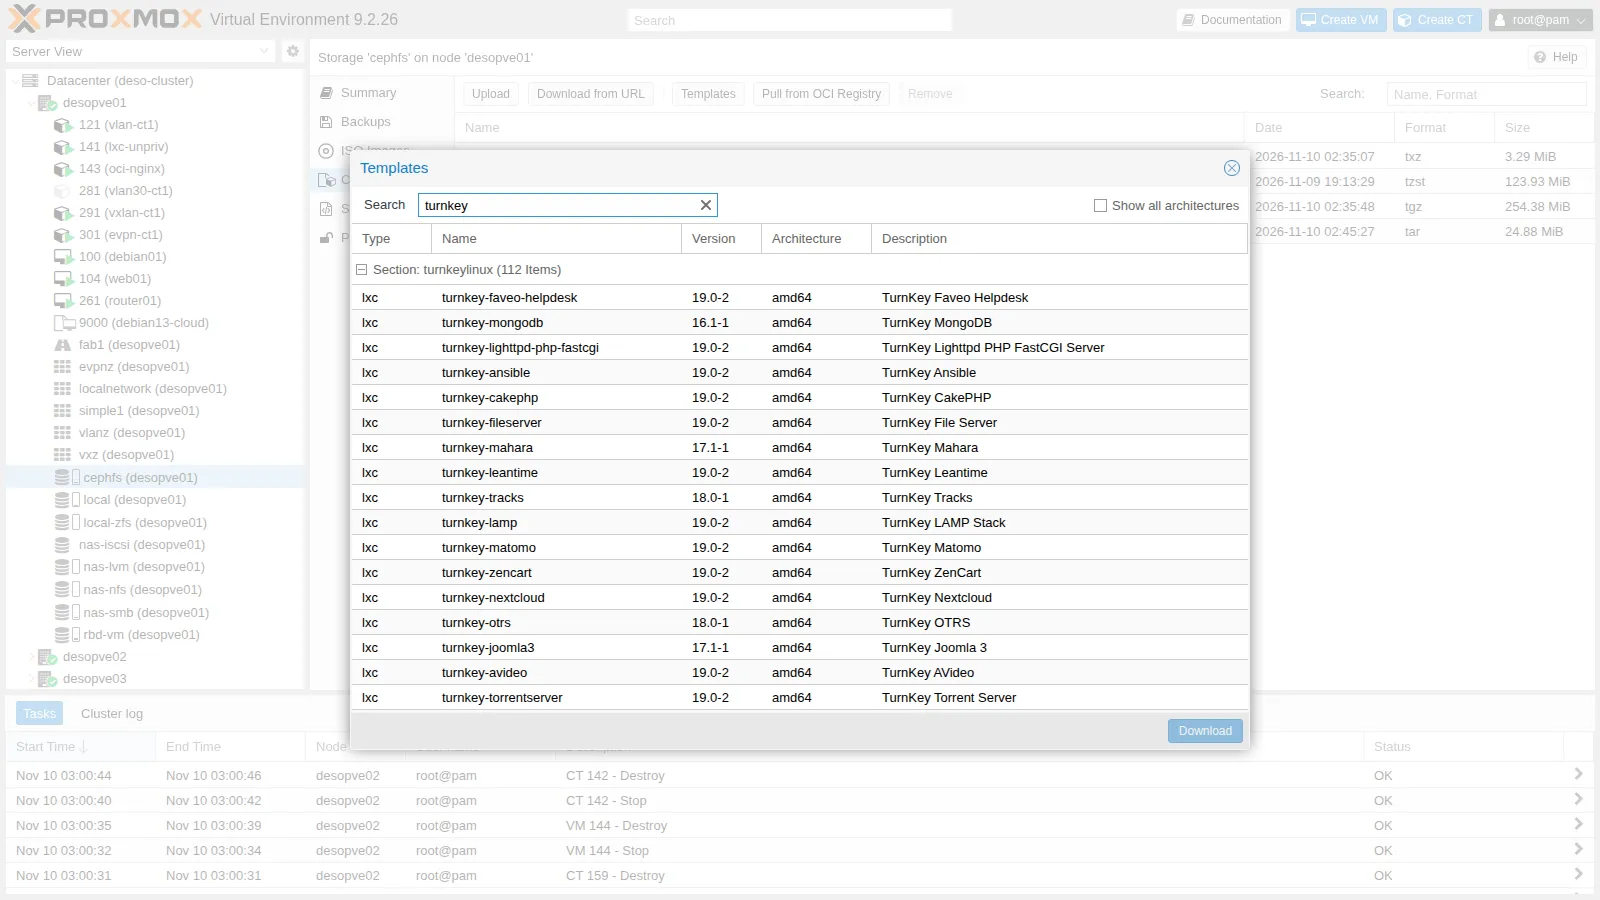
Download di Alpine e di TurnKey Core:
pveam download cephfs alpine-3.23-default_20261105_amd64.tar.xzpveam download cephfs debian-13-turnkey-core_19.0-2_amd64.tar.gzProxy request sent, awaiting response... 200 OKcalculating checksum...OK, checksum verifiedResolving mirror.turnkeylinux.org (mirror.turnkeylinux.org)... failed: Temporary failure in name resolution.download failed: wget: unable to resolve host address 'mirror.turnkeylinux.org'Alpine arriva in 2 secondi, TurnKey no. Il motivo è nell’indice: le appliance TurnKey si scaricano in HTTPS (Location: https://mirror.turnkeylinux.org/...), e pveam passa al proxy solo le richieste HTTP. In una rete senza uscita diretta il download HTTPS tenta la risoluzione DNS diretta e fallisce.
Rimedio: il pulsante Download from URL dello storage, che usa il proxy anche per l’HTTPS. L’URL e lo SHA512 si leggono nell’indice (/var/lib/pve-manager/apl-info/releases.turnkeylinux.org):
pvesh create /nodes/desopve01/storage/cephfs/download-url --content vztmpl \ --filename debian-13-turnkey-core_19.0-2_amd64.tar.gz \ --url https://mirror.turnkeylinux.org/turnkeylinux/images/proxmox/debian-13-turnkey-core_19.0-2_amd64.tar.gz \ --checksum f70345d6b1d5…ba7f11 --checksum-algorithm sha5122026-11-10 02:35:47 (76.0 MB/s) - '/mnt/pve/cephfs/template/cache/debian-13-turnkey-core_19.0-2_amd64.tar.gz.tmp_dwnl.407164' saved [266734332/266734332]calculating checksum...OK, checksum verified254 MB in 7 secondi, con la verifica dello SHA512.
2. Un’immagine OCI come application container
Sezione intitolata “2. Un’immagine OCI come application container”Il pulsante Pull from OCI Registry scarica un’immagine da un registry come Docker Hub. Il campo Reference si divide da solo in immagine e tag:
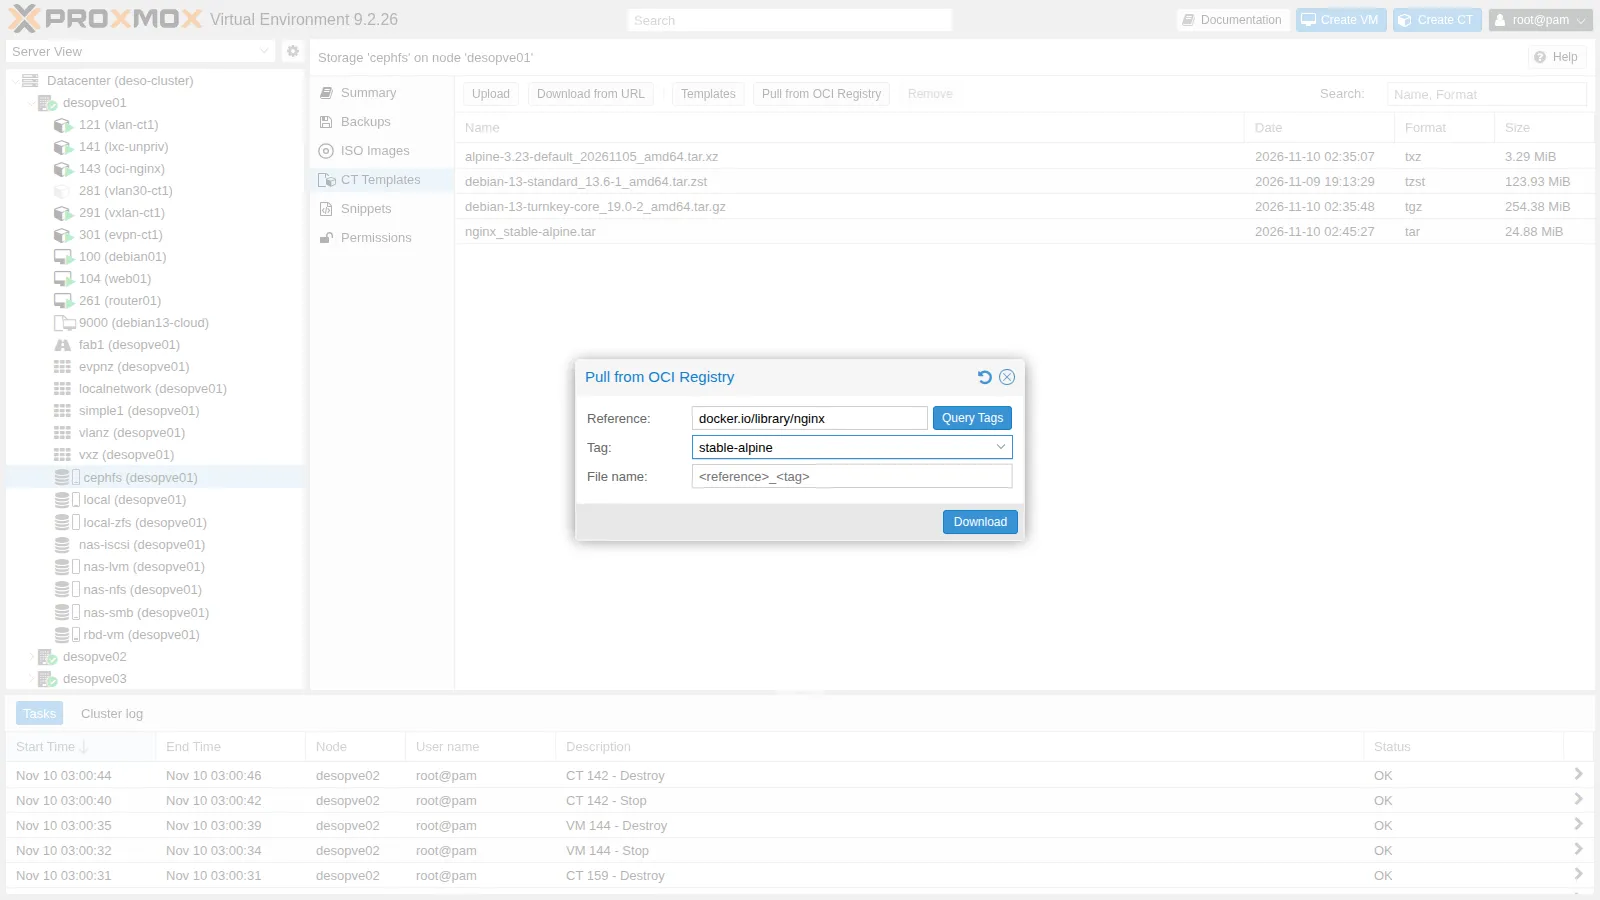
Nel laboratorio il download dalla GUI fallisce:
time="2026-11-10T02:44:57+01:00" level=fatal msg="initializing source docker://nginx:stable-alpine: pinging container registry registry-1.docker.io: Get \"https://registry-1.docker.io/v2/\": dial tcp: lookup registry-1.docker.io on 172.27.199.20:53: read udp 172.27.199.21:43629->172.27.199.20:53: i/o timeout"command 'skopeo copy docker://docker.io/library/nginx:stable-alpine oci-archive:/mnt/pve/cephfs/template/cache/nginx_stable-alpine.tar.tmp.418582' failed: exit code 1Proxmox VE usa skopeo, che non legge il proxy del Datacenter. Lo stesso comando con la variabile HTTPS_PROXY funziona; sul proxy del laboratorio servono i domini docker.io, production.cloudflare.docker.com e production.cloudfront.docker.com:
HTTPS_PROXY=http://proxy.proxmox.community:3128 skopeo copy \ docker://docker.io/library/nginx:stable-alpine \ oci-archive:/mnt/pve/cephfs/template/cache/nginx_stable-alpine.tarCopying config sha256:1390db6b01a8b0c865b157c7f036b0772534418b1701f598737de546d208b6e4Writing manifest to image destinationIl file compare tra i template (25 MiB) e si usa come un template normale:
pct create 143 cephfs:vztmpl/nginx_stable-alpine.tar --hostname oci-nginx --unprivileged 1 \ --memory 256 --rootfs rbd-vm:2 --net0 name=eth0,bridge=vmbr0,ip=172.27.199.143/24,gw=172.27.199.1pct start 143curl -s -o /dev/null -w "HTTP %{http_code}\n" http://172.27.199.143/Detected OCI archiveAuto-Enabling host-managed network for network device net0.Detected container architecture: amd64HTTP 200Proxmox VE riconosce l’immagine OCI, prende dall’immagine entrypoint e variabili d’ambiente e gestisce lui la rete del container (host-managed=1), perché un’immagine applicativa non ha un sistema di rete proprio:
cmode: consoleentrypoint: /docker-entrypoint.sh nginx -g 'daemon off;'env: PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin NGINX_VERSION=1.30.6 PKG_RELEASE=1 …net0: name=eth0,bridge=vmbr0,gw=172.27.199.1,host-managed=1,ip=172.27.199.143/24,type=vethostype: alpinelxc.signal.halt: SIGQUITDentro il container non c’è systemd: il processo 1 è nginx stesso.
PID USER TIME COMMAND 1 root 0:00 nginx: master process nginx -g daemon off; 47 nginx 0:00 nginx: worker process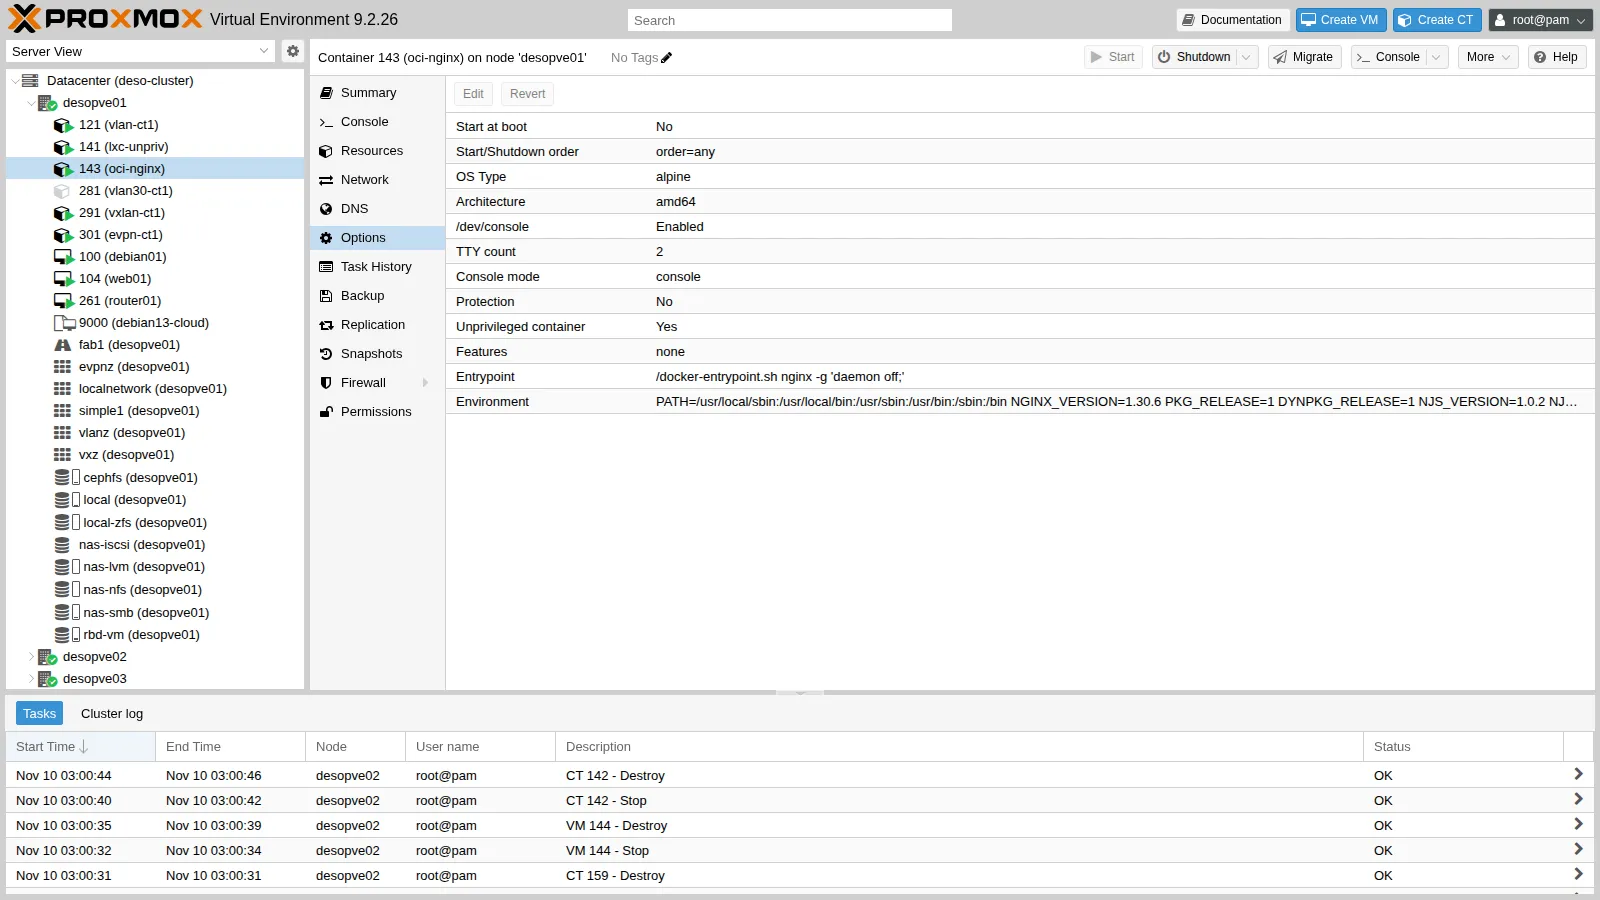
3. Container non privilegiato e privilegiato
Sezione intitolata “3. Container non privilegiato e privilegiato”Nel wizard Create CT le caselle Unprivileged container e Nesting sono già spuntate:
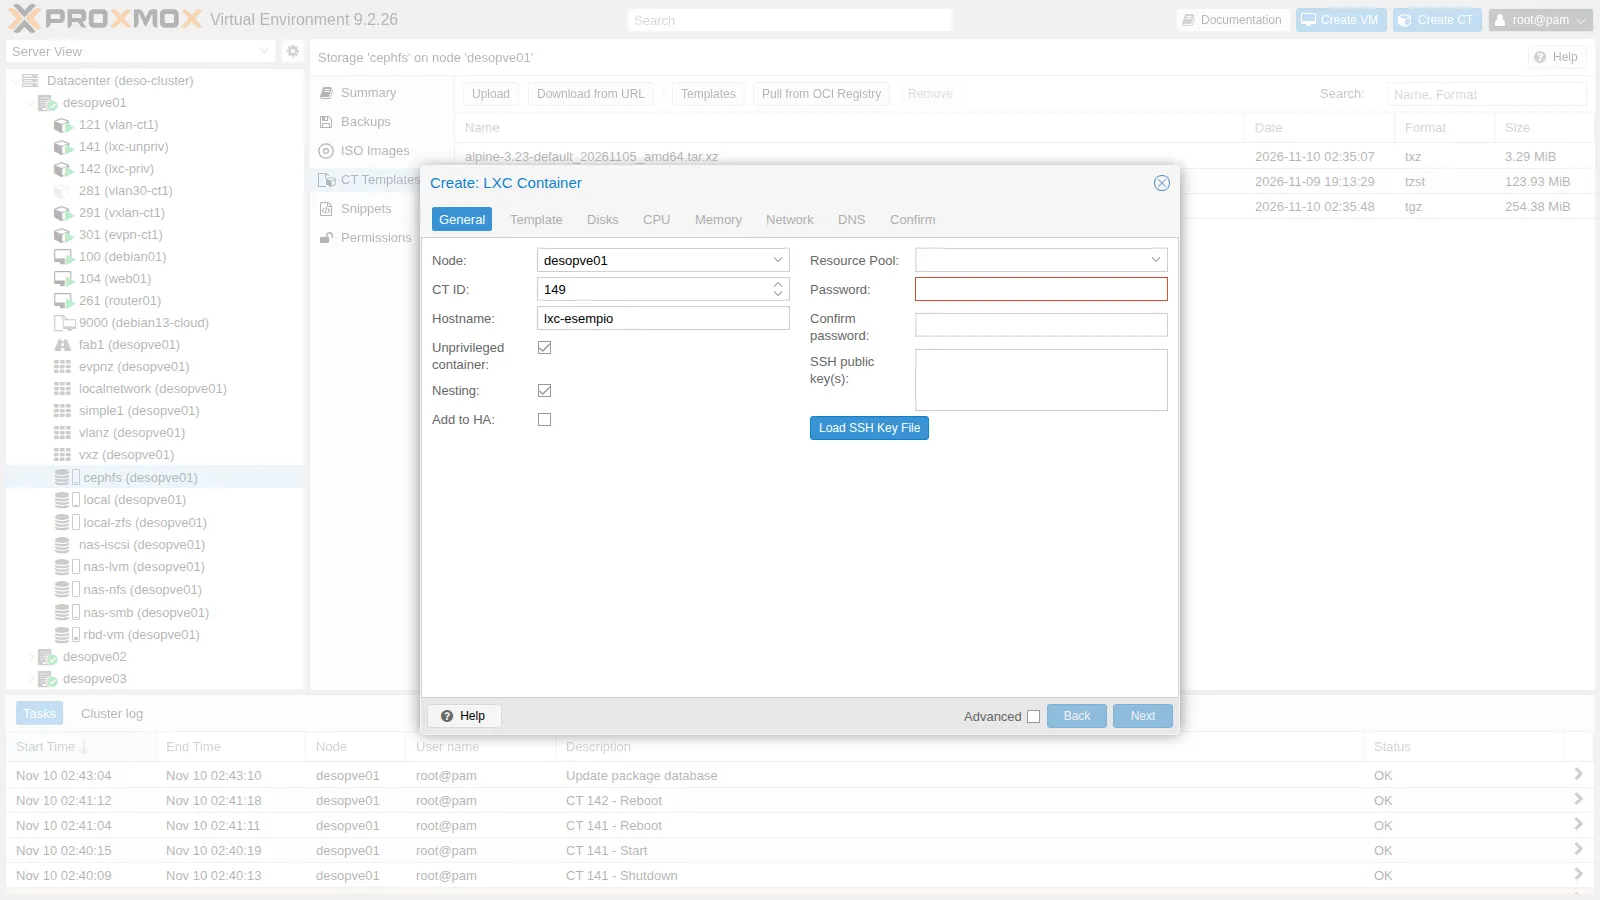
Per confrontarli creo i due container da CLI, uguali tranne --unprivileged:
pveam download cephfs debian-13-standard_13.6-1_amd64.tar.zst # se non è già su cephfsT=cephfs:vztmpl/debian-13-standard_13.6-1_amd64.tar.zstpct create 141 $T --hostname lxc-unpriv --unprivileged 1 --features nesting=1 --cores 2 --memory 1024 --swap 512 \ --rootfs rbd-vm:8 --net0 name=eth0,bridge=vmbr0,ip=172.27.199.141/24,gw=172.27.199.1 \ --nameserver 172.27.199.20 --searchdomain proxmox.community --password '<password-lab>'pct create 142 $T --hostname lxc-priv --unprivileged 0 --cores 2 --memory 1024 --swap 512 \ --rootfs rbd-vm:8 --net0 name=eth0,bridge=vmbr0,ip=172.27.199.142/24,gw=172.27.199.1 \ --nameserver 172.27.199.20 --searchdomain proxmox.community --password '<password-lab>'Per il 142, creato senza nesting, Proxmox VE avvisa:
WARN: Systemd 257 detected. You may need to enable nesting.Con systemd recente alcune funzioni dei servizi (namespace privati, sandbox) richiedono nesting=1, che il wizard attiva già.
Avvia i due container, configura il proxy di apt e installa i pacchetti che servono più avanti (il client NFS e stress-ng, che il template non contiene):
pct start 141 && pct start 142for c in 141 142; do pct exec $c -- sh -c 'echo "Acquire::http::Proxy \"http://proxy.proxmox.community:3128\";" > /etc/apt/apt.conf.d/80proxy && apt-get update -qq && apt-get install -y -qq nfs-common stress-ng'doneLa mappatura degli UID. Il nodo riserva a root 65536 UID a partire da 100000:
# /etc/subuid e /etc/subgidroot:100000:65536root:100000:65536Dentro i due container:
pct exec 141 -- cat /proc/self/uid_mappct exec 142 -- cat /proc/self/uid_mapCT 141: 0 100000 65536CT 142: 0 0 4294967295Il 141 vede gli UID 0-65535 come 100000-165535 del nodo; il 142 usa gli UID del nodo senza conversione. Dal nodo, il processo 1 dei due container:
P=$(lxc-info -n 141 -p -H); ps -o uid=,user=,pid=,cmd= -p $PP=$(lxc-info -n 142 -p -H); ps -o uid=,user=,pid=,cmd= -p $P100000 100000 408967 /sbin/init 0 root 409389 /sbin/initUn file creato da root dentro ciascun container, visto dal nodo attraverso /proc/<PID>/root:
pct exec 141 -- touch /root/prova-lxc-unprivpct exec 142 -- touch /root/prova-lxc-privP=$(lxc-info -n 141 -p -H); ls -ln /proc/$P/root/root/prova-lxc-unprivP=$(lxc-info -n 142 -p -H); ls -ln /proc/$P/root/root/prova-lxc-priv## CT 141-rw-r--r-- 1 100000 100000 0 Nov 10 02:39 prova-lxc-unpriv## CT 142-rw-r--r-- 1 0 0 0 Nov 10 02:39 prova-lxc-privÈ la ragione per cui i container non privilegiati sono più sicuri: se un processo riuscisse a uscire dal 141, sul nodo sarebbe l’utente 100000, che non possiede nulla. Dal 142 sarebbe root.
4. Mount point e bind mount
Sezione intitolata “4. Mount point e bind mount”Un volume su rbd-vm, aggiunto a caldo e incluso nei backup:
pct set 141 -mp0 rbd-vm:4,mp=/data,backup=1pct exec 141 -- df -h /data/dev/rbd5 3.9G 1.1M 3.7G 1% /dataUn bind mount di una cartella del nodo:
mkdir -p /srv/condivisa && echo 'file creato sul nodo' > /srv/condivisa/leggimi.txtpct set 141 -mp1 /srv/condivisa,mp=/condivisapct exec 141 -- ls -ln /condivisapct exec 141 -- touch /condivisa/scrivo-io-rw-r--r-- 1 65534 65534 21 Nov 10 01:39 leggimi.txttouch: cannot touch '/condivisa/scrivo-io': Permission deniedIl file appartiene a root del nodo (UID 0), che non è mappato nel container: dentro appare come nobody (65534) e root del container non può scrivere. La soluzione più semplice è dare la cartella all’UID che corrisponde a root del container:
chown -R 100000:100000 /srv/condivisapct exec 141 -- touch /condivisa/scrivo-io && ls -ln /srv/condivisa-rw-r--r-- 1 100000 100000 21 Nov 10 02:39 leggimi.txt-rw-r--r-- 1 100000 100000 0 Nov 10 02:39 scrivo-ioMappare un UID specifico. Se la cartella sul nodo appartiene a un utente reale (UID 1000) e dentro il container deve usarla lo stesso UID, si apre un “buco” nella mappatura. Per vedere anche un errore frequente, crea prima l’utente ana nel container, come se esistesse già (prende l’UID 1000):
pct exec 141 -- useradd -m -s /bin/bash anaSul nodo:
mkdir -p /srv/progetti && echo 'documento di ana' > /srv/progetti/progetto.txt && chown -R 1000:1000 /srv/progettiecho 'root:1000:1' >> /etc/subuidecho 'root:1000:1' >> /etc/subgidSpegni il container (pct shutdown 141) e aggiungi al file /etc/pve/lxc/141.conf la mappatura in tre pezzi: 0-999 come prima, 1000 su 1000, 1001-65535 come prima:
lxc.idmap: u 0 100000 1000lxc.idmap: g 0 100000 1000lxc.idmap: u 1000 1000 1lxc.idmap: g 1000 1000 1lxc.idmap: u 1001 101001 64535lxc.idmap: g 1001 101001 64535pct set 141 -mp2 /srv/progetti,mp=/progettipct start 141pct exec 141 -- cat /proc/self/uid_mappct exec 141 -- su - ana -c 'echo modifica di ana >> /progetti/progetto.txt && touch /progetti/nuovo-da-ana'ls -ln /srv/progetti 0 100000 1000 1000 1000 1 1001 101001 64535-rw-rw-r-- 1 1000 1000 0 Nov 10 02:40 nuovo-da-ana-rw-r--r-- 1 1000 1000 33 Nov 10 02:40 progetto.txtL’utente ana (UID 1000) scrive nella cartella del nodo con il proprio UID.
Trappola: l’utente ana è stato creato prima di cambiare la mappatura, quindi la sua home sul nodo appartiene a 101000, che con la nuova mappatura non corrisponde più a nessun UID del container:
su: warning: cannot change directory to /home/ana: Permission denieddrwx------ 2 65534 65534 4096 Nov 10 01:40 /home/anachown: cannot read directory '/home/ana': Permission deniedroot del container non può correggerla, perché il file non appartiene a nessun UID mappato. Si corregge dal nodo:
P=$(lxc-info -n 141 -p -H); chown -R 1000:1000 /proc/$P/root/home/anaRegola pratica: definire la mappatura prima di creare gli utenti nel container.
5. Funzionalità e device
Sezione intitolata “5. Funzionalità e device”Device: /dev/net/tun, necessario per VPN come WireGuard in userspace o OpenVPN:
pct exec 141 -- ip tuntap add mode tun dev tun0pct set 141 -dev0 /dev/net/tunpct exec 141 -- ip tuntap add mode tun dev tun0 && pct exec 141 -- ip -br link show tun0open: No such file or directorytun0 DOWN <POINTOPOINT,MULTICAST,NOARP>Il device si aggiunge a caldo.
FUSE (filesystem in userspace, per esempio sshfs): si attiva con la funzionalità fuse=1 e un riavvio del container, dopo il quale compare il device:
pct set 141 -features nesting=1,fuse=1 && pct reboot 141 && pct exec 141 -- ls -l /dev/fusecrw-rw-rw- 1 nobody nogroup 10, 229 Nov 9 13:31 /dev/fuseMontare NFS dentro il container. La funzionalità mount=nfs si può impostare su entrambi, ma il risultato è diverso:
pct set 142 -features nesting=1,mount=nfs # privilegiatopct set 141 -features nesting=1,fuse=1,mount=nfs # non privilegiatopct reboot 142 && pct reboot 141pct exec 142 -- mkdir -p /mnt/nas && pct exec 141 -- mkdir -p /mnt/naspct exec 142 -- mount -t nfs -o vers=4.2 172.27.199.10:/mnt/dati/nfs /mnt/naspct exec 141 -- mount -t nfs -o vers=4.2 172.27.199.10:/mnt/dati/nfs /mnt/nasCT 142: 172.27.199.10:/mnt/dati/nfs 54G 0 54G 0% /mnt/nasCT 141: mount.nfs: Operation not permitted for 172.27.199.10:/mnt/dati/nfs on /mnt/nasIl kernel non permette di montare NFS da un namespace utente. Per un container non privilegiato la strada giusta è montare la share sul nodo, o usare uno storage di Proxmox VE, e passarla con un mount point. Togli poi mount=nfs dal 141, dove non serve: pct set 141 -features nesting=1,fuse=1 e pct reboot 141.
Le funzionalità attive si vedono in Options:
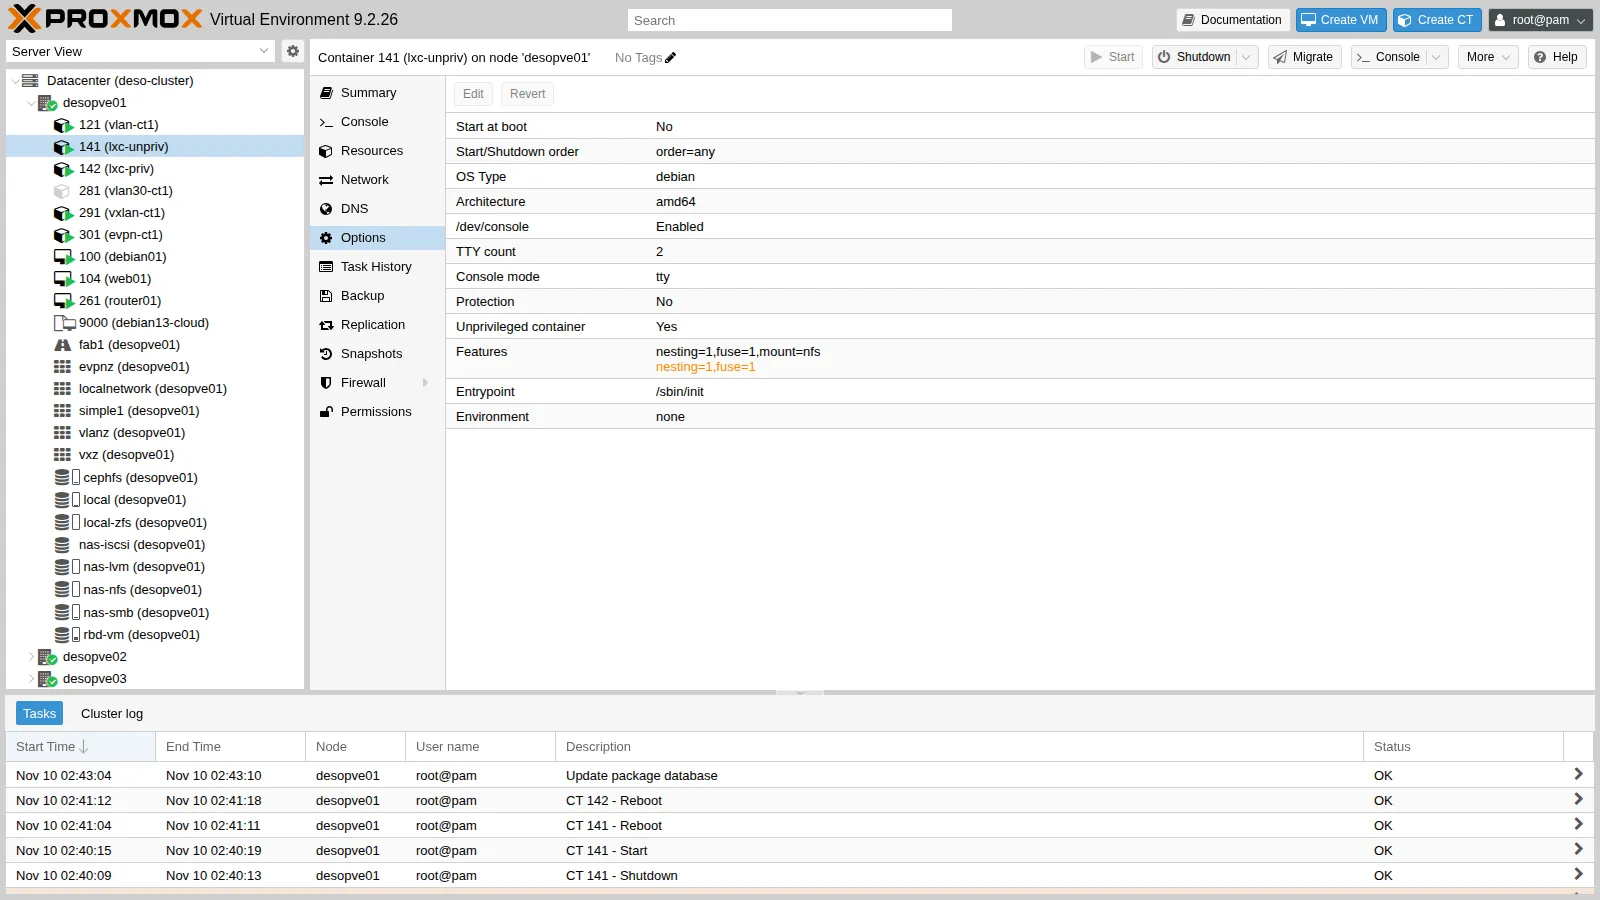
Le altre funzionalità utili:
keyctl=1: le chiamate di sistema per le chiavi del kernel, necessarie a Docker dentro un container non privilegiato;nesting=1: namespace annidati, per systemd recente e per container dentro il container.
6. Limiti di CPU e RAM
Sezione intitolata “6. Limiti di CPU e RAM”Al 141 assegno 1 core, metà di un core come tetto, 512 MiB di RAM e 256 MiB di swap:
pct set 141 -cores 1 -cpulimit 0.5 -memory 512 -swap 256Proxmox VE li traduce nei file del cgroup /sys/fs/cgroup/lxc/141/:
cpu.max: 50000 100000memory.max: 536870912memory.swap.max: 268435456cpu.max significa “50 ms di CPU ogni 100 ms”, cioè mezzo core. Il numero di core, invece, è un cpuset: subito dopo il comando era ancora 0,3, pochi secondi dopo era 0 e dentro il container nproc restituiva 1.
Dentro il container free mostra la RAM del limite e non quella del nodo:
total used free shared buff/cache availableMem: 512 16 262 0 232 495Swap: 0 0 0CPU misurata. stress-ng con 2 processi per 20 secondi; il consumo si legge dal nodo nel cpu.stat del cgroup, prima e dopo. Lo script misure.sh, da copiare sul nodo, fa i conti (qui con la riga delle metriche di stress-ng):
./misure.sh cpu 141 pct exec 141 -- stress-ng --cpu 2 --timeout 20s --metrics-briefstress-ng: metrc: [1381] cpu 12146 20.05 10.00 0.02 605.90 1211.82CPU usata dal cgroup: 10.1 s su 21.3 s di orologio = 47% di un coreIl tetto di mezzo core è rispettato.
RAM misurata. stress-ng prova ad allocare 900 MiB:
pct exec 141 -- stress-ng --vm 1 --vm-bytes 900M --vm-keep --timeout 20s >/dev/null &./misure.sh mem 141 12journalctl -k --since "-2min" | grep -m1 "Memory cgroup out of memory" | sed 's/^.*kernel: //'t+3s memory.current=506 MiB swap.current=0 MiBt+6s memory.current=290 MiB swap.current=0 MiBt+9s memory.current=511 MiB swap.current=0 MiBt+12s memory.current=512 MiB swap.current=0 MiBoom_kill: 11 -> 16Memory cgroup out of memory: Killed process 826768 (stress-ng-vm) total-vm:1001468kB, anon-rss:475832kB, file-rss:4kB, shmem-rss:64kB, UID:100000 pgtables:1024kB oom_score_adj:1000Il contatore oom_kill del cgroup sale a ogni processo ucciso (qui partiva da 11 per le prove precedenti).
Al limite di 512 MiB il kernel uccide il processo dentro il cgroup del container (UID:100000): il nodo e gli altri guest non se ne accorgono. La swap del container non viene usata perché desopve01 non ha swap: l’installazione su ZFS non la crea (swapon --show è vuoto). Il limite di swap ha effetto solo su un nodo che ne ha.
Le risorse finali del 141:
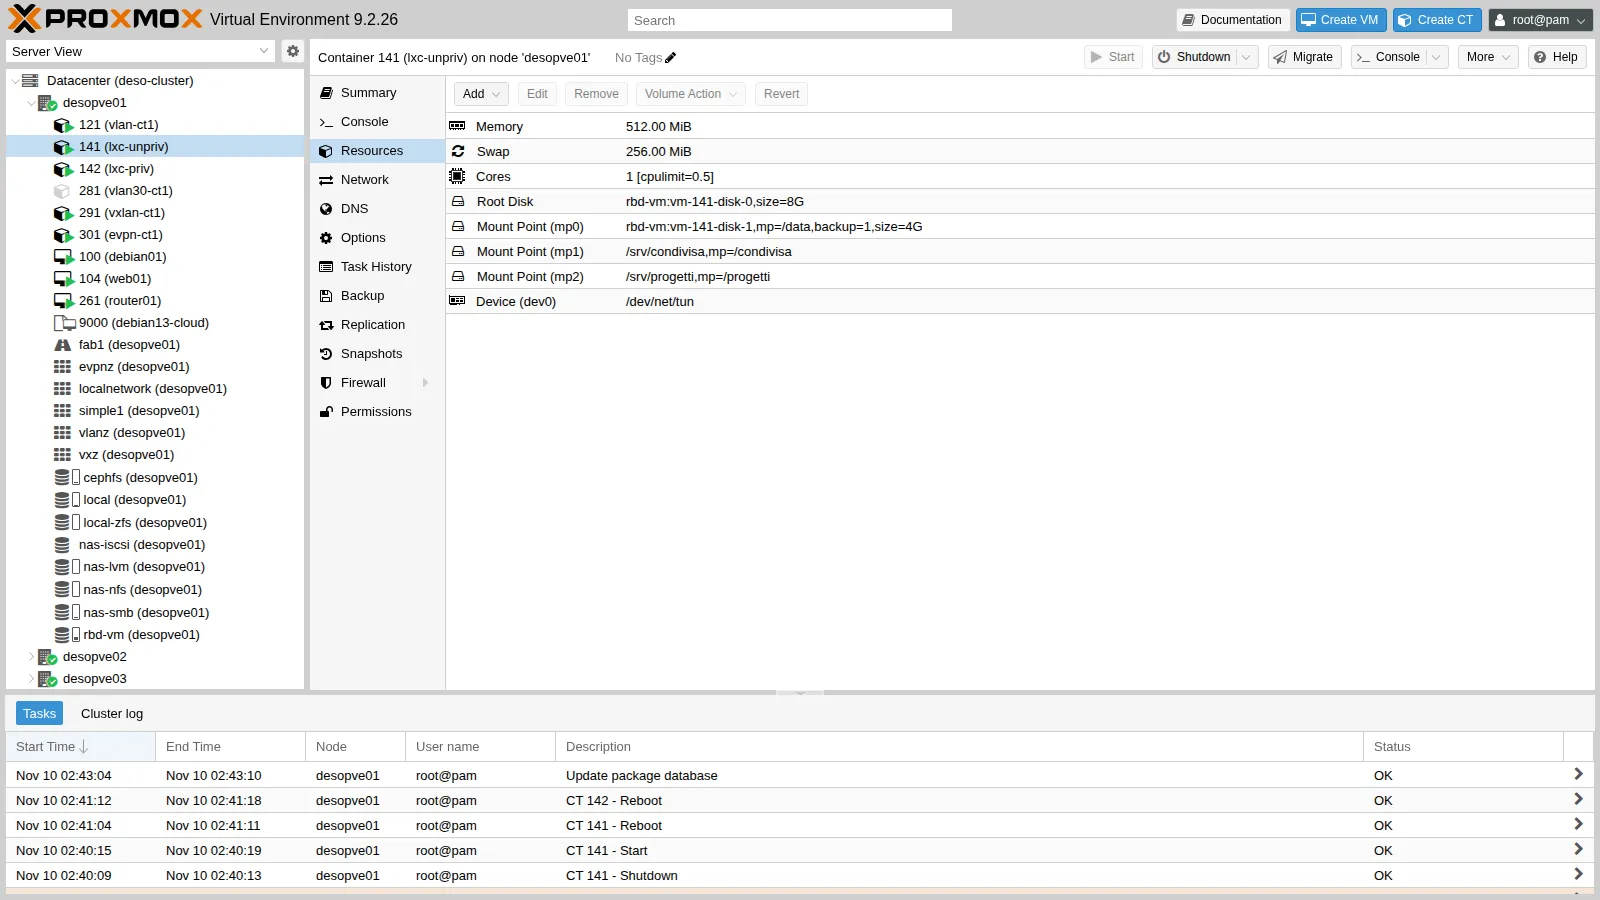
7. Migrazione di un container
Sezione intitolata “7. Migrazione di un container”Un container acceso non si migra “a caldo”:
pct migrate 141 desopve02pct migrate 141 desopve02 --restartpct migrate 142 desopve02 --onlinecan't migrate running container without --online or --restartERROR: migration aborted (duration 00:00:00): cannot migrate local bind mount point 'mp1'ERROR: migration aborted (duration 00:00:00): lxc live migration is currently not implemented- La migrazione dal vivo dei container non esiste: Proxmox VE accetta
--onlinema rifiuta l’operazione. - La migrazione restart spegne il container, lo sposta e lo riaccende.
- Un bind mount locale blocca la migrazione: la cartella esiste solo su quel nodo.
Il CT 142, senza bind mount e con il disco su rbd-vm. Mentre migra, da un altro terminale sul nodo un ping ogni 0,2 secondi conta le risposte perse:
./misure.sh pinggap 172.27.199.142 30 # secondo terminalepct migrate 142 desopve02 --restartshutdown CT 142starting migration of CT 142 to node 'desopve02' (10.100.10.22)start container on target nodemigration finished successfully (duration 00:00:10)buco nei ping: 17 risposte perse, circa 3.4 sIl disco è condiviso, quindi non si copia nulla: 10 secondi in tutto, 3,4 secondi senza risposta. La migrazione usa la rete dedicata del Lab 22 (10.100.10.22).
8. Container contro VM
Sezione intitolata “8. Container contro VM”Tempo di avvio. Il CT 142 (Debian 13) e la VM 144, un linked clone del template 9000, con 1 GiB di RAM ciascuno. La VM si crea su desopve01:
qm clone 9000 144 --name vm144 && qm set 144 --memory 1024 --ipconfig0 ip=172.27.199.144/24,gw=172.27.199.1Il tempo tra il comando di avvio e la prima risposta si misura con un ciclo sul nodo, due volte per guest (per la VM, qm start 144 e l’IP .144):
t0=$(date +%s.%N); pct start 142until ping -c1 -W1 172.27.199.142 >/dev/null; do :; done; echo "$(date +%s.%N) - $t0" | bc| Guest | Primo ping | SSH pronto |
|---|---|---|
| CT 142 | 7,2-7,3 s | 7,2-7,3 s |
| VM 144 | 22,1-22,6 s | 24,5-24,8 s |
| VM 144, primo avvio con cloud-init | – | 63 s |
Il container non ha firmware, bootloader e kernel da avviare: parte systemd direttamente.
RAM a riposo, dal cgroup sul nodo dopo 40 secondi (memory.current in /sys/fs/cgroup/lxc/142/ e in /sys/fs/cgroup/qemu.slice/144.scope/), in sintesi:
CT 142: 113 MiBVM 144: 308 MiB (memoria assegnata 1024 MiB)La VM tiene in RAM un kernel completo e la cache del guest; il container condivide il kernel del nodo.
Densità. Dieci container Alpine da 64 MiB su desopve02, rootfs su local-zfs:
for i in $(seq 150 159); do pct create $i cephfs:vztmpl/alpine-3.23-default_20261105_amd64.tar.xz --hostname alp$i --unprivileged 1 \ --memory 64 --swap 0 --cores 1 --rootfs local-zfs:1 \ --net0 name=eth0,bridge=vmbr0,ip=172.27.199.$i/24,gw=172.27.199.1 --password '<password-lab>'donefor i in $(seq 150 159); do pct start $i; doneRiepilogo delle misure (time sui due cicli, memoria disponibile del nodo prima e dopo con free -m, somma dei memory.current dei cgroup):
creazione di 10 CT: 23.5 s; avvio di 10 CT: 39.8 s; rispondono al ping: 10/10memoria disponibile del nodo: -158 MiB; somma memory.current dei 10 CT: 24 MiBCT 150: 2560 KiBOgni container Alpine usa 2,5 MiB di RAM e 7,7 MB di disco (zfs list). La memoria disponibile del nodo cala di più (158 MiB) per le strutture del kernel e la cache dei filesystem. Con le VM la stessa prova richiederebbe almeno dieci kernel e dieci volte la RAM minima di un sistema operativo.
Alla fine elimina i guest di prova:
# su desopve02pct stop 142 && pct destroy 142 --purgefor i in $(seq 150 159); do pct stop $i; pct destroy $i --purge; done# su desopve01qm stop 144 && qm destroy 144 --purgeVerifica e test
Sezione intitolata “Verifica e test”- Un’appliance TurnKey in HTTPS si scarica con Download from URL anche dietro proxy;
pveam downloadfallisce senza uscita diretta. - Un’immagine OCI diventa un application container con entrypoint e variabili dell’immagine; con skopeo e
HTTPS_PROXYil download funziona anche dietro proxy. rootdel container non privilegiato è l’UID 100000 sul nodo; quello del privilegiato è l’UID 0.- Un bind mount appartiene a
nobodynel container finché non si allinea il proprietario (100000) o si mappa l’UID. - Il device
/dev/net/tunsi aggiunge a caldo; FUSE richiede un riavvio; NFS si monta solo nel container privilegiato. - Il tetto di mezzo core porta il consumo al 47% di un core; il limite di 512 MiB fa intervenire l’OOM killer nel solo container.
- La migrazione restart di un container su storage condiviso dura 10 secondi con 3,4 secondi di interruzione; la migrazione dal vivo non è disponibile.
- Un container parte in circa 7 secondi contro i 22-25 di una VM, e a riposo usa 113 MiB contro 308.
Stato finale del lab
Sezione intitolata “Stato finale del lab”- CT 141
lxc-unprivsudesopve01, acceso, non privilegiato, 172.27.199.141:- 1 core con
cpulimit 0.5, 512 MiB di RAM, 256 MiB di swap; mp0surbd-vm(4 GiB,/data,backup=1);- bind mount
mp1/srv/condivisa→/condivisaemp2/srv/progetti→/progetti: per questo il 141 non si migra finché non si tolgono; dev0: /dev/net/tun, featuresnesting=1,fuse=1;- mappatura degli UID con l’UID 1000 passante, utente
ana(UID 1000) nel container; sul nodo/etc/subuide/etc/subgidcontengono ancheroot:1000:1.
- 1 core con
- CT 143
oci-nginxsudesopve01, acceso: application container dall’immagine OCInginx:stable-alpine, 172.27.199.143, risponde in HTTP. - Template su
cephfs:debian-13-standard,alpine-3.23-default,debian-13-turnkey-coree l’archivio OCInginx_stable-alpine.tar. - Eliminati: CT 142, CT 150-159, VM 144.
- Proxy del laboratorio: aggiunti alla whitelist
docker.io,production.cloudflare.docker.comeproduction.cloudfront.docker.com.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- I container condividono il kernel del nodo: partono in pochi secondi e occupano pochi MiB, ma non si migrano dal vivo.
- Un container non privilegiato sposta gli UID di 100000: è la scelta di default e quella sicura.
- I mount point su storage seguono la migrazione e, con
backup=1, il backup; i bind mount no, e richiedono di allineare i proprietari. - Con
lxc.idmape/etc/subuidun UID specifico può passare intatto tra nodo e container; va fatto prima di creare gli utenti. - Device, FUSE e montaggi si abilitano con
devXefeatures; NFS dentro il container funziona solo se è privilegiato. - I limiti di CPU e RAM sono cgroup v2: si leggono e si misurano direttamente dal nodo.
- Dietro un proxy, TurnKey (HTTPS) e le immagini OCI (skopeo) richiedono un passaggio in più.