

Lab 48 – Migrazioni: live, offline, con dischi locali, container, bulk e tra cluster
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- Lab 06: il cluster
deso-clustere il nodo autonomodesopve04; - Lab 11: la migrazione con la replica ZFS;
- Lab 17: lo storage condiviso
rbd-vm; - Lab 22: la rete di migrazione VLAN 100 (10.100.10.0/24);
- Lab 33: il firewall con nftables, che apre le porte 60000-60050 sulla rete di migrazione;
- Lab 40: il template 9000 e le VM
web01-web03.
- Lab 06: il cluster
- Sistemi:
- nodi
desopve01-03edesopve04; - VM 100
debian01e 104web01, entrambe surbd-vm; - CT 121 e 122 sulla VLAN 10 (Lab 20), CT 101 (Lab 07), CT 271 e 272 (Lab 27), CT 281 (Lab 28), VM 390 (Lab 39): servono alla bulk migration;
- il pool ZFS
tankdidesopve04(Lab 10) e lo snippetweb-vendor.yamlsucephfs(Lab 40); - una VM di prova su
local-zfs, creata nel lab.
- nodi
- Misure: il log del task di ogni migrazione e un
pingogni 0,2 s verso il guest, dalla rete di gestione o da un altro CT. Che cosa misura ciascuno è spiegato in Come funziona. - Credenziali:
root@pam→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- La VM 104 migrata a caldo con lo storage condiviso e il CT 281 migrato a freddo, registrando separatamente durata del task, fermo riportato da QEMU e pausa massima del ping.
- Una VM accesa con disco locale migrata su un altro nodo insieme al disco, leggendo nel log il tempo speso a copiarlo.
- Un container spostato in restart mode, sapendo per quanto il suo servizio resta irraggiungibile.
- Una bulk migration avviata con selezionati solo i guest voluti.
- Le modalità secure e insecure confrontate sulla rete dedicata, sapendo che cosa il log del task può dire, e che cosa no, sulla loro velocità.
- Una VM spostata su un altro cluster con
qm remote-migratee riportata indietro, con i due errori incontrati spiegati e risolti.
Come funziona
Sezione intitolata “Come funziona”Live migration di una VM. Sul nodo di destinazione parte un processo QEMU vuoto. La RAM viene copiata mentre la VM lavora; le pagine riscritte vengono ricopiate, finché ne resta così poco da chiudere in una pausa brevissima (downtime, limite di default 100 ms). Con lo storage condiviso i dischi non si muovono.
Dischi locali. Con --with-local-disks i dischi vengono copiati prima della RAM con un drive-mirror via NBD. Quando sono sincronizzati, si migra la RAM come sopra. Il tempo cresce con la dimensione dei dischi.
Container. LXC non ha una live migration: il CT viene spento, spostato e riacceso (restart mode). Con lo storage condiviso si sposta solo la configurazione.
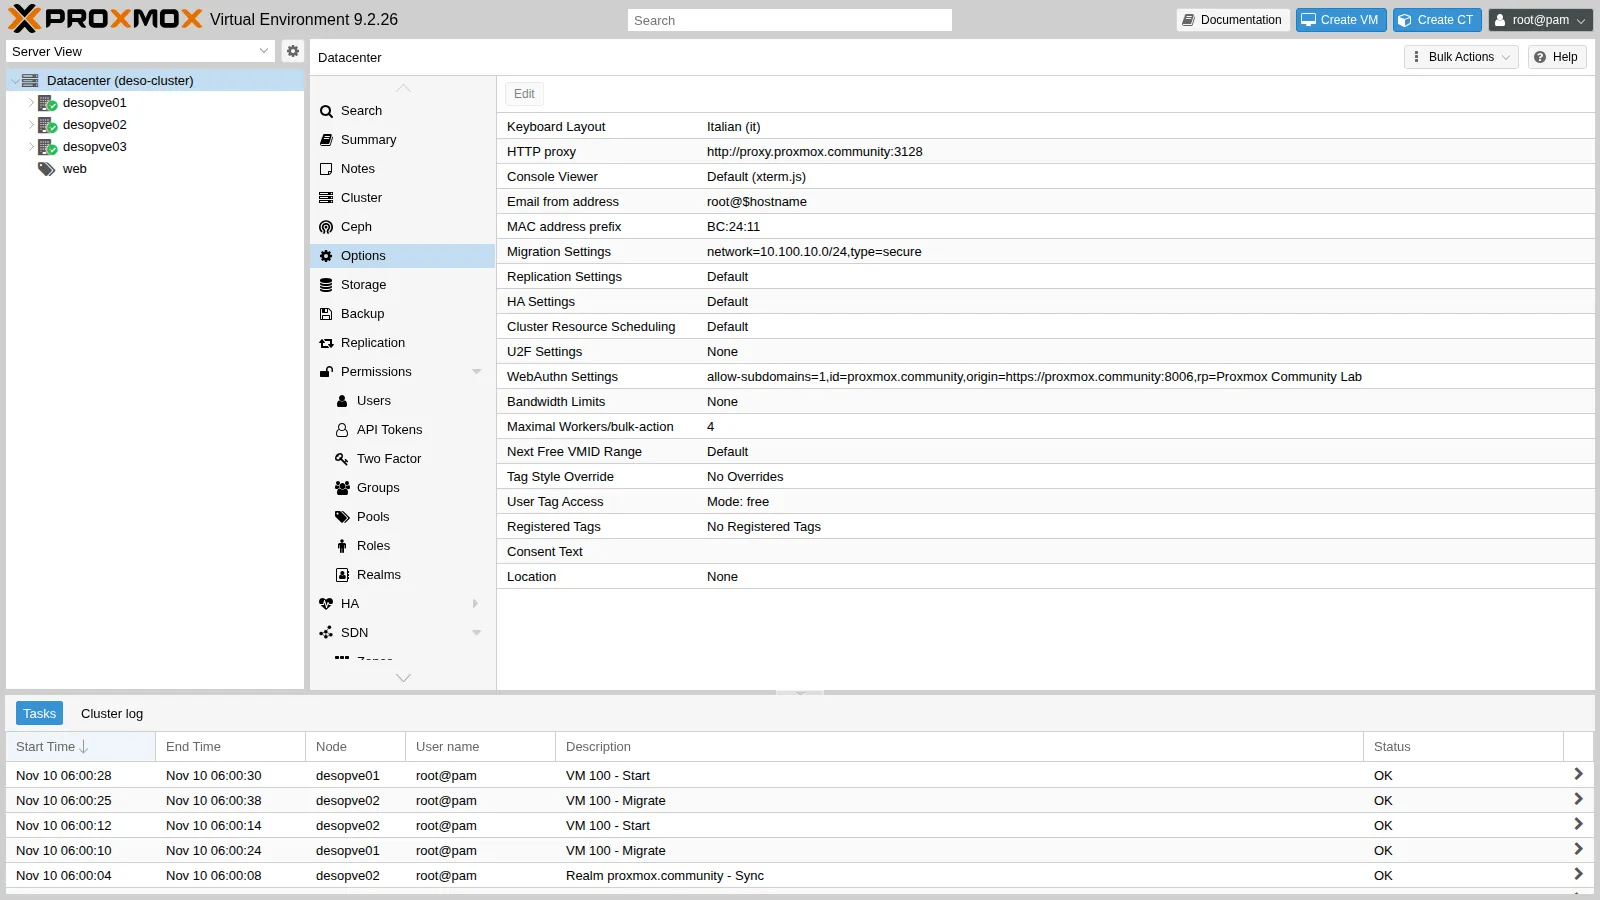
Rete di migrazione. In Datacenter → Options → Migration Settings si sceglie la rete (qui la VLAN 100) e il tipo:
- secure: la RAM passa in un tunnel SSH;
- insecure: la RAM passa in chiaro su TCP (porte 60000-60050), più leggera per la CPU. Ha senso solo su una rete dedicata e fidata.
Tra cluster. qm remote-migrate usa l’API del cluster di destinazione con un API token e l’impronta del certificato. Tutto il traffico, dischi e RAM, passa in un tunnel websocket sulla porta 8006. È ancora una funzione sperimentale, solo da CLI (dalla GUI la offre Proxmox Datacenter Manager, Lab 53).
Che cosa misurano il log del task e il ping. Tre valori si confondono facilmente, e in questo lab restano separati:
- durata del task: la
durationdell’ultima riga del log, in secondi interi, dall’inizio alla fine del task, preparazione e pulizia comprese; - fermo riportato da QEMU: il
downtime N msalla fine della fase di memoria, cioè il tempo per cui la VM resta in pausa sull’origine durante il passaggio finale. Proxmox VE riprende poi la VM sulla destinazione solo dopo alcuni altri passi, come lo spostamento della configurazione e, con i dischi locali, la chiusura del mirror dei dischi: la pausa vista dai client del guest può quindi essere più lunga di questo valore; - pausa massima del ping: l’intervallo più lungo tra due risposte di un
pinginviato ogni 0,2 secondi. È quello che vede un client in rete, con una risoluzione di 0,2 secondi.
Nemmeno la average migration speed, sulla stessa riga del fermo, è una velocità misurata: Proxmox VE la calcola come la RAM totale del guest divisa per la durata della fase di memoria, contata in secondi interi (vedi il sorgente di QemuMigrate.pm tra i riferimenti).
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Gli output e i tempi di questo lab vengono da una prova eseguita il 10 novembre 2026 (ultima verifica: novembre 2026), in questa configurazione:
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04), sui nodi del cluster e su desopve04 |
| Migrazioni nel cluster | VLAN 100 su vmbr1, sopra bond0 in active-backup con due schede da 10 Gbit/s, MTU 1500 (Lab 21, Lab 22); tipo secure salvo dove indicato |
| Migrazioni tra cluster | qm remote-migrate verso l’API dell’altro nodo (porta 8006), sulla rete di gestione |
| Storage | rbd-vm: Ceph 20.2.5, pool size 3 / min_size 2 (Lab 17); local-zfs: ZFS mirror sui dischi di sistema (Lab 03); su desopve04, local-lvm (LVM-thin) e tank (ZFS RAIDZ1) (Lab 09, Lab 10) |
| Guest | VM 104 e 480, cloni del template 9000: Debian 13, 2 GiB di RAM, disco da 8 GiB (Lab 40); VM 100 con 2 GiB di RAM; CT 121 con indirizzo statico sulla VLAN 10 (Lab 21) |
Cosa misura e cosa non misura. Ogni migrazione è stata eseguita una volta sola, il confronto secure/insecure due volte, con guest piccoli (2 GiB di RAM, 653 MiB di dati sul disco locale) e scarichi, tranne la VM 100 nel passo 6. La prova non copre guest che riscrivono velocemente la memoria, dischi grandi o una rete carica, e una o due ripetizioni non mostrano quanto variano i tempi.
Procedura
Sezione intitolata “Procedura”1. Live con storage condiviso
Sezione intitolata “1. Live con storage condiviso”web01 (VM 104) ha il disco su Ceph (rbd-vm):
qm migrate 104 desopve02 --online2026-11-10 05:55:53 conntrack state migration not supported or disabled, active connections might get dropped2026-11-10 05:55:53 use dedicated network address for sending migration traffic (10.100.10.22)2026-11-10 05:55:58 migration downtime limit: 100 ms2026-11-10 05:56:00 average migration speed: 1.0 GiB/s - downtime 33 ms2026-11-10 05:56:00 migration completed, transferred 281.4 MiB VM-state2026-11-10 05:56:03 migration finished successfully (duration 00:00:10)- 10 s di durata del task: si trasferiscono solo 281 MiB di RAM (
transferred 281.4 MiB VM-state), sulla VLAN 100. - 33 ms di fermo riportato da QEMU.
- 0,84 s: l’intervallo più lungo tra due risposte del
ping, inviato ogni 0,2 s dalla rete di gestione.
La pausa del ping è molto più lunga del fermo: i due valori misurano cose diverse e vanno tenuti separati. Le spiegazioni possibili sono due, e questa prova non permette di distinguerle: Proxmox VE riprende la VM sulla destinazione solo dopo la fase di memoria e alcuni altri passi (vedi Come funziona), e dopo lo spostamento la rete deve imparare dove si trova ora l’indirizzo MAC della VM, motivo per cui QEMU invia pacchetti di annuncio. Per verificarlo servirebbero:
- un
pingmolto più fitto (per esempio ogni 10 ms,ping -i 0.01), per misurare la pausa con una risoluzione paragonabile al fermo; - gli orari del ping (
ping -D) confrontati con quelli delle ultime righe del log del task; - una cattura sul bridge del nodo di destinazione durante la migrazione (
tcpdump -eni vmbr0 arp or rarp), per vedere quando la VM annuncia la nuova posizione.
Conntrack (novità 9.x). La prima riga avvisa che lo stato delle connessioni tracciate dal firewall non viene migrato. Con il firewall nftables (Lab 33) si può chiedere di portarlo con la VM:
qm migrate 104 desopve01 --online --with-conntrack-state 1 # da desopve02: riporta anche la VM al suo nodo2026-11-10 06:11:33 average migration speed: 1.0 GiB/s - downtime 93 ms2026-11-10 06:11:33 migrated 0 conntrack state entries2026-11-10 06:11:36 flushing conntrack state for guest on source node2026-11-10 06:11:40 migration finished successfully (duration 00:00:14)Le voci migrate sono 0. È coerente con la configurazione di web01, che non ha il firewall attivo sulla scheda: l’opzione serve per i guest con il firewall attivo, perché senza le loro voci di conntrack il firewall del nodo di destinazione scarterebbe come invalid i pacchetti delle connessioni già aperte. La documentazione la descrive come una funzione best-effort. Per vederla all’opera ripeti la prova con un guest che ha firewall=1 sulla scheda e una connessione aperta, per esempio una sessione SSH, e controlla che la sessione sopravviva allo spostamento. Nella GUI l’opzione Conntrack state è spuntata per default.
2. Offline
Sezione intitolata “2. Offline”Il CT 281 è spento e ha il disco su Ceph:
time pct migrate 281 desopve022026-11-10 05:56:17 volume 'rbd-vm:vm-281-disk-0' is on shared storage 'rbd-vm'2026-11-10 05:56:18 migration finished successfully (duration 00:00:01)real 0m3.636sCon lo storage condiviso un guest spento si sposta in un secondo: cambia solo il nodo che ne possiede la configurazione.
3. Live con dischi locali
Sezione intitolata “3. Live con dischi locali”Una VM di prova (480 migra-locale) clonata dal template su local-zfs, quindi con il disco solo su desopve01:
qm clone 9000 480 --name migra-locale --full 1 --storage local-zfsqm set 480 --ipconfig0 ip=172.27.199.148/24,gw=172.27.199.1 --agent enabled=1 --cicustom vendor=cephfs:snippets/web-vendor.yamlqm start 480Dalla GUI il pulsante Migrate avvisa che serve copiare il disco e chiede lo storage di destinazione.
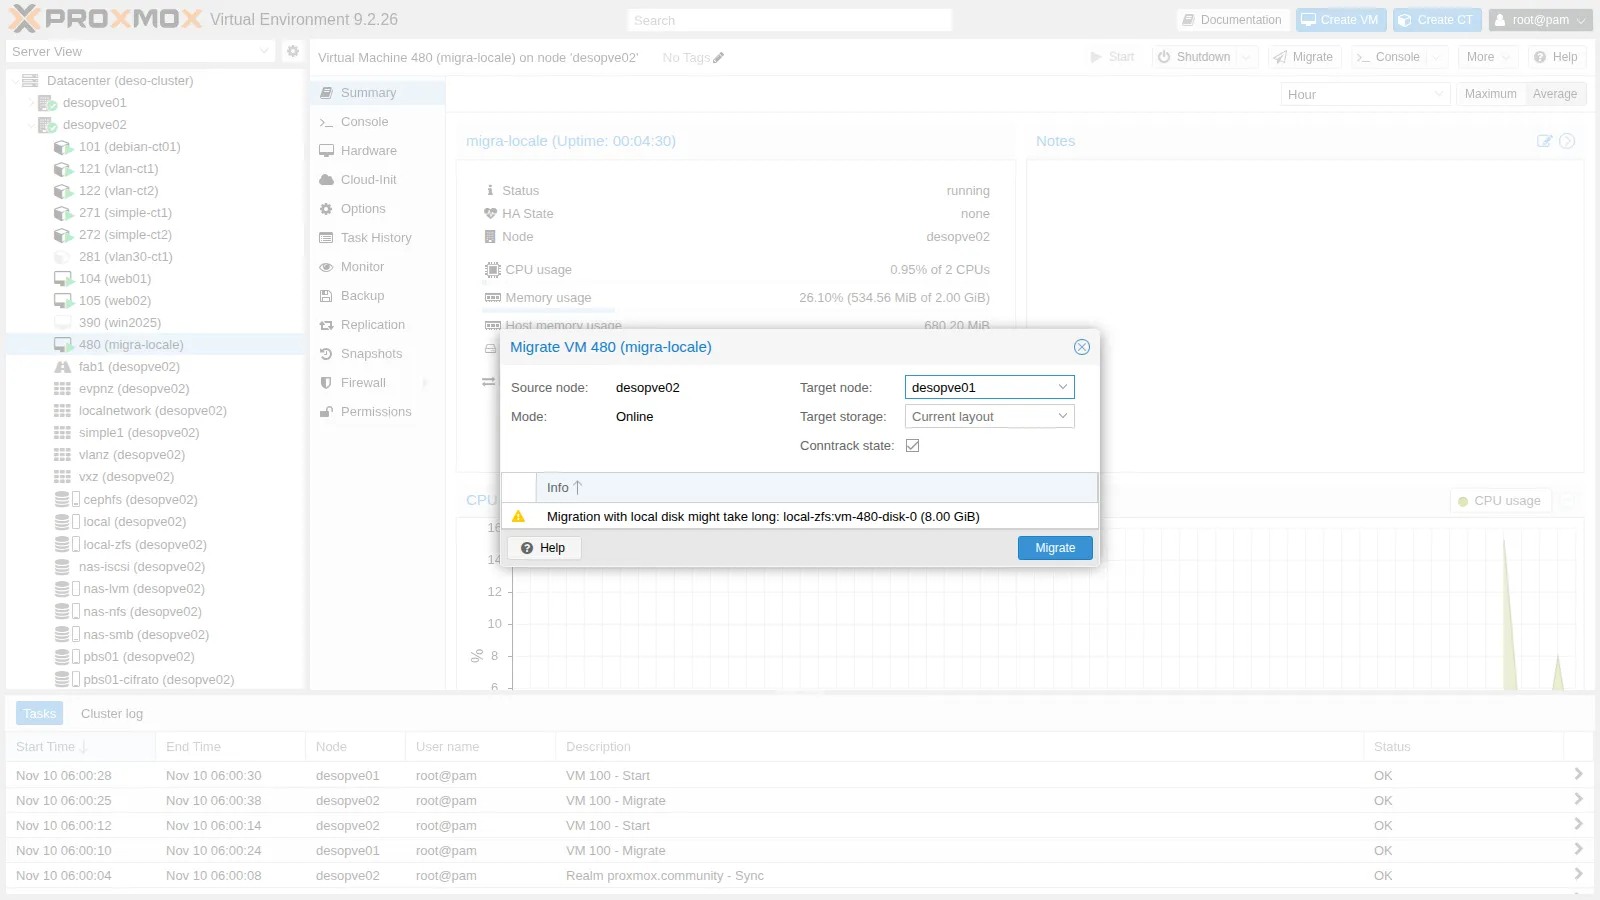
qm migrate 480 desopve02 --online --with-local-disks --targetstorage local-zfs2026-11-10 05:58:03 scsi0: start migration to nbd:unix:/run/qemu-server/480_nbd.migrate:exportname=drive-scsi0mirror-scsi0: successfully switched to actively synced mode2026-11-10 05:58:28 starting online/live migration on unix:/run/qemu-server/480.migrate2026-11-10 05:58:30 average migration speed: 1.0 GiB/s - downtime 88 ms2026-11-10 05:58:30 migration completed, transferred 611.1 MiB VM-statemirror-scsi0: Completed successfully.2026-11-10 05:58:37 migration finished successfully (duration 00:00:45)| Storage condiviso (VM 104) | Disco locale (VM 480) | |
|---|---|---|
| Durata del task | 10 s | 45 s, di cui 25 s per il disco (05:58:03 → 05:58:28 nel log) |
| Fermo riportato da QEMU | 33 ms | 88 ms |
| Pausa massima del ping (uno ogni 0,2 s) | 0,84 s | 3,73 s |
Il disco conteneva solo 653 MiB di dati (thin provisioning), e copiarlo ha richiesto 25 secondi. Il tempo di copia cresce con i dati da copiare, ma questo lab non ha misurato un disco grande: prima di pianificare la migrazione di dischi da centinaia di GB, misura quel tempo sul tuo sistema. Con la replica ZFS (Lab 11) si copia solo la differenza dall’ultima replica: in quel lab la migrazione ha richiesto 20 s invece di 1 min 13 s.
Con il disco locale anche la pausa del ping è più lunga (3,73 s contro 0,84 s), mentre il fermo riportato da QEMU resta sotto i 100 ms. Con una sola prova per caso non si può dire perché. Uno dei passi che precedono la ripresa sulla destinazione, la chiusura del mirror del disco, esiste solo in questo caso; le verifiche sono le stesse del passo 1.
4. Container: restart mode
Sezione intitolata “4. Container: restart mode”Il CT 121 (VLAN 10) viene misurato dal CT 122, che sta nella stessa VLAN:
pct exec 122 -- sh -c "ping -D -i 0.2 10.10.10.121 > /tmp/p121.log &" # sul nodo del CT 122pct migrate 121 desopve02 --restart # sul nodo del CT 1212026-11-10 05:59:03 starting migration of CT 121 to node 'desopve02' (10.100.10.22)2026-11-10 05:59:03 volume 'rbd-vm:vm-121-disk-0' is on shared storage 'rbd-vm'2026-11-10 05:59:04 start container on target node2026-11-10 05:59:09 migration finished successfully (duration 00:00:10)Il task dura 10 s; il ping dal CT 122, uno ogni 0,2 s, ha una pausa massima di 11,65 s. Per un CT “spostare” significa sempre riavviare: i suoi servizi devono tollerare l’interruzione. La documentazione parla, per la migrazione con riavvio, di un fermo normalmente di qualche centinaio di millisecondi; qui la pausa è molto più lunga, e questa prova non la scompone. Comprende almeno l’arresto del CT sull’origine, il suo avvio sulla destinazione (il log mostra l’avvio alle 05:59:04 e la fine del task alle 05:59:09) e il tempo che il CT impiega a rispondere di nuovo in rete. Per verificarlo confronta gli orari che ping -D ha scritto in /tmp/p121.log con il log completo del task, e guarda nel CT quando è salita la sua rete (journalctl -b).
Senza --restart la migrazione di un CT acceso viene rifiutata (“not implemented”, Lab 41).
5. Bulk migration (e la sua trappola)
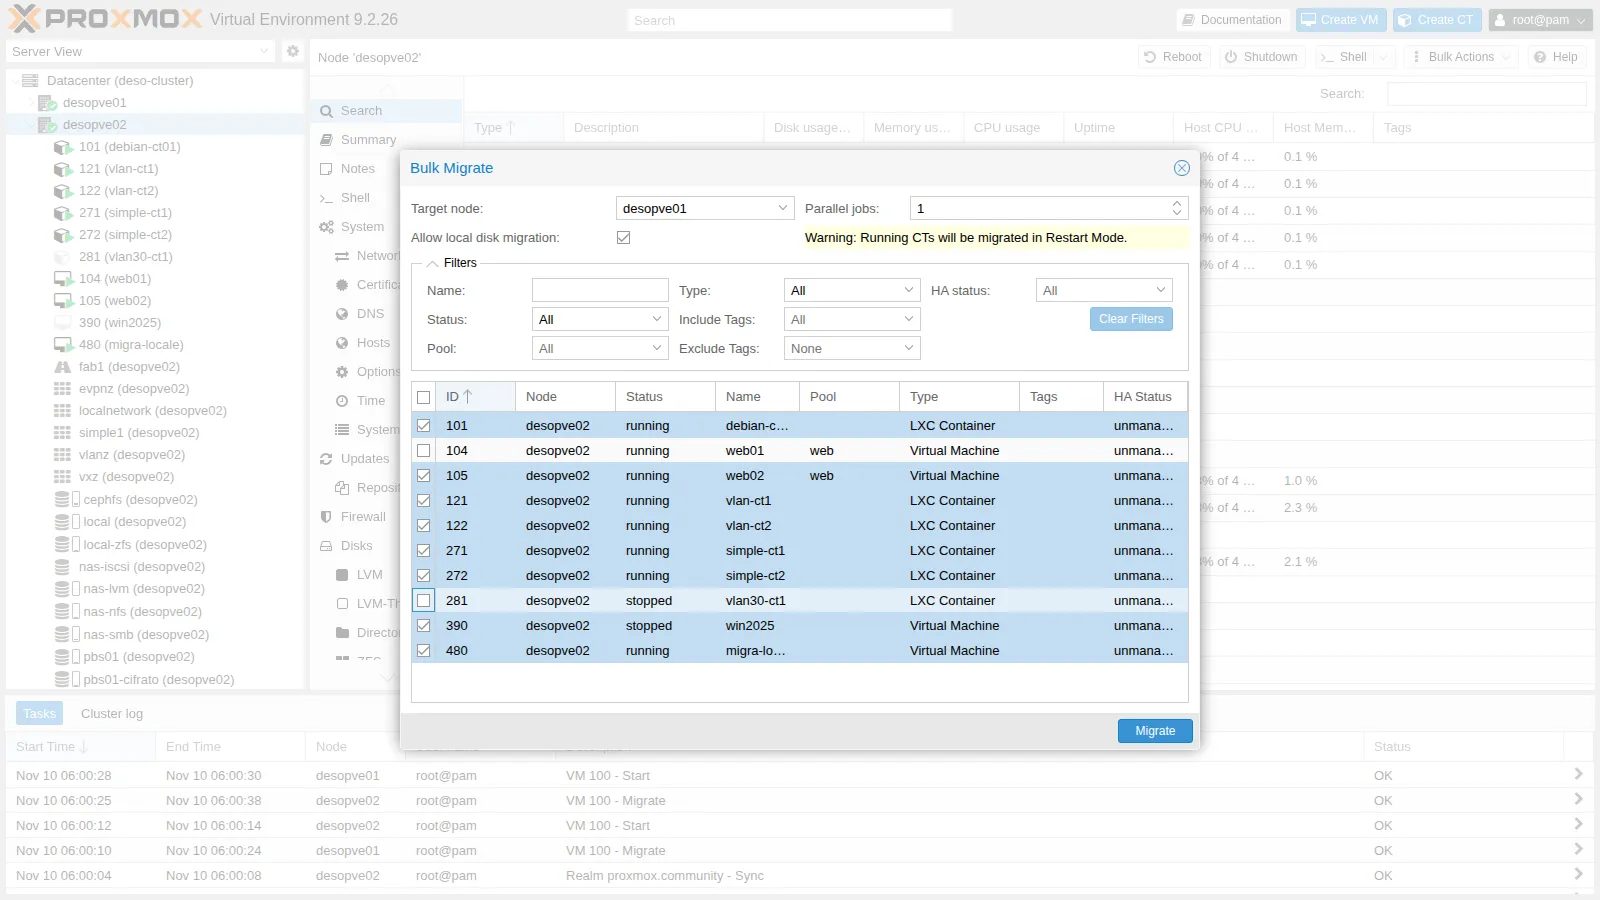
Sezione intitolata “5. Bulk migration (e la sua trappola)”Nodo → Bulk Actions → Bulk Migrate sposta più guest in un colpo, con un numero di lavori in parallelo (Parallel jobs) e l’opzione Allow local disk migration.
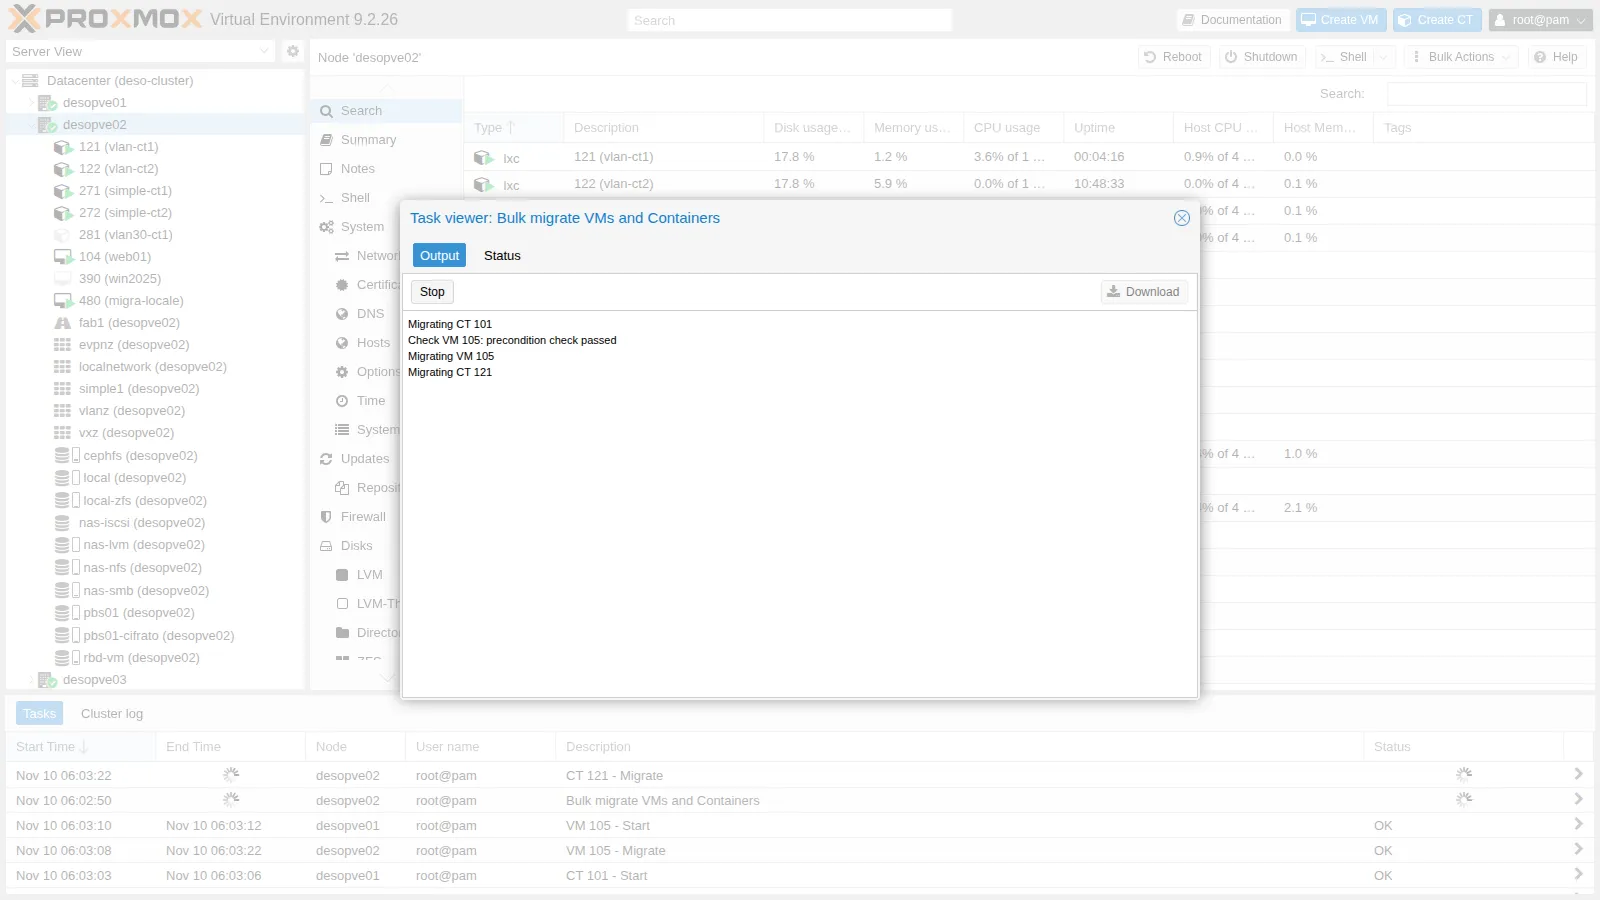
Check VM 105: precondition check passedMigrating VM 105Migrating CT 121Migrating CT 122Migrating CT 271Migrating CT 272Check VM 390: precondition check passedMigrating VM 390Check VM 480: precondition check passedMigrating VM 480All jobs finished, used 8 workers in total.TASK OK8 guest in 137 s con 1 lavoro alla volta. Per rimetterli a posto si usa l’equivalente da CLI, con l’elenco esplicito e 2 lavori in parallelo:
pvesh create /nodes/desopve01/migrateall --target desopve02 --vms 101,105,122,271,272,390 --maxworkers 26 guest in 43 s. Le due prove spostano guest diversi, otto e sei, e solo la prima comprende la VM 480, il cui disco locale va copiato: non isolano l’effetto dei lavori in parallelo. Per misurarlo, sposta lo stesso gruppo di guest con 1 e con 2 lavori.
Prima di confermare una bulk migration, controlla la colonna di selezione oppure usa i filtri (stato, pool, tag).
6. Secure contro insecure
Sezione intitolata “6. Secure contro insecure”La VM 100 ha 2 GiB di RAM. Per rendere la prova significativa, dentro il guest si riempie la RAM con 900 MiB di dati casuali, non comprimibili:
qm guest exec 100 -- sh -c "dd if=/dev/urandom of=/dev/shm/riempi bs=1M count=900"qm migrate 100 desopve02 --online --migration_type secureqm migrate 100 desopve01 --online --migration_type insecure # dal nodo 02== insecure 100 02->012026-11-10 05:59:59 starting online/live migration on tcp:10.100.10.21:600002026-11-10 06:00:04 average migration speed: 413.0 MiB/s - downtime 21 ms2026-11-10 06:00:04 migration completed, transferred 1.1 GiB VM-state| Prova | average migration speed (log) |
Durata del task |
|---|---|---|
| secure | 413 MiB/s | 14 s |
| insecure | 413 MiB/s | 14 s |
| secure (ripetuta) | 413 MiB/s | 14 s |
| insecure (ripetuta) | 688 MiB/s | 12 s |
I valori vengono dalla riga average migration speed dei log dei task, e tre prove su quattro hanno dato proprio 413 MiB/s. Come spiegato in Come funziona, quel valore è la RAM del guest divisa per la durata della fase di memoria in secondi interi: con circa 2 GiB di RAM, 413 MiB/s corrispondono a 5 secondi e 688 MiB/s a 3 secondi. Tre valori uguali sono quindi tre fasi di memoria della stessa durata, arrotondata al secondo, non tre velocità uguali.
- Che cosa mostra la prova: con 1,1 GiB di memoria da trasferire, la fase di memoria dura 3-5 secondi e il task intero 12-14 secondi, in entrambe le modalità. Con questa risoluzione non si vede una differenza netta tra secure e insecure, e la prova non dice se a limitare il trasferimento sia la rete o la cifratura.
- Che cosa dice la documentazione: la cifratura richiede molta potenza di calcolo, e l’effetto si vede soprattutto sulle reti veloci, da 10 Gbit/s in su; è minore sulle CPU che implementano AES in hardware. La migrazione dei dischi usa sempre il canale cifrato, qualunque sia l’impostazione.
- Come verificarlo sul tuo sistema: migra una VM con molta più memoria in uso, così che la fase di memoria duri minuti; leggi la banda effettiva sull’interfaccia di migrazione, per esempio dai contatori di byte di
ip -s link show vmbr1.100prima e dopo; durante una migrazione secure osserva l’uso di CPU del processosshsul nodo di origine (top); misura la sola rete coniperf3tra due nodi sulla VLAN 100.
In insecure la destinazione apre la porta 60000: il firewall deve permetterla sulla rete di migrazione (gruppo servizi-cluster, Lab 33).
7. Migrazione tra cluster: qm remote-migrate
Sezione intitolata “7. Migrazione tra cluster: qm remote-migrate”Destinazione: desopve04, che è un “datacenter” separato con il suo local-lvm e il pool ZFS tank.
Sul nodo di destinazione si crea un token e si legge l’impronta del certificato:
pveum user token add root@pam migra --privsep 0 --comment "migrazione remota dal cluster"pvenode cert info | grep -B1 -A1 pve-ssl.pemIl token deve poter creare VM, allocare storage e usare il bridge sulla destinazione. Qui si usa root@pam senza separazione dei privilegi; in produzione conviene un utente dedicato.
Primo tentativo: verso local-lvm.
qm remote-migrate 480 480 \ 'host=172.27.199.24,apitoken=PVEAPIToken=root@pam!migra=<segreto>,fingerprint=84:D3:F2:…' \ --target-bridge vmbr0 --target-storage local-lvm --onlineERROR: … failed to handle 'disk-import' command - no matching import/export format found for storage 'local-lvm'migration abortedErrore osservato. Il log mostra che a fallire è il disco di cloud-init (ide2, su local-zfs). Il disco principale, collegato alla VM accesa, viene copiato a caldo con il mirror NBD; il disco di cloud-init invece passa da un export/import dello storage. In questa combinazione (origine ZFS, destinazione LVM-thin, PVE 9.2) l’origine lo offriva solo nel formato zfs, che LVM-thin non importa. Non è una regola generale: dipende dai formati che i due storage hanno in comune. Il lab 53 incontra lo stesso errore dalla GUI di PDM e mostra come verificarlo.
Decisione. Usare uno storage ZFS anche sulla destinazione, tank, così che il formato zfs sia comune ai due storage.
Secondo tentativo: verso tank (ZFS).
ERROR: … failed to handle 'config' command - storage 'cephfs' does not existmigration abortedErrore osservato. La configurazione della VM cita uno snippet su cephfs (cicustom), uno storage che sulla destinazione non esiste.
Decisione. Lo snippet serviva solo al primo avvio: si toglie il riferimento e si riprova con le stesse opzioni.
qm set 480 --delete cicustomTerzo tentativo, riuscito:
2026-11-10 06:08:35 start migrate command to unix:/run/qemu-server/480.migratetunnel: established new WS for forwarding '/run/qemu-server/480.migrate'2026-11-10 06:08:38 average migration speed: 682.9 MiB/s - downtime 31 ms2026-11-10 06:08:38 migration completed, transferred 624.6 MiB VM-statemirror-scsi0: Completed successfully.2026-11-10 06:08:41 migration finished successfully (duration 00:00:52)Risultato. Il task termina in 52 secondi, con un fermo di 31 ms riportato da QEMU. La pausa massima del ping è di 3,11 s, anche qui molto più lunga del fermo: il passo 1 elenca le spiegazioni possibili e le verifiche. Dopo la migrazione la pagina web della VM risponde dall’altro “datacenter”.
Sul cluster la VM resta, spenta e bloccata (lock: migrate): per default remote-migrate non cancella l’originale. Si elimina a mano dopo aver verificato la copia:
qm unlock 480 && qm destroy 480 --purgeRitorno al cluster, eseguito su desopve04 con un token del cluster e --delete 1, che cancella l’origine a fine migrazione. Il token e l’impronta si preparano su desopve01:
pveum user token add root@pam rientro --privsep 0 --comment "rientro dalla migrazione remota"pvenode cert info | grep -B1 -A1 pve-ssl.pemPoi su desopve04:
qm remote-migrate 480 480 \ 'host=172.27.199.21,apitoken=PVEAPIToken=root@pam!rientro=<segreto>,fingerprint=14:32:84:…' \ --target-bridge vmbr0 --target-storage local-zfs --online --delete 12026-11-10 06:10:46 average migration speed: 682.9 MiB/s - downtime 62 ms2026-11-10 06:10:46 migration completed, transferred 626.2 MiB VM-state2026-11-10 06:10:50 migration finished successfully (duration 00:00:32)Il ritorno dura 32 secondi, con un fermo di 62 ms riportato da QEMU, e su desopve04 la VM non c’è più.
Limiti di remote-migrate visti nel lab:
- solo CLI ed etichettato come sperimentale;
- servono token, impronta e permessi sulla destinazione;
- le configurazioni che citano storage, snippet o bridge assenti sulla destinazione falliscono;
- i dischi non migrati a caldo (cloud-init, VM spente) richiedono formati di export compatibili tra gli storage;
- l’origine resta per default; con
--delete 1sparisce.
8. Ripristino
Sezione intitolata “8. Ripristino”A fine lab rimetti i guest al loro posto. La VM 104 è già tornata su desopve01 con la prova del conntrack, e il CT 121 con la bulk migration; restano il CT 281, la VM 480 tornata dal “datacenter” remoto e i token:
pct migrate 281 desopve01 # su desopve02 (il CT è spento)qm stop 480 && qm destroy 480 --purge # su desopve01pveum user token remove root@pam rientro # su desopve01pveum user token remove root@pam migra # su desopve04Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se ogni migrazione termina con migration finished successfully (la bulk migration con TASK OK), se ogni guest risponde sulla sua destinazione e se, dopo la migrazione tra cluster, l’origine è stata eliminata a ragion veduta.
| Prova | Criterio di successo | Risultato nel lab |
|---|---|---|
| Live, storage condiviso (VM 104) | VM accesa e raggiungibile sulla destinazione | task 10 s; fermo riportato da QEMU 33 ms; pausa massima del ping 0,84 s |
| Offline, storage condiviso (CT 281) | si sposta solo la configurazione | task 1 s |
| Live, disco locale (VM 480, 8 GiB thin) | disco copiato, VM raggiungibile sulla destinazione | task 45 s, di cui 25 s per il disco; fermo 88 ms; pausa massima del ping 3,73 s |
| CT in restart mode (CT 121) | CT acceso sulla destinazione | task 10 s; pausa massima del ping vista dal CT 122: 11,65 s |
| Bulk migration | migrati solo i guest selezionati | 8 guest in 137 s con 1 lavoro alla volta; altri 6 guest in 43 s con 2 |
| secure contro insecure | entrambe le modalità funzionano sulla VLAN 100 | task da 12-14 s; average migration speed 413-688 MiB/s, cioè fasi di memoria da 3-5 s |
Remote-migrate verso desopve04 |
VM accesa sulla destinazione, origine spenta e bloccata | dopo 2 errori: task 52 s; fermo 31 ms; pausa massima del ping 3,11 s |
Remote-migrate di ritorno con --delete 1 |
VM di nuovo sul cluster, origine eliminata | task 32 s; fermo 62 ms |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Guest di nuovo nella posizione iniziale:
- VM 100, 104 e 261 e CT 121, 141, 143, 281, 291, 301 su
desopve01; - CT 101, 122, 271, 272, VM 105 e 390 su
desopve02; - VM 106 e CT 123, 282, 292, 302 su
desopve03.
- VM 100, 104 e 261 e CT 121, 141, 143, 281, 291, 301 su
- VM di prova 480 eliminata; nessun residuo su
desopve04. - Token
root@pam!migra(sudesopve04) eroot@pam!rientro(sul cluster) rimossi. - Datacenter:
migration: secure,network=10.100.10.0/24, invariato. - PBS e i job del Lab 47 invariati.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Come stimare la finestra di una migrazione. Con lo storage condiviso si sposta solo la memoria: qui 10 secondi di task e 33 ms di fermo riportato da QEMU. Con i dischi locali si copia prima il disco, e il tempo cresce con i suoi dati; la replica ZFS (Lab 11) lo riduce. Un container si riavvia sempre: va messa in conto un’interruzione del servizio, 11,65 secondi in questo lab.
- Come leggere il fermo di una migrazione. Il fermo del task, la pausa vista da un client e la
average migration speedsono cose diverse: il primo lo misura QEMU, la seconda richiede uno strumento con una risoluzione adeguata, la terza non è una velocità misurata. Una pausa di secondi, come i 3,73 s con il disco locale, va verificata prima di attribuirle una causa. - Quando conviene insecure. Solo su una rete dedicata e fidata, e solo se una misura sul tuo hardware mostra che il collo di bottiglia è la cifratura: la prova di questo lab non permetteva di dirlo. Il firewall deve aprire le porte 60000-60050.
- Come avviare una bulk migration senza sorprese. La finestra preseleziona tutti i guest: controlla la selezione prima di confermare.
- Cosa controllare prima di una migrazione tra cluster. Storage con un formato di export in comune per i dischi che non si copiano a caldo, le risorse citate dalla configurazione (snippet, ISO, storage), i permessi del token e la sorte dell’origine: resta, spenta e bloccata, se non si usa
--delete 1. - Se migrare lo stato del conntrack. È una novità della 9.x, funziona in modalità best-effort e serve ai guest con il firewall attivo.
Riferimenti
Sezione intitolata “Riferimenti”- Proxmox VE – Migration (qm)
- Proxmox VE – Migrazione dello stato del conntrack
- Proxmox VE – Migrazione dei container e restart mode
- Proxmox VE – Migrazione dei guest: tipo (secure/insecure) e rete
- Proxmox VE – qm(1), remote-migrate
- Codice sorgente di Proxmox VE –
QemuMigrate.pm: come il log calcola laaverage migration speede quando la VM riprende sulla destinazione