

Lab 13 – Storage NFS: condivisione, prestazioni e caduta del NAS
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti: Lab 12 per il NAS
desonascon il datasetdati/nfs, e Lab 08 per i tipi di storage e di contenuto. - Cluster:
deso-clustercon i tre nodi (lab 06). La VM 100debian01è accesa sudesopve01con il disco sulocal-zfs(lab 07, stato del lab 11). - Rete: i nodi raggiungono
172.27.199.10sulla LAN del laboratorio. - Credenziali:
root/<password-lab>sui nodi,truenas_admin/<password-lab>sul NAS → Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Una condivisione NFS del dataset
dati/nfssu TrueNAS, limitata alla rete del laboratorio e con root non schiacciato, che i nodi vedono conpvesm scan nfserpcinfo. - Lo storage
nas-nfsmontato in NFS 4.2 su tutti i nodi, con le opzioni effettive del mount (hard,timeo,retrans) lette damount. - Il disco di una VM accesa spostato su NFS e riportato sullo storage locale senza fermarla.
- Un confronto tra storage locale e NFS fatto con dati casuali e più ripetizioni, sapendo quale strumento e quale livello misura ogni numero.
- Il comportamento di nodi e VM con il NAS fermo osservato e descritto: storage inattivo, processi in stato
D, VM in attesa, ripresa al ritorno del servizio.
Come funziona
Sezione intitolata “Come funziona”NFS in Proxmox VE
Sezione intitolata “NFS in Proxmox VE”NFS (Network File System) condivide una cartella del server via rete. Proxmox VE la monta su ogni nodo in /mnt/pve/<ID> e la tratta come uno storage di tipo directory, ma condiviso: tutti i nodi vedono gli stessi file.
desonas (TrueNAS) desopve01 / 02 / 03 /mnt/dati/nfs ── NFS 4.2 su TCP ──▶ /mnt/pve/nas-nfs ├── images/100/vm-100-disk-0.qcow2 dischi delle VM ├── template/iso/ ISO ├── template/cache/ template dei container └── dump/ backup- Su uno storage di tipo file i dischi delle VM sono file
rawoqcow2. Conqcow2gli snapshot si fanno anche su NFS. - Lo storage è condiviso (
shared): una VM con il disco su NFS si migra copiando solo la memoria, e con l’alta disponibilità (lab 49) può ripartire su un altro nodo. - Proxmox VE accede ai file come root. Sul server l’export non deve quindi «schiacciare» root sull’utente
nobody(root squash), altrimenti la creazione dei dischi fallisce per permessi. In TrueNAS si imposta con Maproot Userroot. - Il mount è
hard(il predefinito): se il server non risponde, le operazioni restano in attesa e riprendono quando torna, senza errori verso le applicazioni. Consoftil client restituirebbe un errore dopo i tentativi, enfs(5)avverte che questo può corrompere i dati senza che nessuno se ne accorga: per i dischi delle VM non si usa. La documentazione di Proxmox VE lo suggerisce solo per contenuti in sola lettura, come le ISO.
Versioni
Sezione intitolata “Versioni”| Versione | Caratteristiche |
|---|---|
| NFSv3 | senza stato sul server, porte aggiuntive (mountd, lockd, statd) |
| NFSv4.x | una sola porta TCP (2049), lock integrati, sessioni |
| NFSv4.2 | in più: copia lato server, file sparsi (hole punching), allocazione dello spazio |
Nel laboratorio usiamo NFS 4.2, impostato nelle opzioni di mount dello storage.
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Le misure e il test di caduta di questo lab vengono da una prova eseguita a novembre 2026 (il test di caduta il 9 novembre, come mostrano i log), nella configurazione descritta qui sotto. Con versioni, opzioni o hardware diversi, gli stessi comandi danno numeri diversi.
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04); nodo desopve01 con 4 core e 32 GB di RAM (Lab 01) |
| NAS | TrueNAS Community Edition 25.10.8 (Lab 12), 4 core e 16 GB di RAM, pool dati in mirror su due dischi da 100 GB, dataset dati/nfs; una scheda di rete sulla LAN del laboratorio |
| Mount NFS | NFS 4.2 su TCP, rsize e wsize da 1 MiB, hard, timeo=600, retrans=2 (output di mount al passo 3) |
| Rete | LAN di gestione 172.27.199.0/24, MTU 1500 (Lab 21) |
| VM di prova | VM 100 debian01, Debian 13.7, 2 core, 2 GiB di RAM, disco scsi0 da 16 GiB con iothread=1 e cache predefinita (none) (Lab 07): prima su local-zfs (zvol raw), poi su nas-nfs (file qcow2) |
| Storage locale | local-zfs per il disco della VM e local (/var/lib/vz) per fio dal nodo, entrambi sul pool ZFS in mirror dei due dischi di sistema (Lab 03) |
| Strumenti | dd nella VM; fio sul nodo, dal repository di Debian (versione non registrata in questo lab) |
I modelli dei dischi sono oscurati, come indicato nelle convenzioni del manuale.
Cosa misura e cosa non misura. I dd nella VM misurano il percorso visto dal guest: il kernel della VM, il disco virtuale, QEMU e poi lo ZFS locale, oppure il client NFS, la rete e il NAS. fio sul nodo misura invece il file system del nodo: per lo storage locale un file nel dataset ZFS di sistema, per NFS il client NFS del kernel, la rete e il NAS, senza VM e senza le opzioni di cache dei dischi virtuali. Nessuna delle due prove isola i singoli livelli. I file di prova, da 512 MiB e da 1 GiB, sono piccoli rispetto alla RAM del nodo e del NAS, quindi le letture possono arrivare dalle cache (ARC). Le ripetizioni sono due o tre, e l’attività del resto del laboratorio durante le prove non è stata registrata: i valori danno un ordine di grandezza, non una statistica.
Procedura
Sezione intitolata “Procedura”1. La condivisione su TrueNAS
Sezione intitolata “1. La condivisione su TrueNAS”-
Sul NAS: Shares → NFS → Add.
-
Path
/mnt/dati/nfs, DescriptionStorage Proxmox VE. In Networks premi Add e scrivi172.27.199.0/24: solo la rete del laboratorio potrà montare la condivisione. -
Apri Advanced Options e imposta Maproot User
roote Maproot Groupwheel.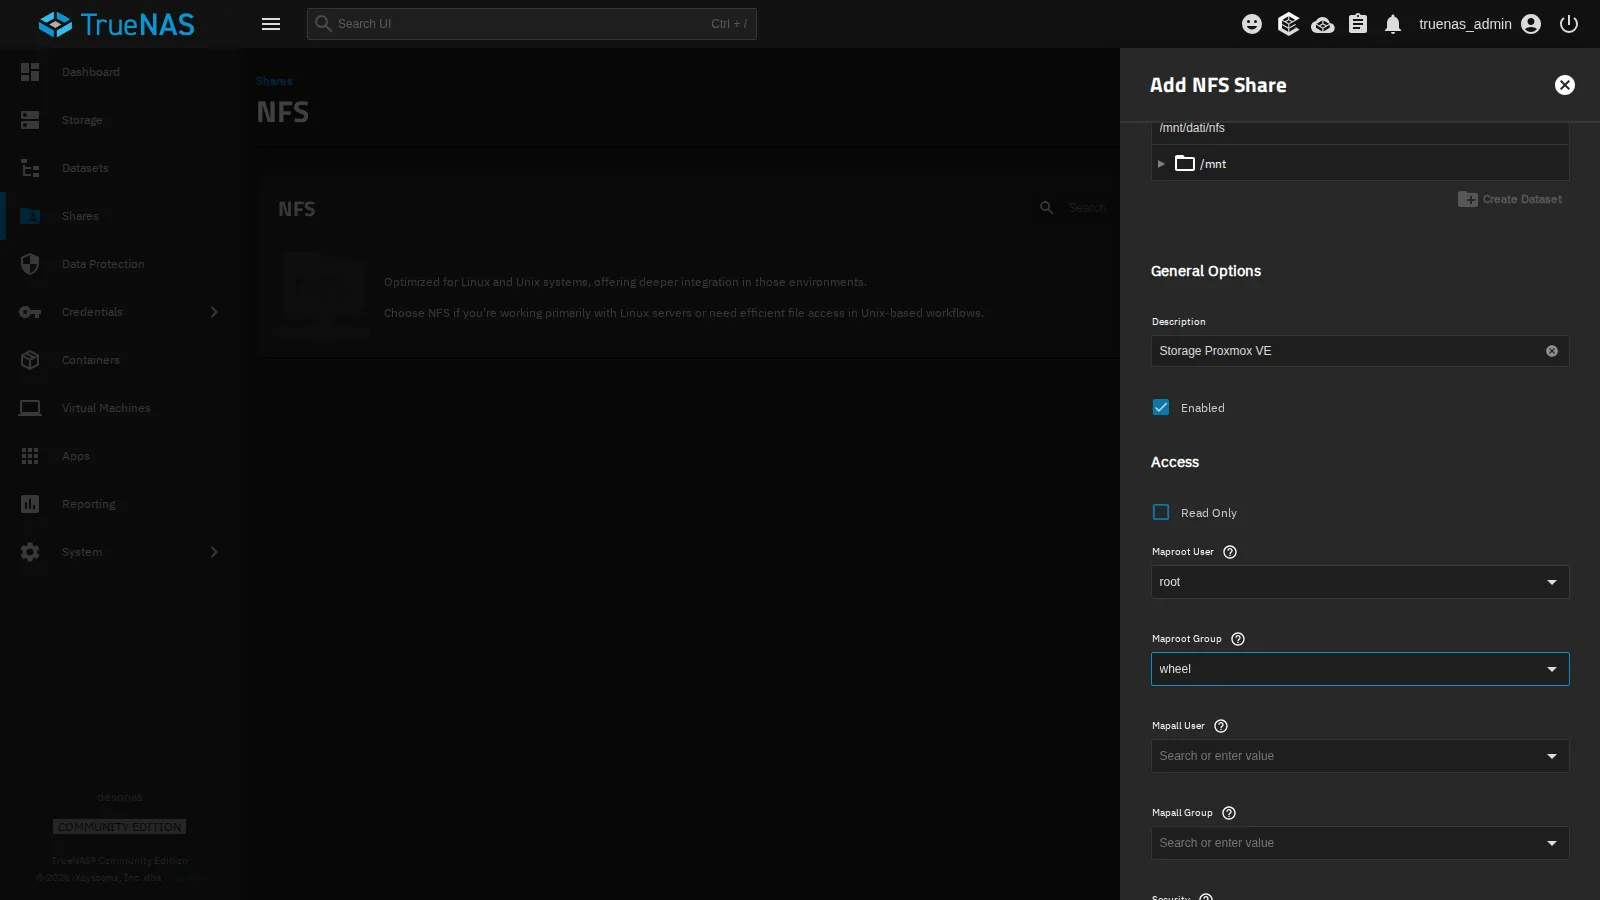
-
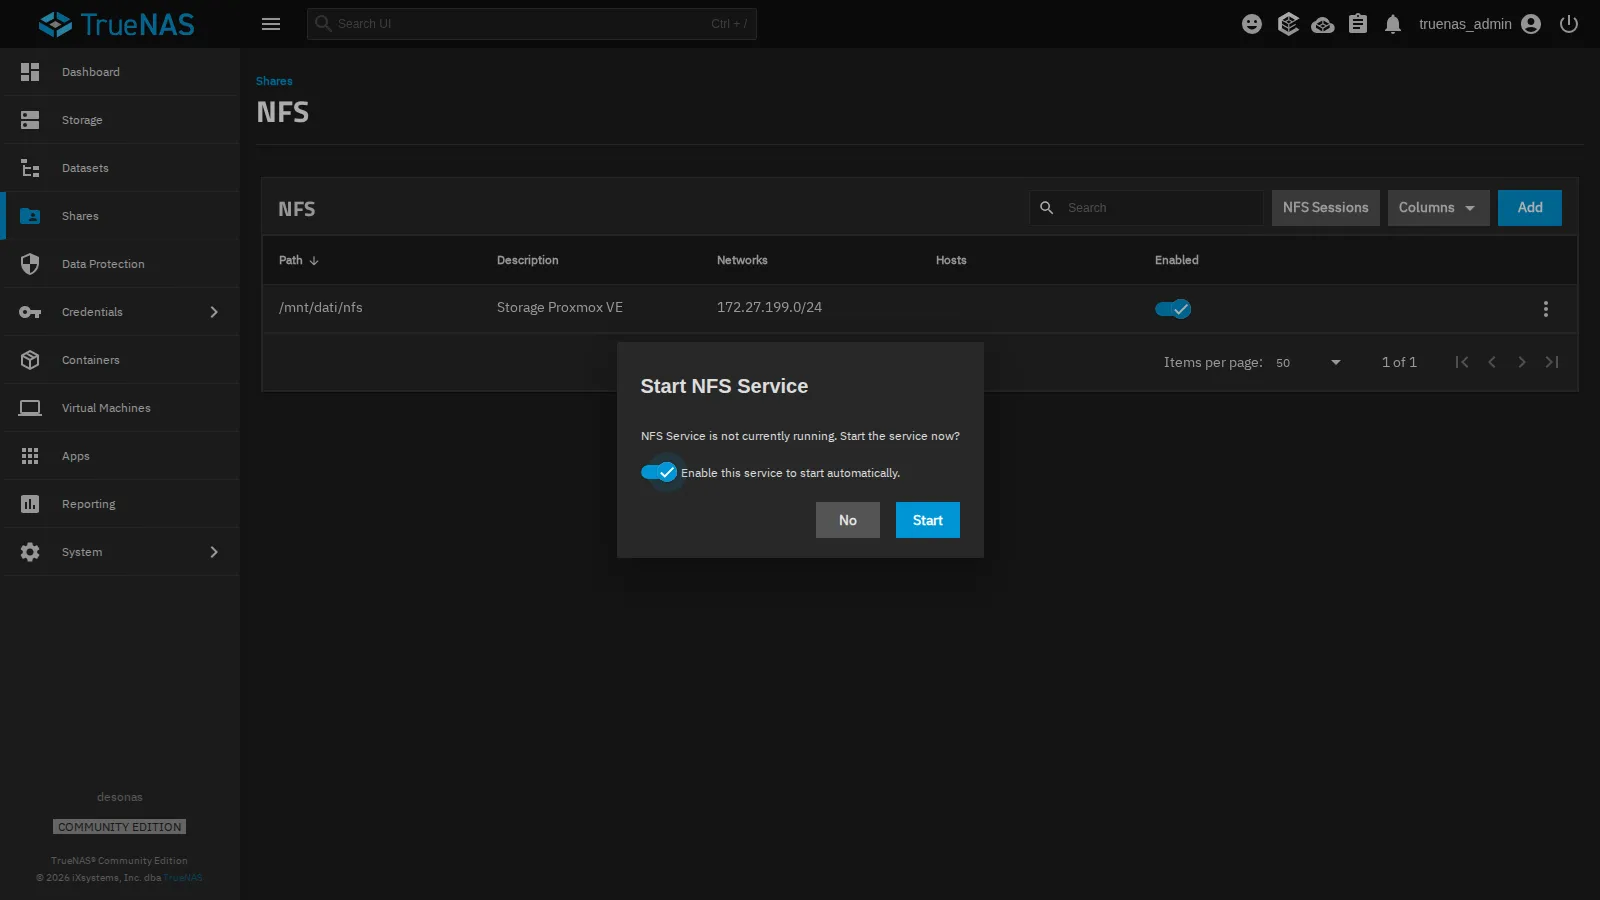
Save. TrueNAS propone di avviare il servizio NFS: lascia attivo Enable this service to start automatically e premi Start.
-
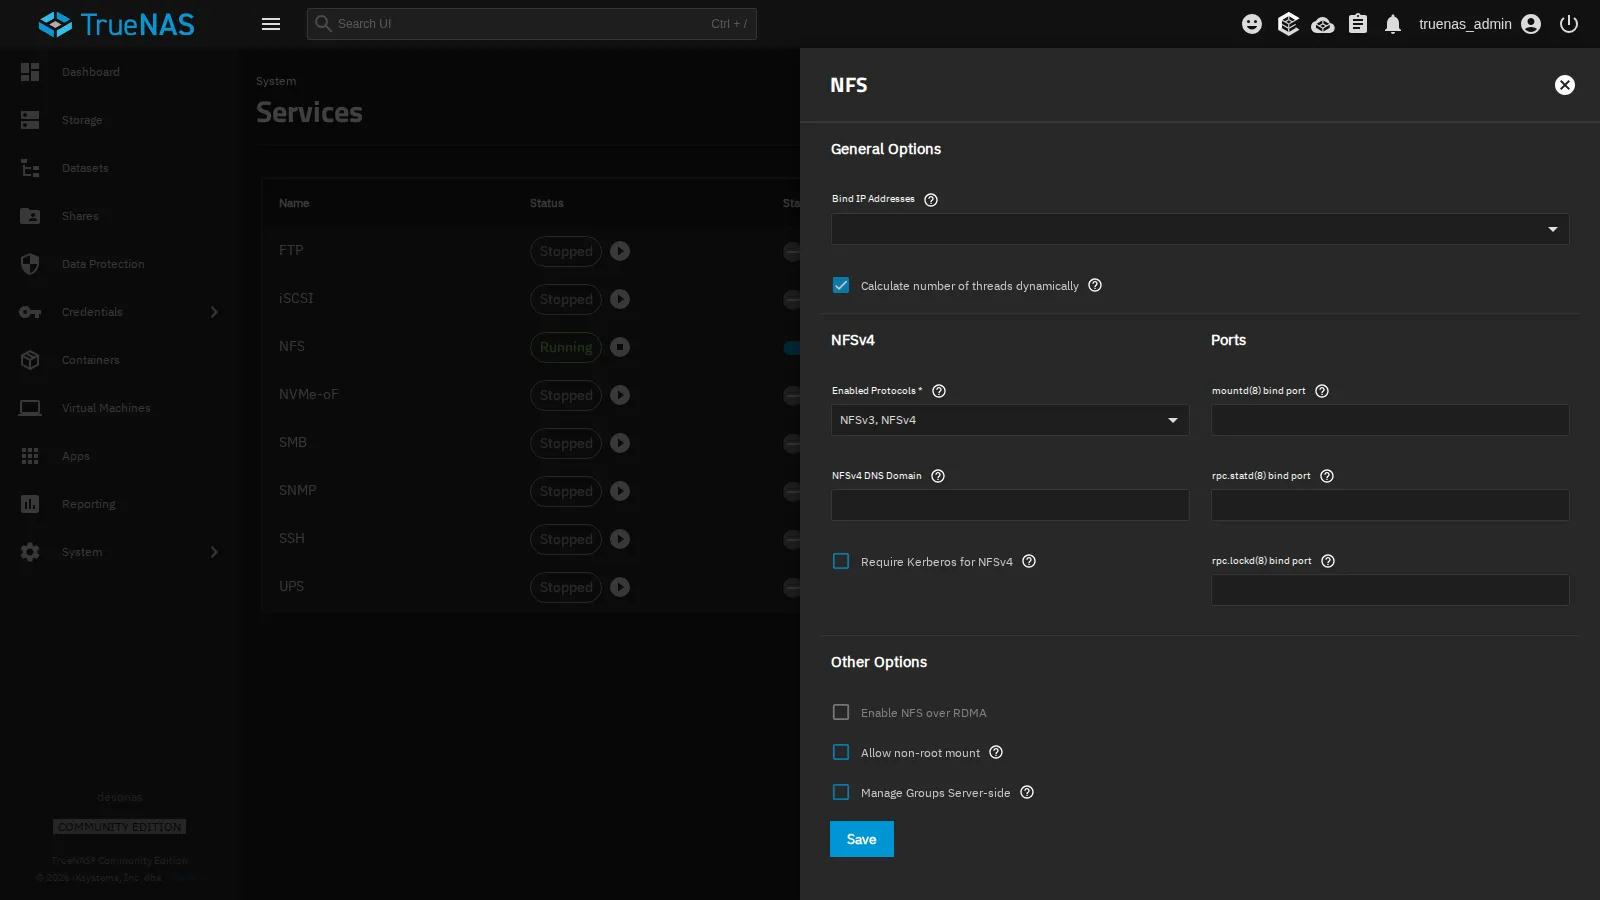
In System → Services → NFS (icona della matita) le impostazioni del servizio confermano che sono attivi NFSv3 e NFSv4. Non serve cambiare altro.
2. Verificare l’export dai nodi
Sezione intitolata “2. Verificare l’export dai nodi”Prima di aggiungere lo storage, controlla dal nodo che il server esporti la cartella e risponda in NFSv4:
pvesm scan nfs 172.27.199.10/mnt/dati/nfs 172.27.199.0/24rpcinfo -T tcp 172.27.199.10 nfs 4program 100003 version 4 ready and waiting3. Aggiungere lo storage al cluster
Sezione intitolata “3. Aggiungere lo storage al cluster”-
Datacenter → Storage → Add → NFS.
-
Compila:
- ID
nas-nfs; - Server
172.27.199.10. L’indirizzo IP evita che lo storage dipenda dal DNS: se il DNS si ferma, lo storage continua a funzionare; - Export
/mnt/dati/nfs, che il menu propone dopo aver interrogato il server; - Content:
Disk image,ISO image,Container template,Backup; - Nodes: tutti.
- ID
-
Spunta Advanced in basso e scegli NFS Version
4.2. Lascia disattivato Allow Snapshots as Volume-Chain, un’anteprima tecnologica che vedrai nel lab 16.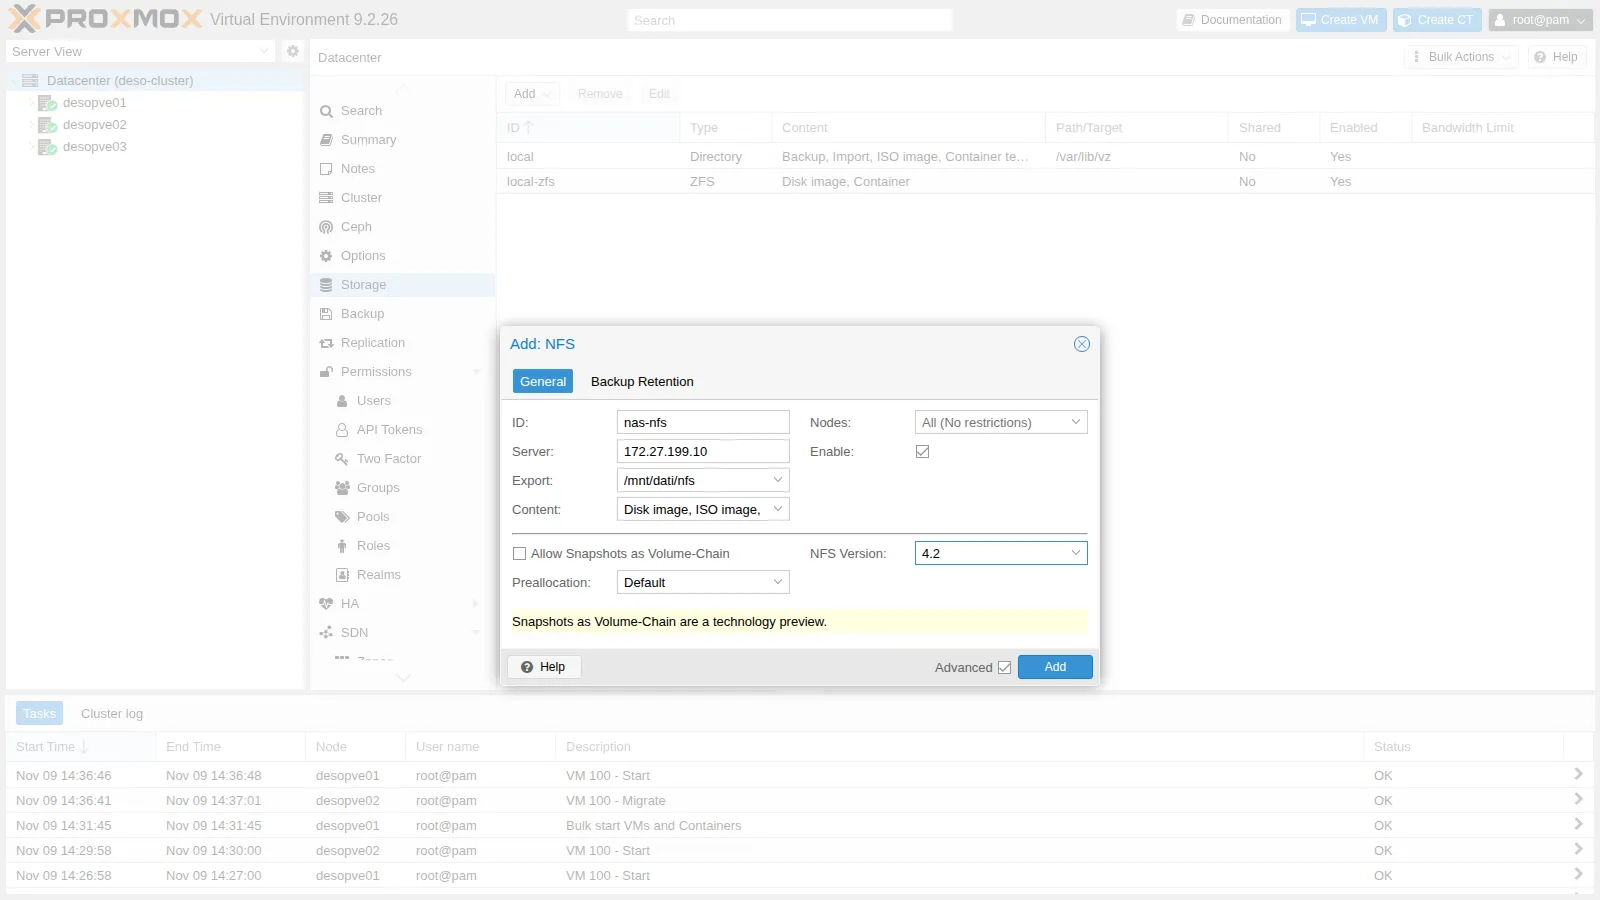
-
Add. Lo storage compare nell’elenco, condiviso (Shared
Yes) e attivo: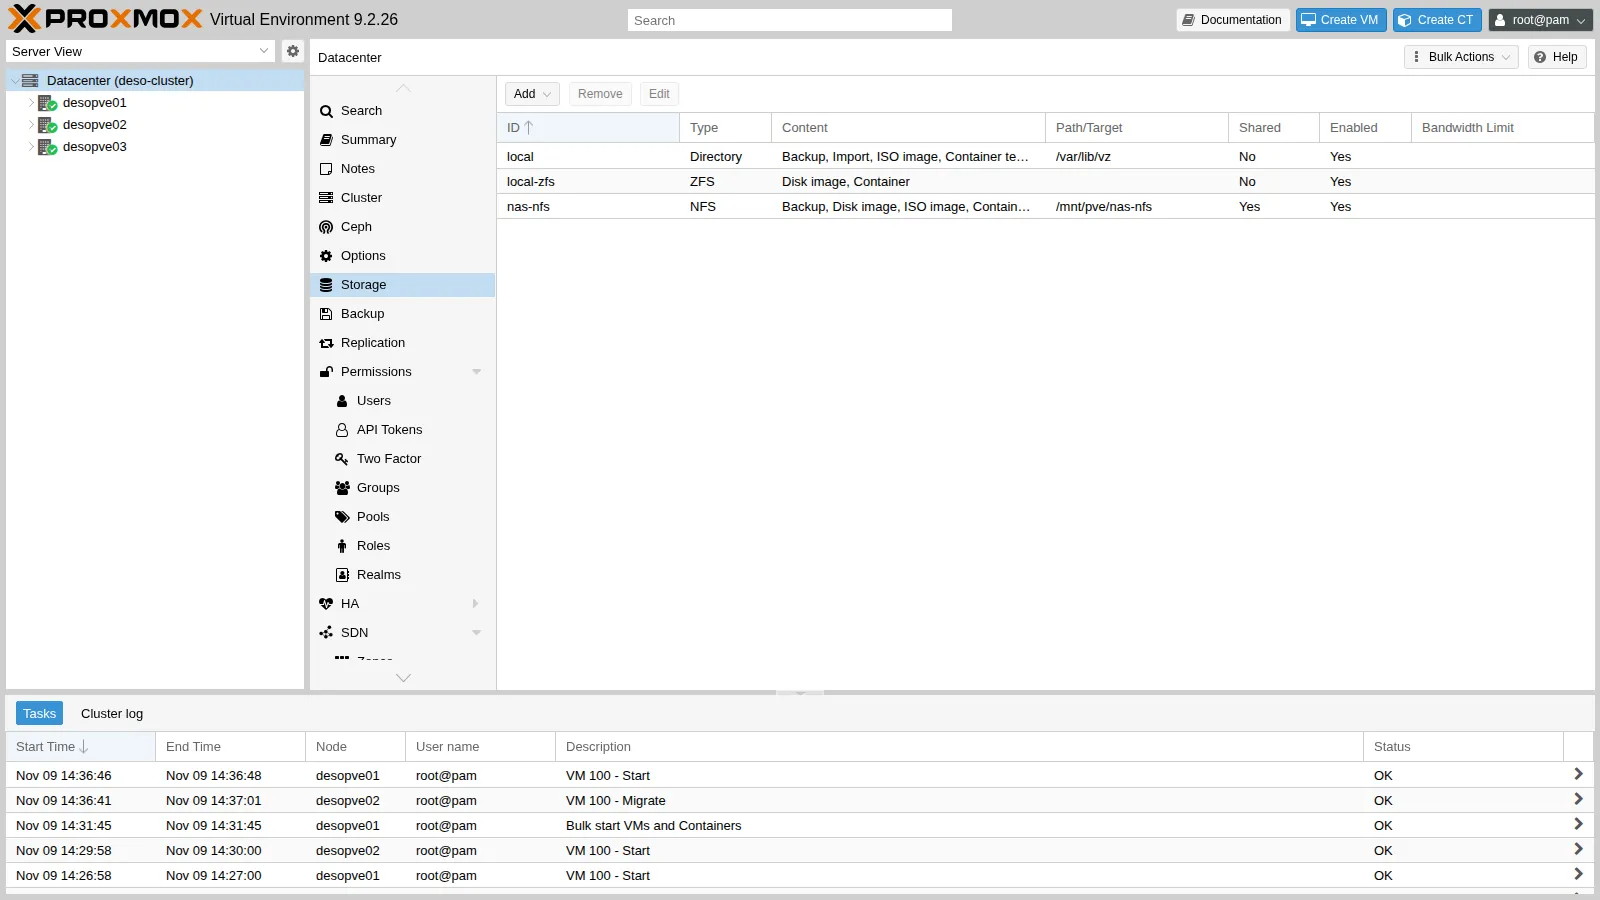
Da riga di comando:
grep -A6 "nfs: nas-nfs" /etc/pve/storage.cfgnfs: nas-nfs export /mnt/dati/nfs path /mnt/pve/nas-nfs server 172.27.199.10 content images,iso,backup,vztmpl options vers=4.2 prune-backups keep-all=1pvesm status | grep nas-nfsnas-nfs nfs active 100070400 0 100070400 0.00%mount | grep nas-nfs172.27.199.10:/mnt/dati/nfs on /mnt/pve/nas-nfs type nfs4 (rw,relatime,vers=4.2,rsize=1048576,wsize=1048576,namlen=255,hard,fatal_neterrors=none,proto=tcp,timeo=600,retrans=2,sec=sys,clientaddr=172.27.199.21,local_lock=none,addr=172.27.199.10)ssh desopve03 ls /mnt/pve/nas-nfsdumpimagestemplatepvestatdmonta lo storage da solo su ogni nodo, nella cartella/mnt/pve/nas-nfs, e crea le sottocartelle per i contenuti scelti.- Le opzioni di mount mostrano
hard,timeo=600(60 secondi prima di ritentare una richiesta) eretrans=2. - La capacità è quella del pool
datidel NAS: circa 95 GiB.
4. Misurare le prestazioni con il disco locale
Sezione intitolata “4. Misurare le prestazioni con il disco locale”Prima di spostare il disco, misura come va con lo storage locale: sono i valori di confronto per NFS. Il disco della VM 100 è su local-zfs.
Un test che inganna. Nella VM scrivi 1 GiB di zeri con dd:
dd if=/dev/zero of=$HOME/test.bin bs=1M count=1024 oflag=direct1073741824 bytes (1.1 GB, 1.0 GiB) copied, 1.40965 s, 762 MB/sLo ripeterai su NFS al passo 6, e lì vedrai perché gli zeri non servono a misurare.
Scritture e letture sequenziali con dati casuali. Genera 512 MiB casuali in RAM (/dev/shm), scrivili sul disco in modo diretto aspettando che arrivino davvero allo storage (oflag=direct conv=fsync), poi rileggili. Ripeti la scrittura tre volte e la lettura due, perché un solo valore non basta:
head -c 512M /dev/urandom > /dev/shm/rnd.binfor i in 1 2 3; do dd if=/dev/shm/rnd.bin of=$HOME/test.bin bs=1M oflag=direct conv=fsync 2>&1 | tail -1; done536870912 bytes (537 MB, 512 MiB) copied, 15.0205 s, 35.7 MB/s536870912 bytes (537 MB, 512 MiB) copied, 5.48904 s, 97.8 MB/s536870912 bytes (537 MB, 512 MiB) copied, 16.7323 s, 32.1 MB/sfor i in 1 2; do dd if=$HOME/test.bin of=/dev/null bs=1M iflag=direct 2>&1 | tail -1; done536870912 bytes (537 MB, 512 MiB) copied, 0.737017 s, 728 MB/s536870912 bytes (537 MB, 512 MiB) copied, 0.620782 s, 865 MB/srm -f $HOME/test.bin /dev/shm/rnd.binScritture casuali a blocchi da 4 KiB, il carico tipico di database e sistemi operativi, misurate con fio direttamente dal nodo sullo storage local (/var/lib/vz, nel dataset ZFS di sistema): qui la VM non c’è, si misura il file system del nodo. L’opzione --unlink=1 cancella il file di prova alla fine:
apt install fiofio --name=rw4k --directory=/var/lib/vz --rw=randwrite --bs=4k --size=1G \ --iodepth=16 --ioengine=libaio --direct=1 --runtime=30 --time_based --group_reporting --unlink=1 write: IOPS=2118, BW=8476KiB/s (8679kB/s)(275MiB/33273msec); 0 zone resetsfio --name=rw4k --directory=/var/lib/vz --rw=randwrite --bs=4k --size=1G \ --iodepth=16 --ioengine=libaio --direct=1 --runtime=30 --time_based --group_reporting --unlink=1 write: IOPS=11.2k, BW=43.7MiB/s (45.8MB/s)(1310MiB/30001msec); 0 zone resets5. Spostare il disco della VM su NFS
Sezione intitolata “5. Spostare il disco della VM su NFS”-
VM 100 → Hardware → seleziona Hard Disk (scsi0) → Disk Action → Move Storage.
-
Target Storage
nas-nfs, FormatQEMU image format (qcow2), Delete source spuntato, poi Move disk.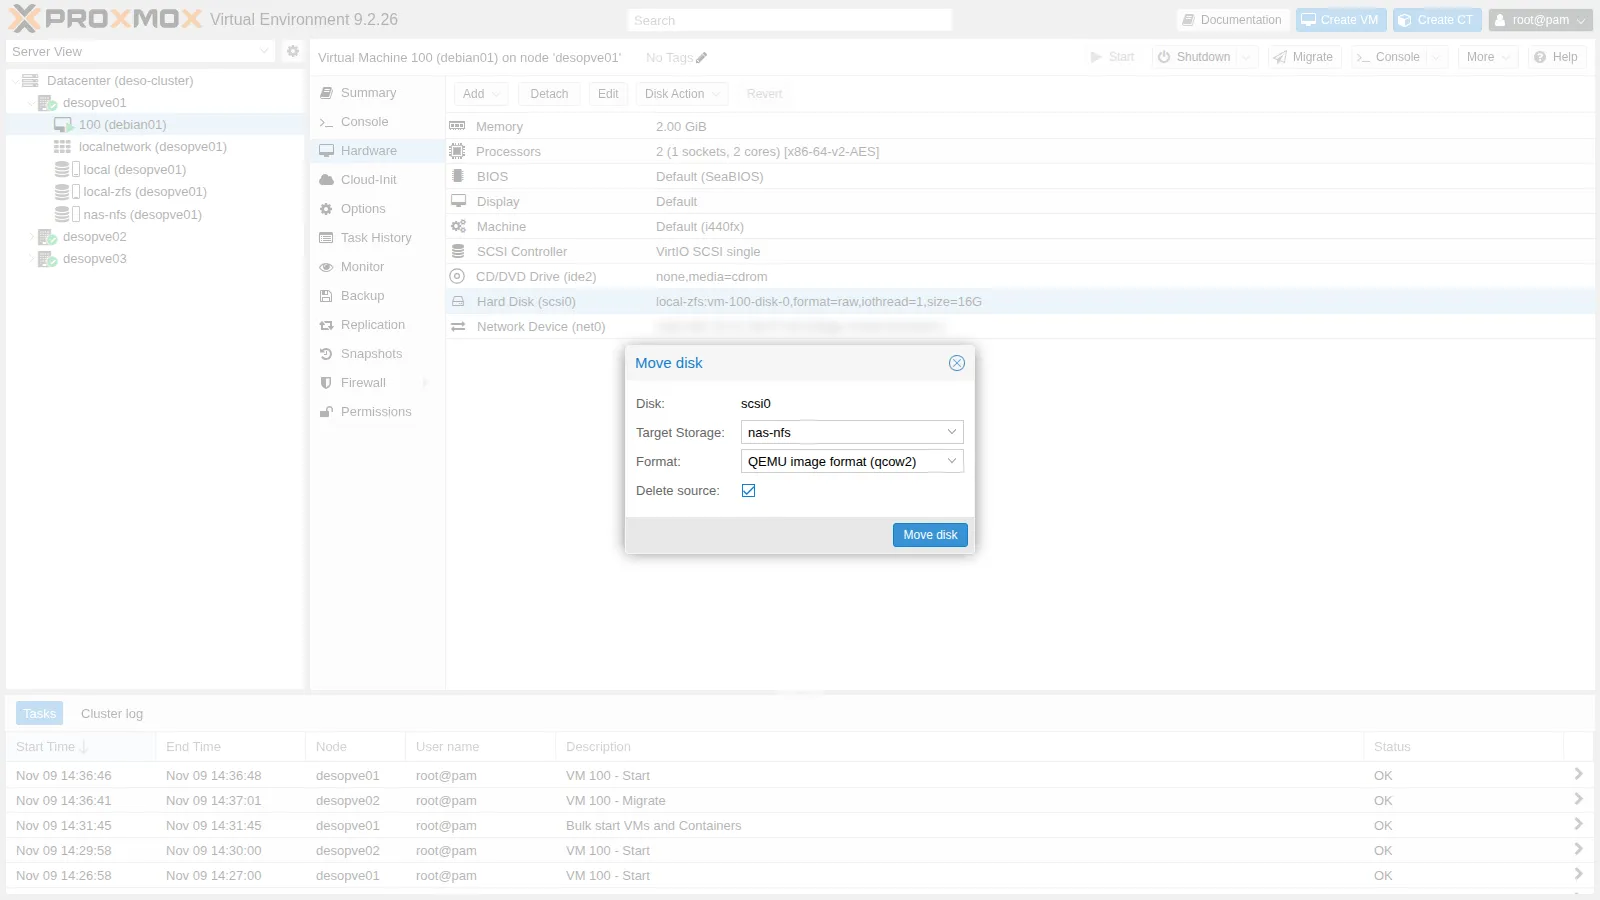
La VM resta accesa: QEMU copia il disco in background (drive mirror) e alla fine passa sul nuovo file. Il task ha copiato il disco da 16 GiB in 3 minuti e 35 secondi:
mirror-scsi0: transferred 16.0 GiB of 16.0 GiB (100.00%) in 3m 35s, readymirror-scsi0: Completed successfully.removing source volume 'local-zfs:vm-100-disk-0' after successful copyTASK OK -
Il disco ora è un file
qcow2sul NAS: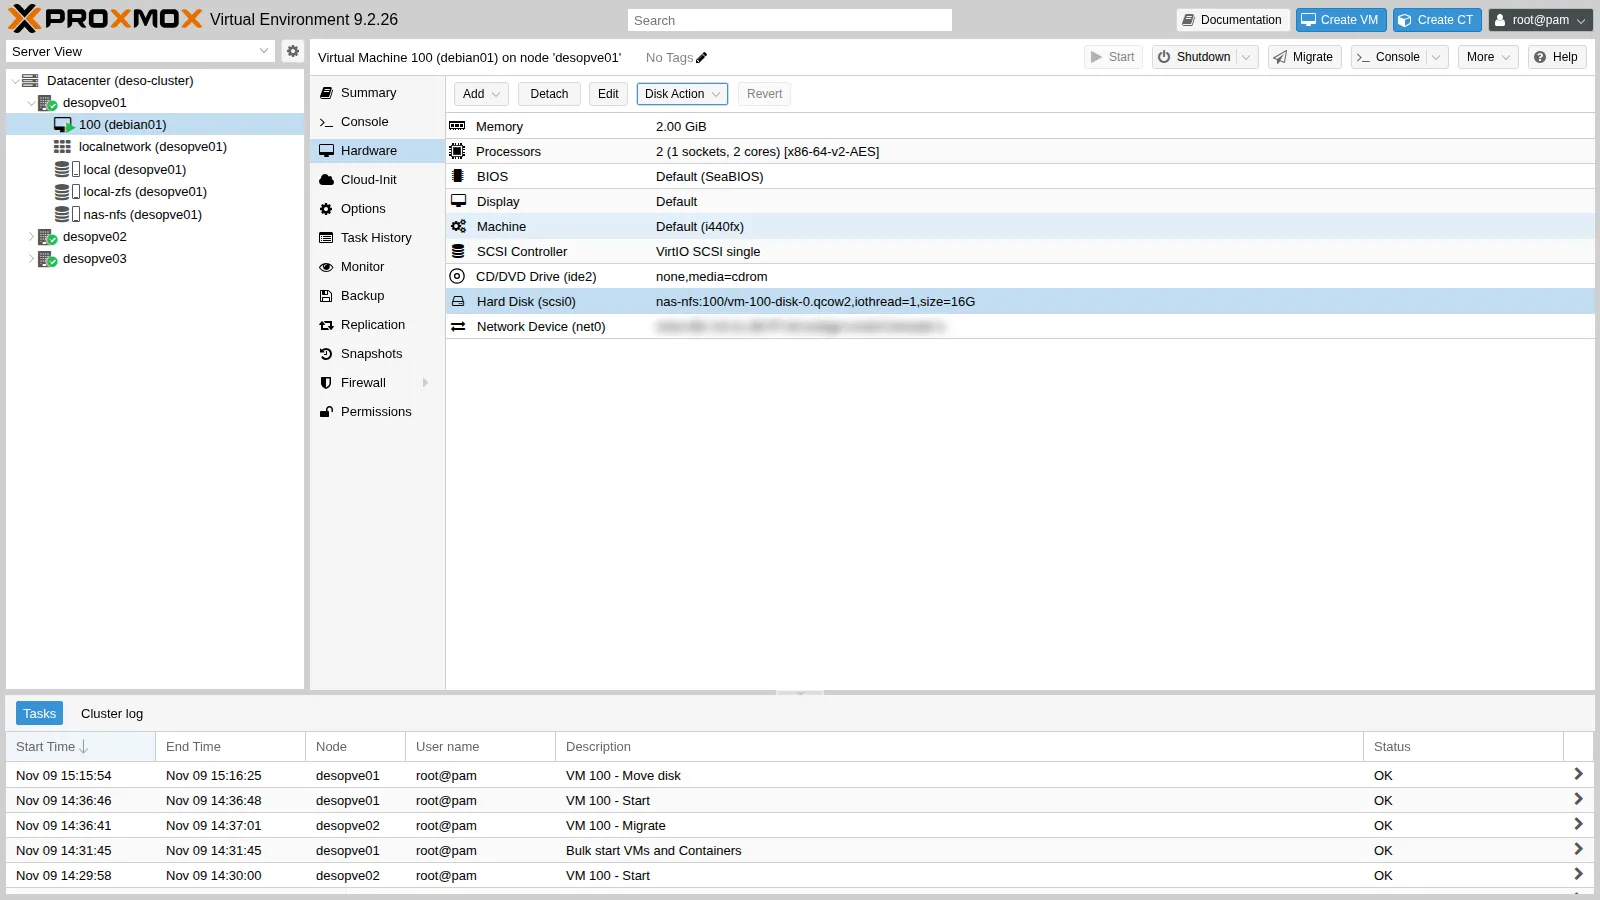
root@desopve01 qm config 100 | grep scsi0Output scsi0: nas-nfs:100/vm-100-disk-0.qcow2,iothread=1,size=16Groot@desopve01 qemu-img info /mnt/pve/nas-nfs/images/100/vm-100-disk-0.qcow2 | head -4Output image: /mnt/pve/nas-nfs/images/100/vm-100-disk-0.qcow2file format: qcow2virtual size: 16 GiB (17179869184 bytes)disk size: 6.5 GiBIl file da 16 GiB occupa 6,5 GiB:
qcow2alloca lo spazio solo per i blocchi che contengono dati.
6. Ripetere le misure su NFS e confrontare
Sezione intitolata “6. Ripetere le misure su NFS e confrontare”Nella VM ripeti gli stessi comandi del passo 4, ora con il disco su NFS:
dd if=/dev/zero of=$HOME/test.bin bs=1M count=1024 oflag=direct1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.403307 s, 2.7 GB/shead -c 512M /dev/urandom > /dev/shm/rnd.binfor i in 1 2 3; do dd if=/dev/shm/rnd.bin of=$HOME/test.bin bs=1M oflag=direct conv=fsync 2>&1 | tail -1; done536870912 bytes (537 MB, 512 MiB) copied, 6.69699 s, 80.2 MB/s536870912 bytes (537 MB, 512 MiB) copied, 20.2377 s, 26.5 MB/s536870912 bytes (537 MB, 512 MiB) copied, 26.9102 s, 20.0 MB/sfor i in 1 2; do dd if=$HOME/test.bin of=/dev/null bs=1M iflag=direct 2>&1 | tail -1; done536870912 bytes (537 MB, 512 MiB) copied, 1.44691 s, 371 MB/s536870912 bytes (537 MB, 512 MiB) copied, 1.7027 s, 315 MB/srm -f $HOME/test.bin /dev/shm/rnd.binE dal nodo, le scritture casuali da 4 KiB sulla condivisione NFS:
fio --name=rw4k --directory=/mnt/pve/nas-nfs --rw=randwrite --bs=4k --size=1G \ --iodepth=16 --ioengine=libaio --direct=1 --runtime=30 --time_based --group_reporting --unlink=1 write: IOPS=865, BW=3463KiB/s (3546kB/s)(101MiB/30007msec); 0 zone resetsfio --name=rw4k --directory=/mnt/pve/nas-nfs --rw=randwrite --bs=4k --size=1G \ --iodepth=16 --ioengine=libaio --direct=1 --runtime=30 --time_based --group_reporting --unlink=1 write: IOPS=966, BW=3867KiB/s (3959kB/s)(114MiB/30151msec); 0 zone resets| Prova | Storage locale | NFS |
|---|---|---|
Zeri, 1 GiB (dd nella VM, una volta) |
762 MB/s (local-zfs) |
2,7 GB/s |
Scrittura sequenziale, dati casuali (dd nella VM, 3 ripetizioni) |
32-98 MB/s (local-zfs) |
20-80 MB/s |
Lettura sequenziale (dd nella VM, 2 ripetizioni) |
728-865 MB/s (local-zfs) |
315-371 MB/s |
Scrittura casuale 4 KiB, coda 16 (fio dal nodo, 2 ripetizioni da 30 s) |
2 118-11 200 IOPS (/var/lib/vz) |
865-966 IOPS |
I valori in MB/s sono quelli stampati da dd, in unità decimali. Ogni punto qui sotto separa ciò che la prova ha misurato da come lo interpretiamo, e indica la verifica che servirebbe.
- Gli zeri.
- Misura: 1 GiB di zeri scritto con
ddnella VM va a 762 MB/s con il disco sulocal-zfse a 2,7 GB/s sunas-nfs. - Interpretazione: una scrittura su NFS più veloce di quella locale è compatibile con zeri che non arrivano al NAS come dati. Con le opzioni predefinite di Proxmox VE, QEMU rileva le scritture di zeri (
detect_zeroes) e le trasforma in un’operazione che su un fileqcow2può essere registrata nei metadati dell’immagine, senza scrivere i blocchi. Anche la compressione di ZFS, sul nodo e sul NAS, tratta in modo particolare i blocchi di zeri. La prova non dice quale meccanismo abbia agito, ma basta per escludere gli zeri come dato di prova: per misurare servono dati casuali. - Verifica: sul nodo, confronta i byte trasmessi da
vmbr0(ip -s link show vmbr0) prima e dopo ildd: se gli zeri non viaggiano verso il NAS, sono molto meno di 1 GiB. In alternativa, ripeti la prova con l’opzione del discodetect_zeroes=0.
- Misura: 1 GiB di zeri scritto con
- Scrittura sequenziale con dati casuali (nella VM).
- Misura: in locale 35,7, 97,8 e 32,1 MB/s; su NFS 80,2, 26,5 e 20,0 MB/s. Ogni
ddscrive 512 MiB un blocco da 1 MiB alla volta e termina con unfsync. - Interpretazione: su entrambi gli storage la stessa prova varia di un fattore 3-4 tra una ripetizione e l’altra, e gli intervalli si sovrappongono: questa prova non stabilisce quale dei due scriva più velocemente in sequenza. Tra le cause possibili della variabilità ci sono l’attività del resto del laboratorio e le scritture periodiche con cui ZFS porta i dati su disco, sul nodo e sul NAS; la prova non le distingue.
- Verifica: più ripetizioni e più lunghe, con il resto del laboratorio fermo, osservando
zpool iostat 1sul nodo e sul NAS durante la scrittura.
- Misura: in locale 35,7, 97,8 e 32,1 MB/s; su NFS 80,2, 26,5 e 20,0 MB/s. Ogni
- Lettura sequenziale (nella VM).
- Misura: in locale 728 e 865 MB/s; su NFS 371 e 315 MB/s.
- Interpretazione: da NFS la lettura va tra un terzo e la metà di quella locale. È compatibile con il costo della rete e del NAS per ogni richiesta. Però il file era appena stato scritto ed è piccolo rispetto alla RAM: le letture locali possono arrivare dall’ARC del nodo e quelle NFS dall’ARC del NAS, e la prova non separa questi contributi.
- Verifica:
arcstat 1sul nodo e sul NAS durante la lettura; una lettura di un file più grande della RAM disponibile per l’ARC.
- Scrittura casuale 4 KiB (
fiodal nodo, coda 16).- Misura: su
/var/lib/vz2 118 e 11 200 IOPS; su NFS 865 e 966 IOPS. - Interpretazione: in locale due esecuzioni identiche differiscono di cinque volte: il valore locale è instabile, e la prova non dice perché. Su NFS i valori sono stabili e più bassi di entrambi. Il risultato NFS è compatibile con scritture dirette (
--direct=1) che il NAS conferma solo dopo averle rese stabili, cioè, con ZFS, dopo il passaggio nello ZIL: ogni scrittura paga anche l’andata e ritorno in rete. La prova non separa la rete dal NAS. Quifiogira sul nodo, quindi l’opzione di cache del disco della VM non c’entra; un disco di VM concache=none, il default, apre il suo file nello stesso modo diretto. - Verifica: sul NAS,
zfs get sync dati/nfse i contatori dello ZIL (cat /proc/spl/kstat/zfs/zil) prima e dopo la prova: se le scritture passano dallo ZIL,zil_commit_countcresce durante il test. Sul nodo,nfsstat -mmostra le opzioni effettive del mount, e unpingverso il NAS il tempo di andata e ritorno della sola rete.
- Misura: su
Cosa ne ricavi. Le scritture casuali piccole sono il punto da misurare prima di mettere su NFS i dischi di VM con molte scritture sincrone, come i database. Se la verifica conferma che il limite è la scrittura sincrona sul NAS, le opzioni usuali sono un dispositivo di log veloce e dedicato sul NAS (SLOG) e una rete più veloce, da valutare ripetendo la stessa misura. Nel lab 19 ripeterai i test su tutti gli storage, con un metodo più rigoroso.
Verifica e test
Sezione intitolata “Verifica e test”Test – Il NAS smette di rispondere
Sezione intitolata “Test – Il NAS smette di rispondere”Lasci il disco della VM su NFS e fermi il servizio NFS sul NAS, come succederebbe con un guasto del NAS o della rete.
-
Nella VM avvia un «battito» che scrive l’ora ogni secondo e la forza sul disco:
labuser@debian01 nohup sh -c 'while true; do date +%T >> $HOME/battito.log; sync; sleep 1; done' >/dev/null 2>&1 & -
Sul NAS: System → Services → NFS → Stop Service e conferma con Stop.
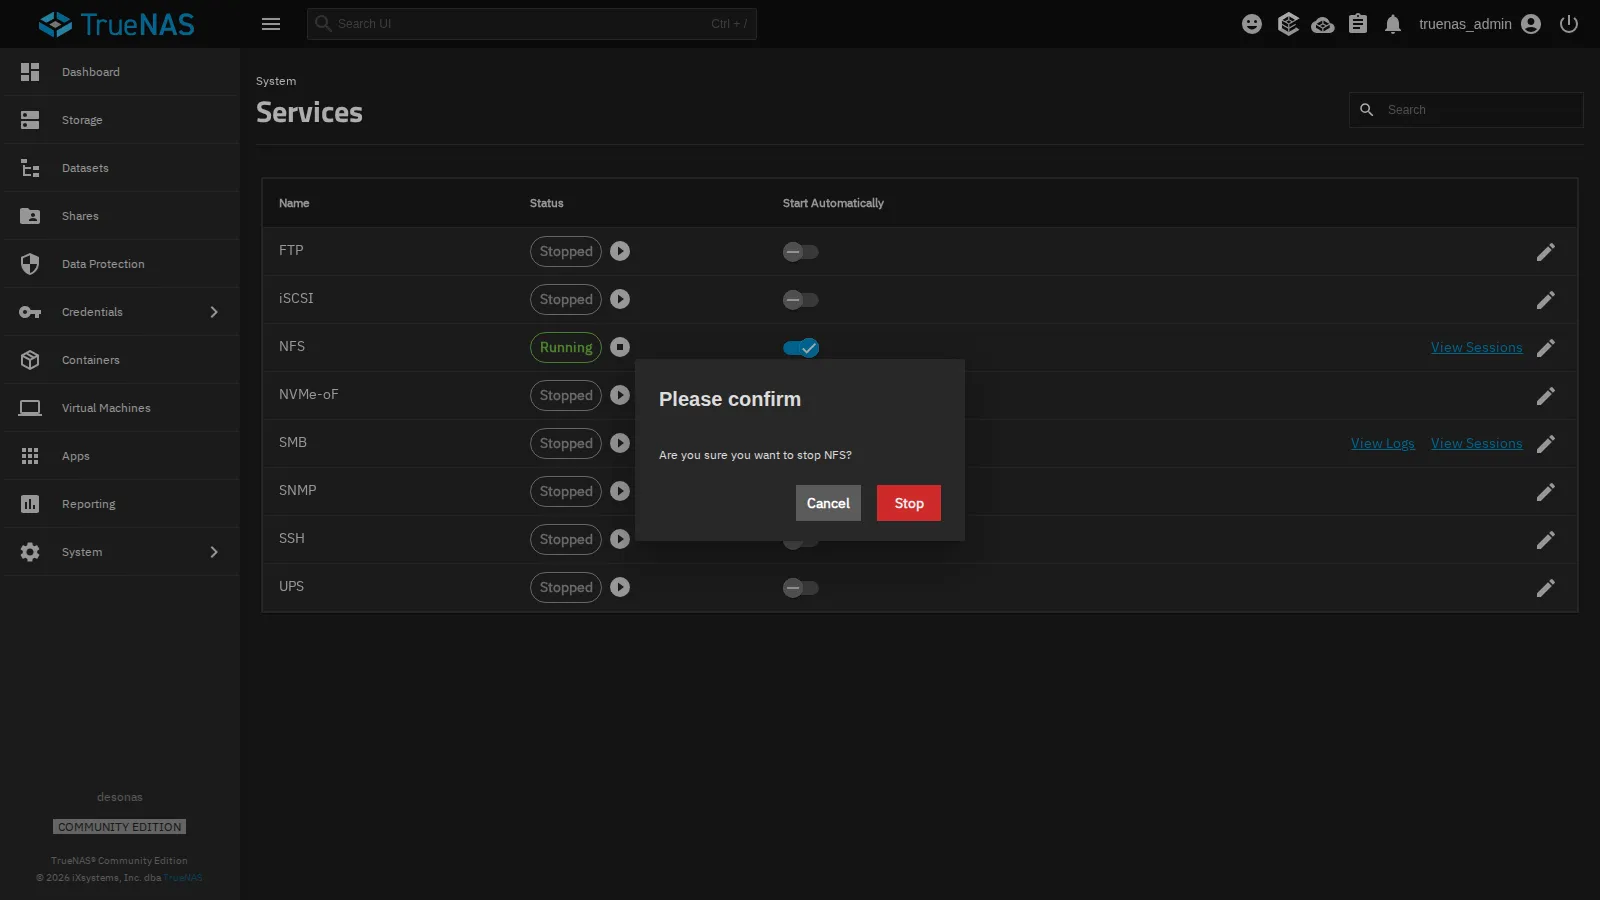
-
Un minuto dopo, sul nodo, il server non risponde più in NFS e
pvestatdsegna lo storage come non attivo. La VM, invece, risulta ancora accesa:root@desopve01 rpcinfo -T tcp 172.27.199.10 nfs 4Output rpcinfo: RPC: Program not registeredroot@desopve01 pvesm statusOutput storage 'nas-nfs' is not onlineName Type Status Total (KiB) Used (KiB) Available (KiB) %local dir active 46255488 768000 45487488 1.66%local-zfs zfspool active 45487664 96 45487568 0.00%nas-nfs nfs inactive 0 0 0 0.00%root@desopve01 journalctl -u pvestatd --since "-3 min" | tail -2Output Nov 09 15:21:57 desopve01 pvestatd[1611]: storage 'nas-nfs' is not onlineNov 09 15:22:07 desopve01 pvestatd[1611]: storage 'nas-nfs' is not onlineroot@desopve01 qm status 100Output status: runningNell’interfaccia web lo storage risulta Active: No, senza dati di utilizzo:
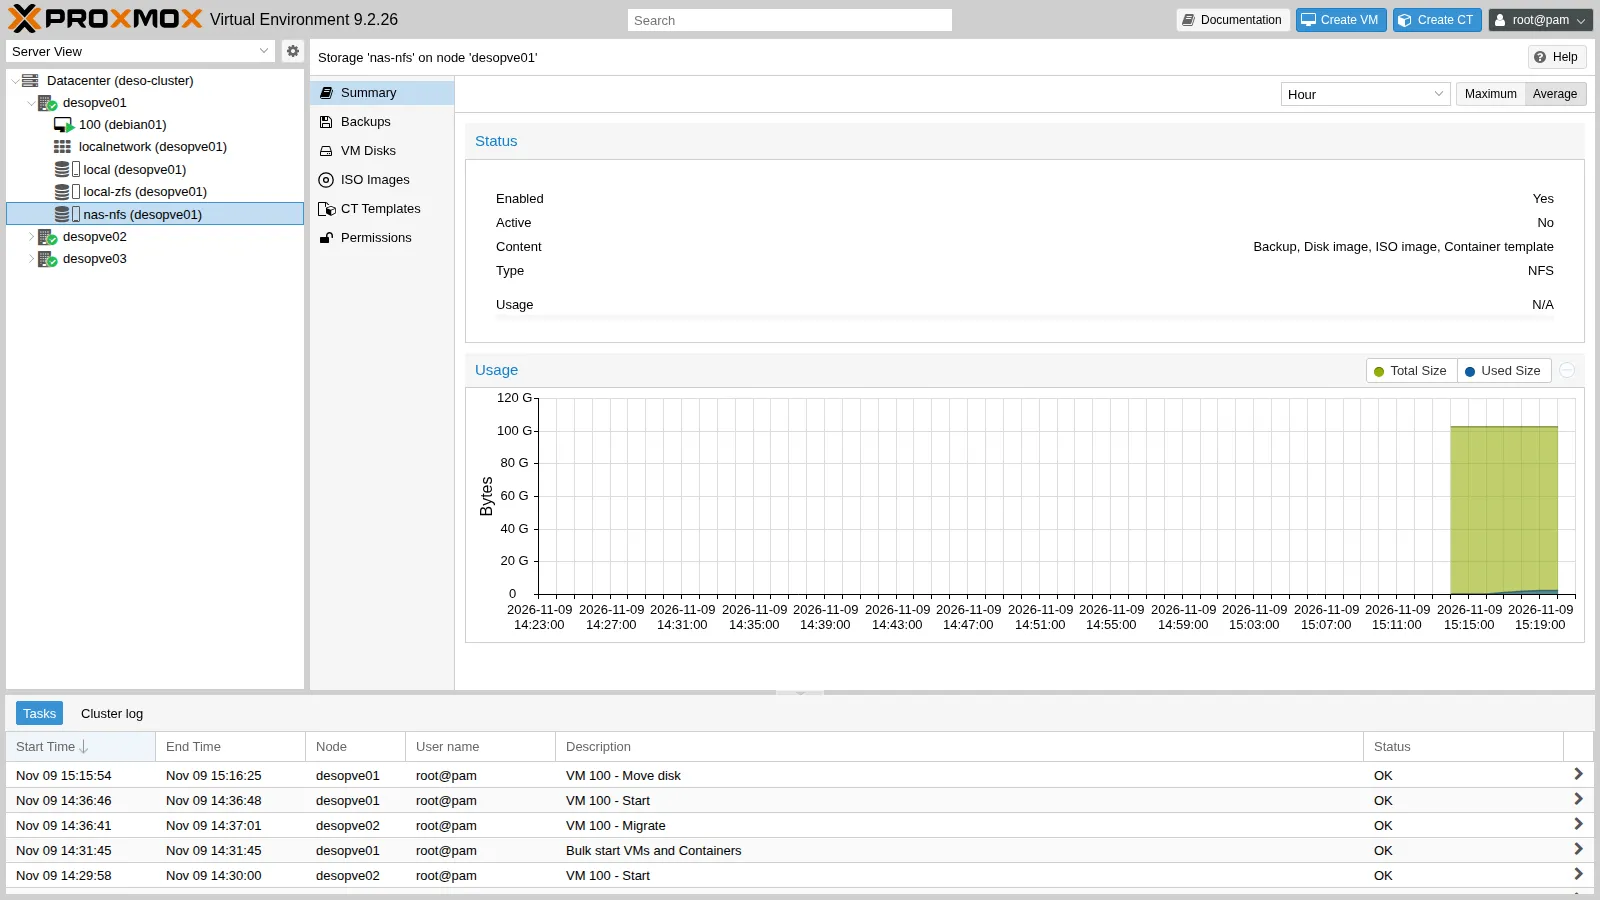
Per uno storage NFSv4,
pvestatdcontrolla il server con la stessa interrogazionerpcinfodel passo 2, prima di toccare il mount: per questo segna lo storage come non attivo senza restare bloccato. Chi invece accede ai file del mount resta in attesa. -
Prova ad accedere al mount: il processo resta bloccato nello stato
D(attesa non interrompibile di I/O), in attesa del server. Il kernel lo segnala nel log:root@desopve01 timeout 20 ls -la /mnt/pve/nas-nfs/images/100/ &ps -eo stat,pid,etime,comm,wchan:28 | awk 'NR==1 || $1 ~ /^D/'Output STAT PID ELAPSED COMMAND WCHAND 12326 00:20 172.27.199.10-m rpc_wait_bit_killableD 12419 00:03 ls rpc_wait_bit_killableroot@desopve01 dmesg -T | grep "nfs: server"Output [Mon Nov 9 15:24:04 2026] nfs: server 172.27.199.10 not responding, still tryingIl primo processo è il thread del kernel che gestisce lo stato NFSv4 verso il server. Linux conta i processi in stato
Dnel load average: con il NAS fermo, il load average dei nodi può salire anche con le CPU libere. Questa prova non lo ha registrato;uptimedurante la caduta lo mostra.Il messaggio
not respondingarriva alle 15:24:04, circa tre minuti dopo l’ultima riga del battito (15:20:58). È compatibile con le opzioni del mount: secondonfs(5)il client segnala il server doporetranstentativi, con un’attesa che parte datimeo(60 secondi) e cresce di 60 secondi a ogni tentativo, quindi 60 + 120 = 180 secondi. La prova non lo dimostra, perché l’istante della prima richiesta rimasta senza risposta non è noto. -
Nella VM l’I/O verso il disco è fermo. Il battito si è interrotto alle 15:20:58, e dopo due minuti il kernel della VM segnala sulla console i processi bloccati sul disco, a partire dal journal del file system (
jbd2); due minuti sono la soglia predefinita del kernel per segnalare un processo bloccato: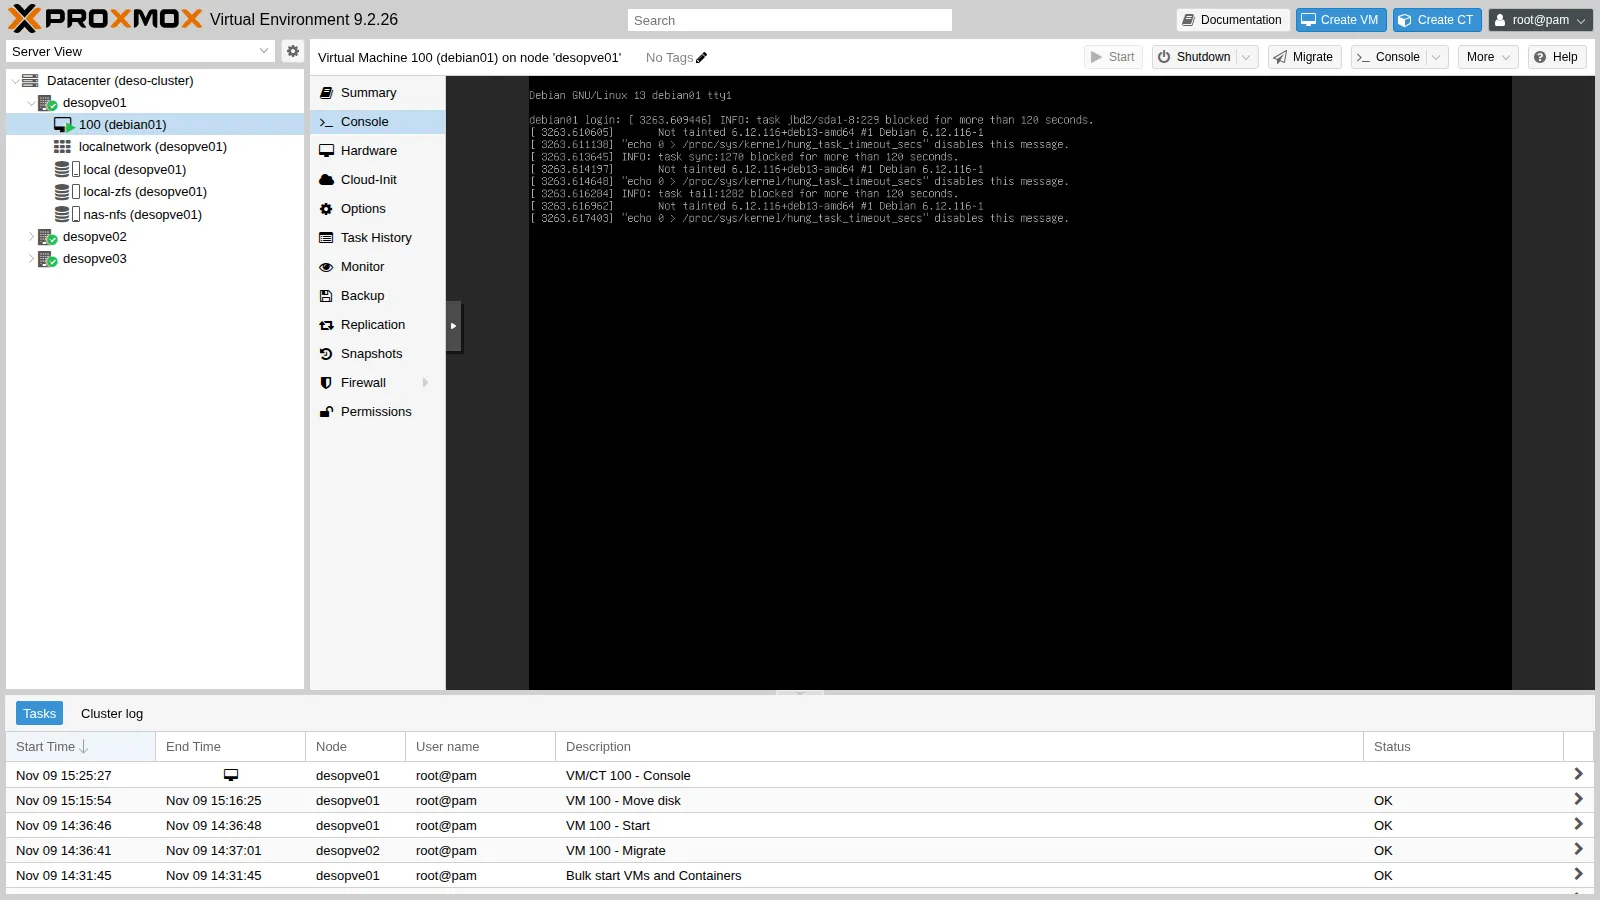
La VM non va in errore e non si spegne: aspetta, come i processi del nodo.
-
Riavvia il servizio sul NAS (Start Service). Il kernel del nodo registra la ripresa, lo storage torna attivo e non resta nessun processo in stato
D:root@desopve01 dmesg -T | grep "nfs: server" | tail -1Output [Mon Nov 9 15:37:36 2026] nfs: server 172.27.199.10 OKroot@desopve01 pvesm status | grep nas-nfsOutput nas-nfs nfs active 100069376 2021376 98048000 2.02%root@desopve01 ps -eo stat,comm | awk '$1 ~ /^D/' | wc -lOutput 0Cosa è stato osservato. Tra l’ultima riga del battito scritta prima dell’arresto (15:20:58) e il messaggio
nfs: server 172.27.199.10 OK(15:37:36) sono passati circa 16 minuti e mezzo. Sono due osservazioni diverse, una nella VM e una nel kernel del nodo; gli istanti esatti dell’arresto e del riavvio del servizio sul NAS non sono stati registrati. Dopo la ripresa la VM era ancora accesa, senza riavvio, e sul nodo non c’erano più processi in statoD.Interpretazione. È il comportamento che
nfs(5)descrive per il mounthard: le richieste vengono ritentate finché il server non risponde. La prova però non mostra che la VM abbia completato tutte le scritture in sospeso senza errori.Verifica. Nella VM,
tail $HOME/battito.logdeve mostrare il buco e poi di nuovo una riga al secondo, esudo journalctl -k | grep -iE 'I/O error|EXT4-fs error'non deve trovare errori del disco.
Pulizia
Sezione intitolata “Pulizia”Ferma il battito e riporta il disco della VM sullo storage locale. Lo storage nas-nfs resta configurato per i lab successivi.
pkill -f battito.log; rm -f $HOME/battito.logqm disk move 100 scsi0 local-zfs --delete 1…mirror-scsi0: transferred 16.0 GiB of 16.0 GiB (100.00%) in 38s, readyremoving source volume 'nas-nfs:100/vm-100-disk-0.qcow2' after successful copyqm config 100 | grep scsi0scsi0: local-zfs:vm-100-disk-0,iothread=1,size=16GLa copia di ritorno ha impiegato 38 secondi, contro i 3 minuti e 35 secondi dell’andata. I due tempi dei task non sono una misura dello storage: direzione, formato dei file e quantità di dati letti davvero sono diversi, e questo lab non ha indagato la differenza.
Riepilogo dei controlli
Sezione intitolata “Riepilogo dei controlli”| Controllo | Risultato atteso | Osservato in questa prova |
|---|---|---|
| Export | /mnt/dati/nfs esportata alla sola rete 172.27.199.0/24, con root mappato su root |
pvesm scan nfs: /mnt/dati/nfs 172.27.199.0/24 |
| Mount | NFS 4.2 su tutti e tre i nodi, hard |
vers=4.2, hard, timeo=600, retrans=2; sottocartelle visibili da desopve03 |
| Spostamento a caldo | disco su NFS e di nuovo in locale, con la VM accesa | andata TASK OK in 3 min 35 s, ritorno in 38 s; qm config mostra di nuovo local-zfs |
| Misure | dati casuali e più ripetizioni; per ogni numero, lo strumento e il livello che misura | tabella del passo 6 |
| NAS fermo | storage inattivo, processi in stato D, VM in attesa; ripresa da sola al ritorno del servizio |
inactive, due processi in D, VM running; server ... OK alle 15:37:36 e nessun processo in D |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- NAS: condivisione NFS
/mnt/dati/nfsper172.27.199.0/24, Maprootroot:wheel; servizio NFS attivo e con avvio automatico. - Cluster: storage
nas-nfs(NFS 4.2,172.27.199.10:/mnt/dati/nfs, contenutiimages,iso,backup,vztmpl, condiviso, su tutti i nodi), montato in/mnt/pve/nas-nfse vuoto. - VM 100
debian01accesa sudesopve01, con il disco sulocal-zfs. fioinstallato sudesopve01.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Come esporre un dataset NFS a Proxmox VE: export limitato alla rete dei nodi, root mappato su
root(Maproot), server indicato con l’indirizzo IP; prima di aggiungere lo storage,pvesm scan nfserpcinfodal nodo. - Quando mettere i dischi delle VM su NFS: è uno storage condiviso (migrazione della sola memoria, alta disponibilità) e i dischi si spostano a caldo; per i carichi con molte scritture piccole e sincrone, prima misuri la scrittura casuale 4 KiB sul tuo NAS, come al passo 6.
- Come misurare senza farsi ingannare: dati casuali e non zeri, più ripetizioni, intervalli e non valori singoli, e per ogni numero lo strumento e il livello che misura (la VM o il nodo).
- Cosa aspettarsi se il NAS si ferma, e come prepararsi: con
hardl’I/O si ferma senza errori e riprende al ritorno del server; nel frattempo le VM sono bloccate e i processi del nodo restano in statoD. La disponibilità del NAS e della rete verso di esso va pianificata come quella dei nodi, esoftnon si usa per i dischi delle VM.