

Lab 17 – Ceph 1: architettura, installazione, pool RBD e CephFS
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti: Lab 06 (cluster
deso-clustera tre nodi), Lab 08 (spostamento dei dischi tra storage), Lab 14 (la ISO Debian sullo storagenas-smb). - Nodi:
desopve01,desopve02edesopve03in cluster, ciascuno con:- due dischi liberi da 60 GB (
/dev/sdce/dev/sdd), mai usati; - una terza scheda di rete libera (
nic2) collegata a uno switch che trasporta le VLAN 50 e 51.
- due dischi liberi da 60 GB (
- VM: la VM 100
debian01accesa sudesopve01, con il disco sulocal-zfs. - Internet: il proxy del laboratorio (
proxy.proxmox.community:3128) deve consentiredownload.proxmox.com, da cui arrivano i pacchetti Ceph. - Credenziali:
root/<password-lab>sui nodi → Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Capire i componenti di Ceph (MON, MGR, OSD, MDS) e come Ceph decide dove mettere i dati (pool, placement group, CRUSH).
- Preparare una rete dedicata a Ceph con due VLAN separate dalla gestione.
- Installare Ceph Tentacle con il wizard di Proxmox VE e completare il cluster Ceph sui tre nodi.
- Creare gli OSD, un pool RBD replicato 3/2 e lo storage RBD del cluster.
- Spostare una VM su Ceph e migrarla a caldo senza copiare il disco.
- Creare un file system CephFS per ISO, template e backup.
Come funziona
Sezione intitolata “Come funziona”I componenti
Sezione intitolata “I componenti”Ceph è uno storage distribuito: unisce i dischi di più server in un unico sistema, replica i dati tra i server e si ripara da solo quando un disco o un nodo si guastano. In Proxmox VE è integrato nell’interfaccia: si installa, si configura e si controlla dalla GUI, senza strumenti esterni.
| Componente | Cosa fa | Quanti nel lab |
|---|---|---|
| MON (monitor) | Mantiene la mappa del cluster: quali OSD esistono, dove stanno i dati, chi è vivo. Decide a maggioranza (quorum). | 3, uno per nodo |
| MGR (manager) | Raccoglie statistiche e ospita i moduli (autoscaler dei PG, dashboard, metriche). Uno attivo, gli altri in standby. | 3 (1 attivo, 2 standby) |
| OSD (object storage daemon) | Un processo per disco: scrive i dati sul disco, li replica verso gli altri OSD e partecipa al recupero. | 6, due per nodo |
| MDS (metadata server) | Gestisce i metadati (cartelle, nomi, permessi) del file system CephFS. Serve solo per CephFS. | 2 (1 attivo, 1 standby) |
I monitor sono tre per la stessa ragione dei voti di Corosync (lab 06): con tre monitor il cluster resta operativo se uno si ferma, perché gli altri due sono la maggioranza. Con due monitor, la caduta di uno blocca tutto.
Dai dati ai dischi: pool, PG e CRUSH
Sezione intitolata “Dai dati ai dischi: pool, PG e CRUSH” VM 100 ──▶ immagine RBD vm-100-disk-0 (16 GiB) │ divisa in oggetti da 4 MiB ▼ pool rbd-vm (size 3, min_size 2) │ ogni oggetto finisce in un placement group (PG) ▼ PG 2.1a ──CRUSH──▶ osd.1 (desopve01) + osd.2 (desopve02) + osd.4 (desopve03)- Pool: contenitore logico con le sue regole di protezione.
size 3= ogni oggetto esiste in tre copie;min_size 2= il pool accetta scritture finché ci sono almeno due copie disponibili. - Placement group (PG): gruppi di oggetti. Ceph non sposta i singoli oggetti ma interi PG: è molto più leggero da gestire. L’autoscaler sceglie il numero di PG per ogni pool in base allo spazio usato.
- CRUSH: l’algoritmo che, dato un PG, calcola su quali OSD vanno le copie, senza consultare una tabella. La regola predefinita
replicated_rulemette ogni copia su un host diverso: perdere un intero nodo non fa perdere dati.
Due reti per Ceph
Sezione intitolata “Due reti per Ceph”| Rete | VLAN | Subnet | Traffico |
|---|---|---|---|
| Public network | 50 | 10.50.10.0/24 | client (i nodi che leggono e scrivono i dischi delle VM) e monitor |
| Cluster network | 51 | 10.51.10.0/24 | replica e recupero tra gli OSD |
Separare il traffico di Ceph dalla gestione (172.27.199.0/24) evita che una replica pesante rallenti la GUI, Corosync o le migrazioni. Nel laboratorio le due reti passano sulla stessa scheda nic2 come VLAN taggate: è il modo più comune di separare il traffico quando le schede sono poche. Le VLAN e le reti dedicate sono l’argomento del percorso B (lab 20-22).
Procedura
Sezione intitolata “Procedura”1. Rete dedicata: due VLAN su nic2
Sezione intitolata “1. Rete dedicata: due VLAN su nic2”-
Nodo desopve01 → System → Network → Create → Linux VLAN. Nome
nic2.50, indirizzo10.50.10.21/24, nessun gateway, Autostart spuntato. Proxmox ricava da solo la scheda di base (nic2) e il tag (50) dal nome.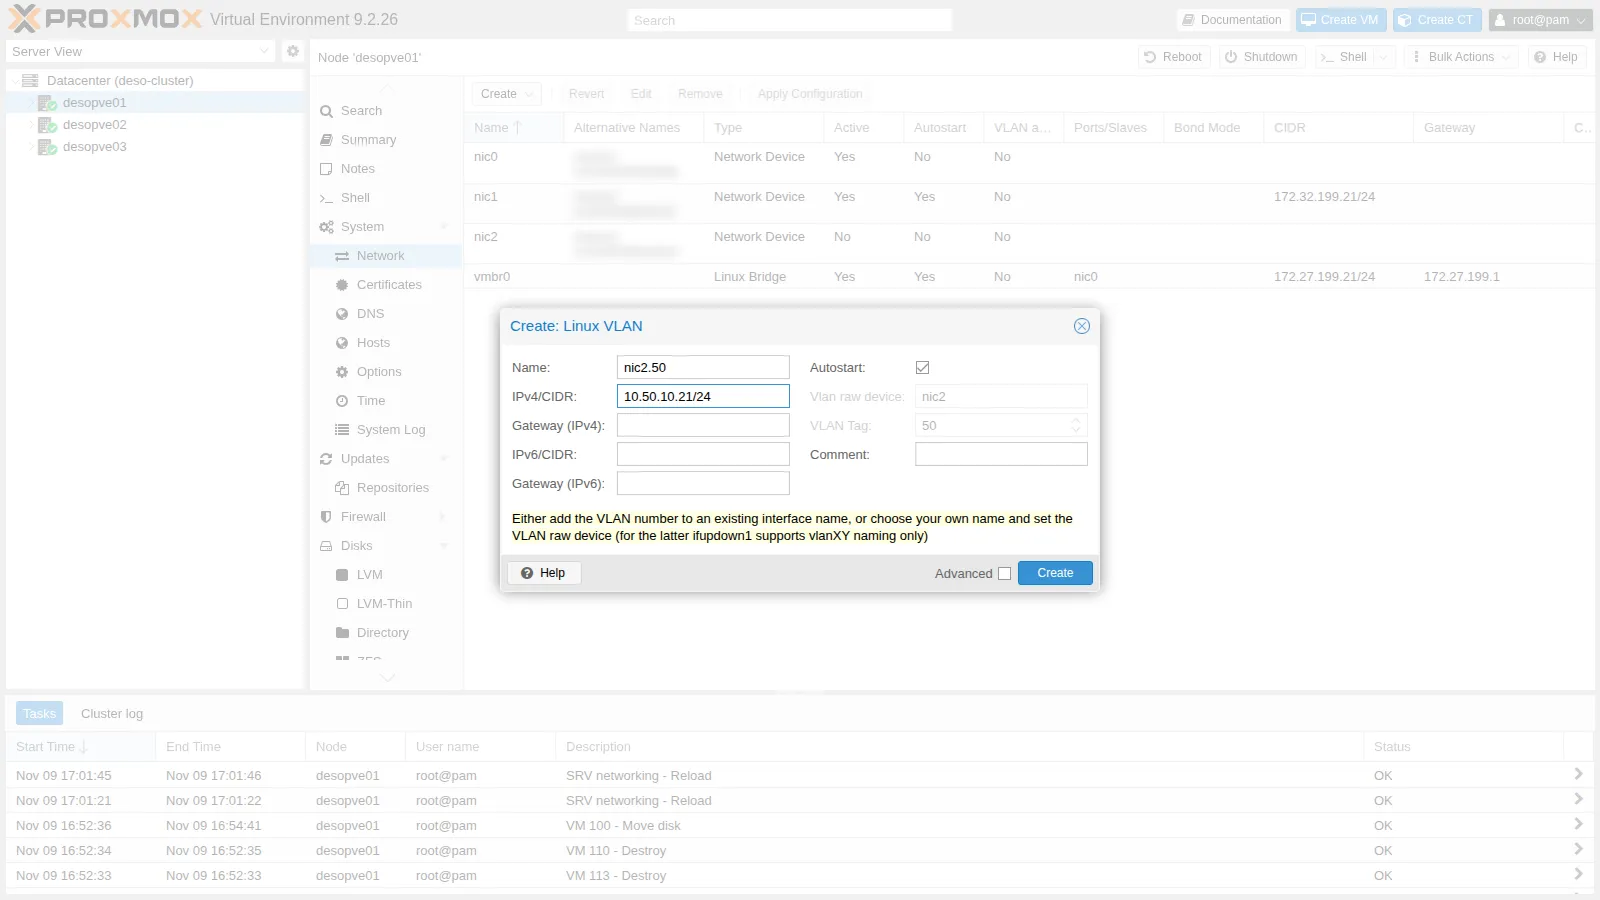
-
Ripeti per
nic2.51con10.51.10.21/24, poi Apply Configuration.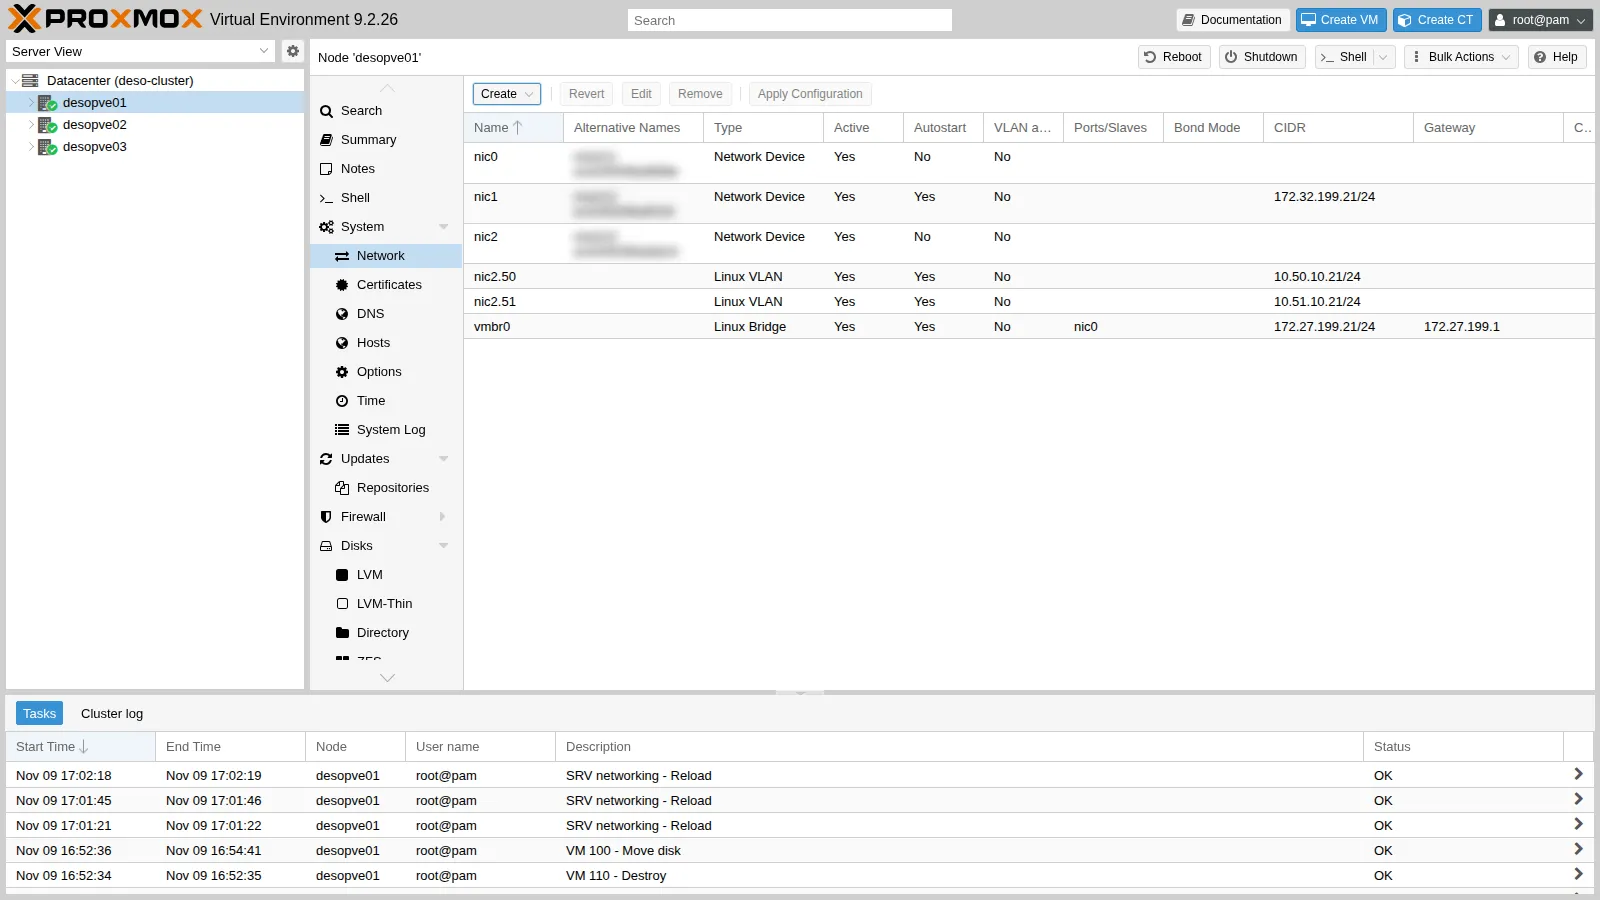
-
Sugli altri due nodi fai lo stesso da riga di comando, con l’API di Proxmox: il risultato è identico a quello della GUI.
root@desopve02 pvesh create /nodes/desopve02/network --iface nic2.50 --type vlan --cidr 10.50.10.22/24 --autostart 1pvesh create /nodes/desopve02/network --iface nic2.51 --type vlan --cidr 10.51.10.22/24 --autostart 1pvesh set /nodes/desopve02/networkip -br a | grep nic2Output nic2 UPnic2.50@nic2 UP 10.50.10.22/24nic2.51@nic2 UP 10.51.10.22/24Su
desopve03gli indirizzi sono10.50.10.23/24e10.51.10.23/24. -
Verifica che i pacchetti con tag passino tra i nodi e che le VLAN siano isolate dal resto della rete:
root@desopve01 ping -c2 -W1 10.50.10.22 | tail -2Output 2 packets transmitted, 2 received, 0% packet loss, time 1002msrtt min/avg/max/mdev = 0.658/0.992/1.326/0.334 msroot@desopve01 ping -c2 -W1 10.51.10.23 | tail -2Output 2 packets transmitted, 2 received, 0% packet loss, time 1001msrtt min/avg/max/mdev = 0.269/0.560/0.852/0.291 msLe due VLAN non hanno gateway: il traffico di Ceph non esce mai dalla rete dedicata. Lo conferma una prova dal DC, che sta sulla rete di gestione e non raggiunge la VLAN 50, perché nessun router la instrada:
PowerShell — desopve-dc01 (Test-NetConnection 10.50.10.21 -WarningAction SilentlyContinue).PingSucceededOutput False
2. Installazione di Ceph con il wizard
Sezione intitolata “2. Installazione di Ceph con il wizard”-
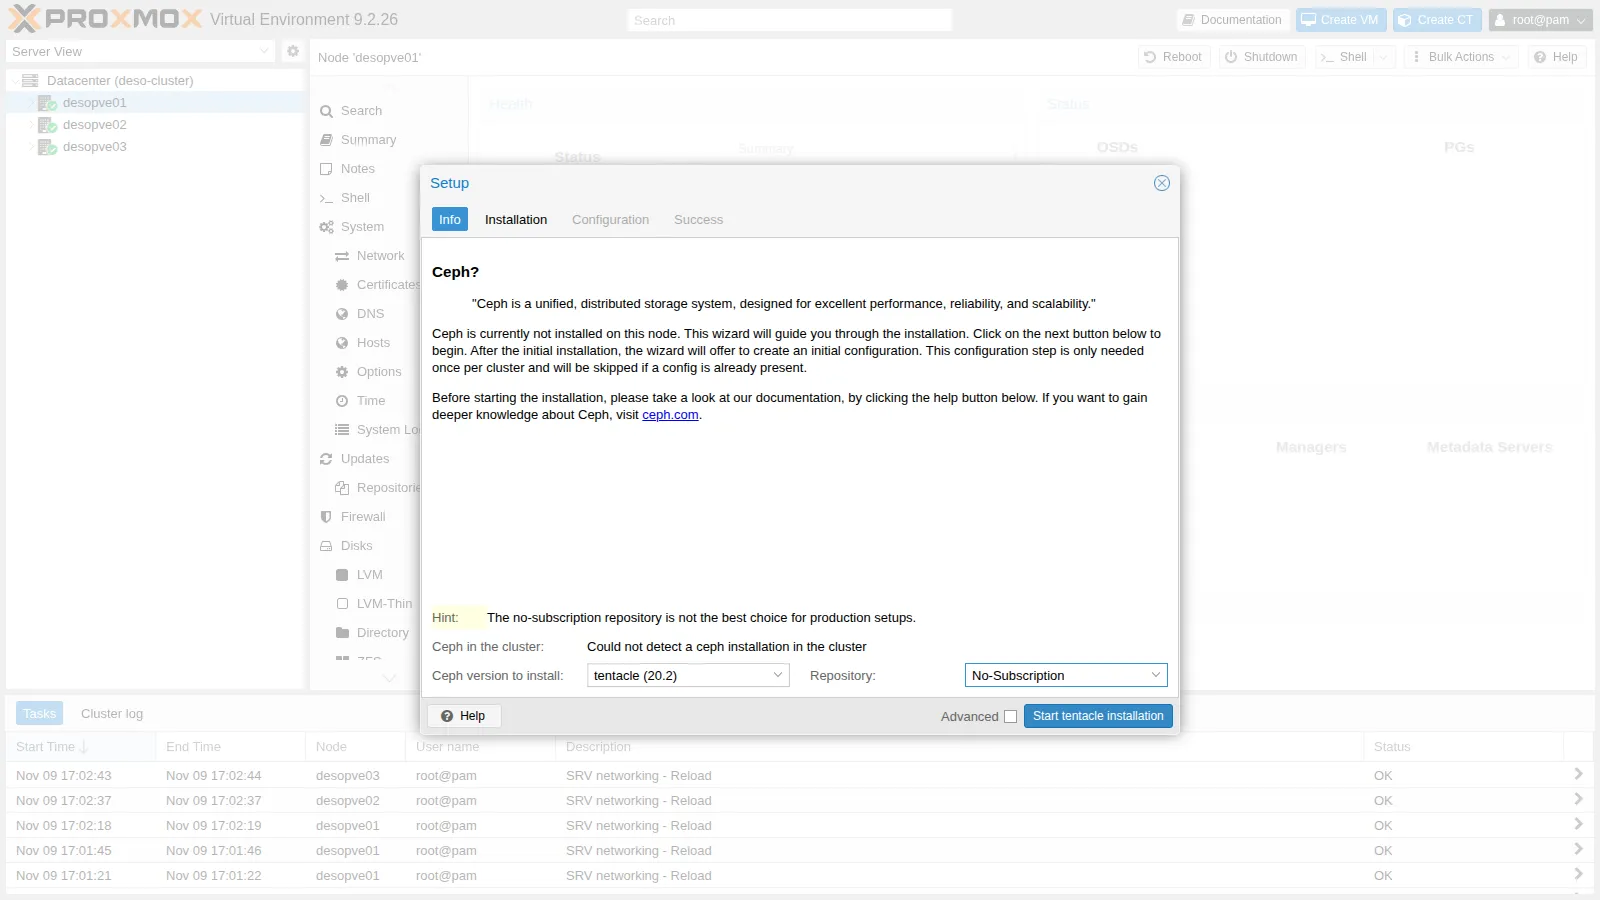
Nodo desopve01 → Ceph. Ceph non è installato e Proxmox propone Install Ceph.
-
Il wizard propone tentacle (20.2), la versione predefinita in Proxmox VE 9.2. Come Repository scegli No-Subscription: il repository Enterprise richiede un abbonamento.
-
Start tentacle installation: si apre un terminale con
apt. Controlla l’elenco dei pacchetti e conferma con Y.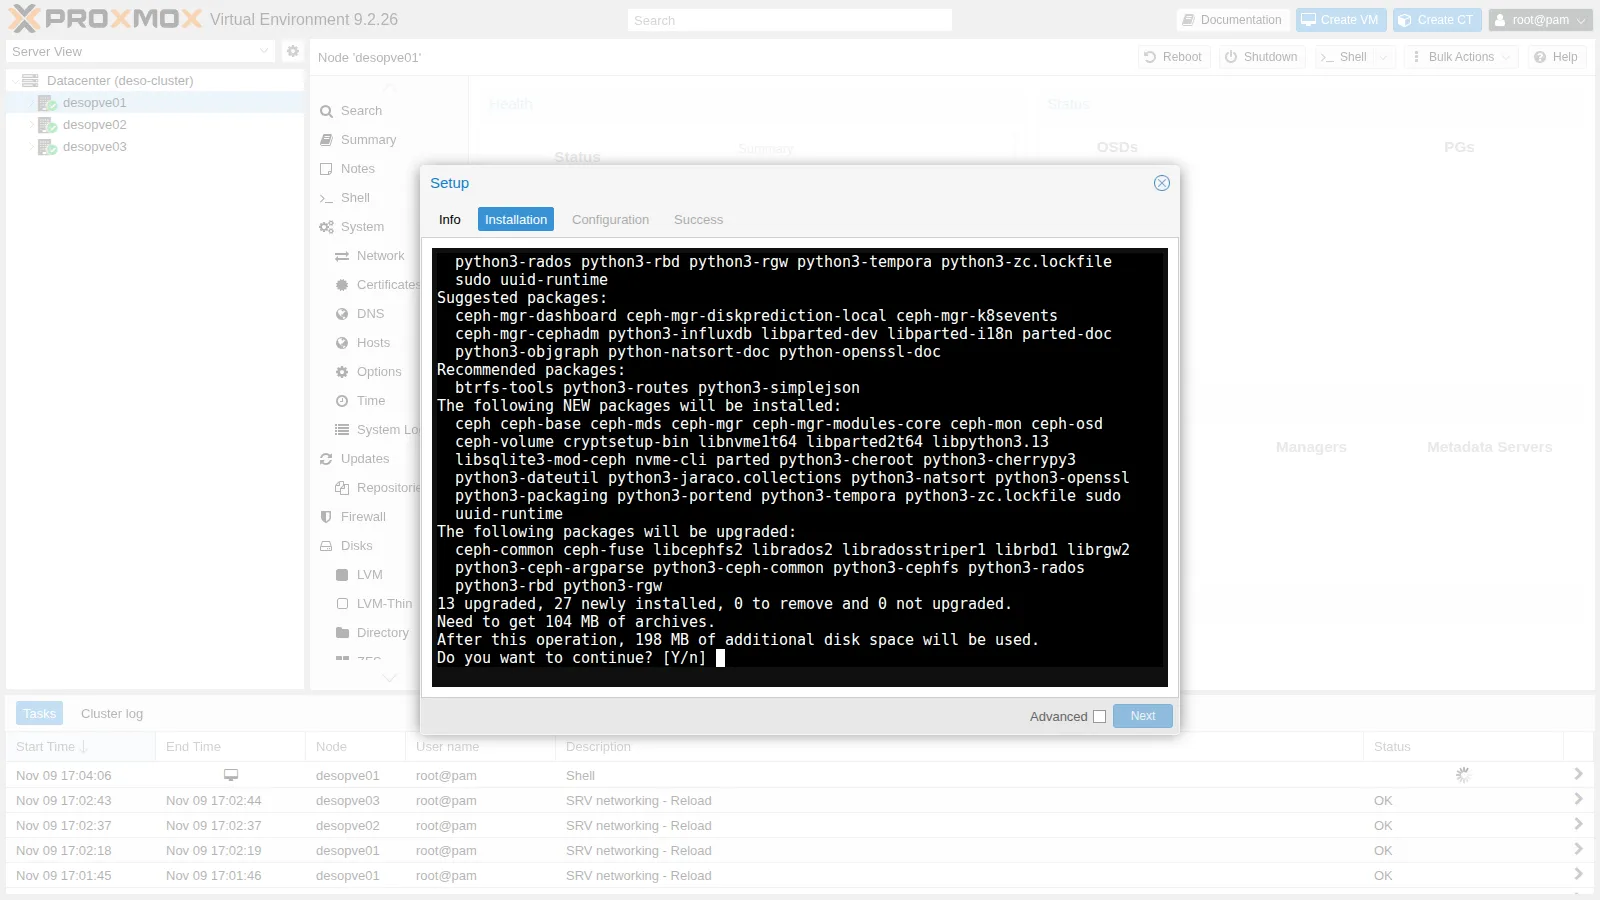
L’installazione dura circa un minuto: i pacchetti arrivano da
download.proxmox.comattraverso il proxy del laboratorio. -
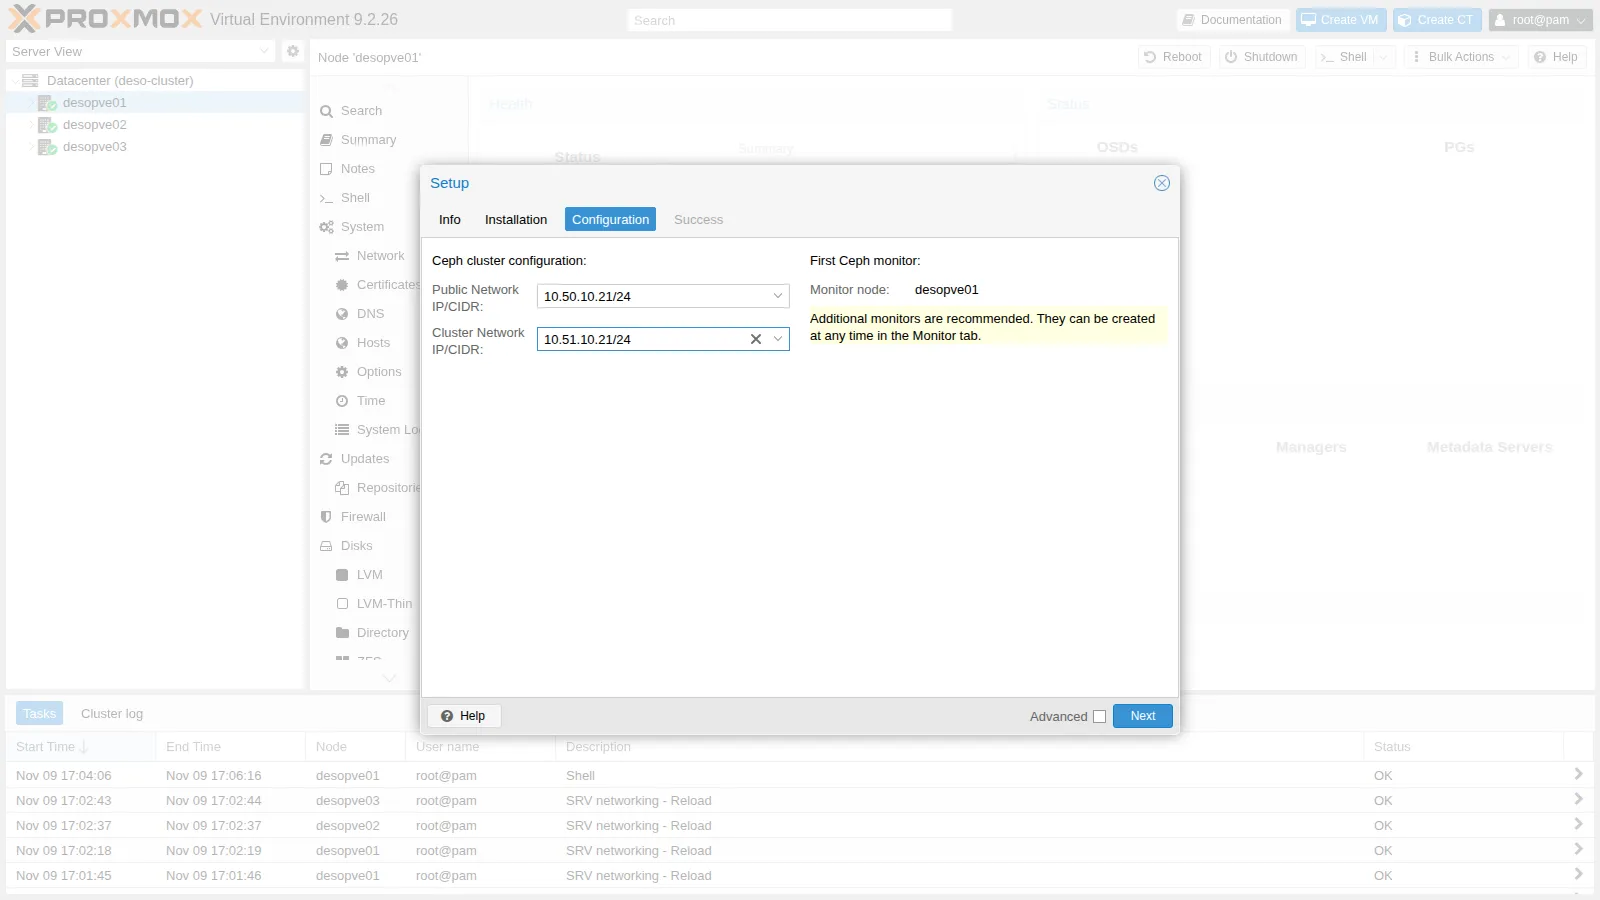
Next → Configuration: qui si crea la configurazione del cluster Ceph, una sola volta per tutto il cluster.
- Public Network IP/CIDR:
10.50.10.21/24(VLAN 50); - Cluster Network IP/CIDR:
10.51.10.21/24(VLAN 51). - Repliche e repliche minime restano ai valori predefiniti 3 e 2 (sono nelle opzioni Advanced).
- Public Network IP/CIDR:
-
Next: Proxmox scrive
/etc/pve/ceph.conf, crea il primo monitor e il primo manager sudesopve01.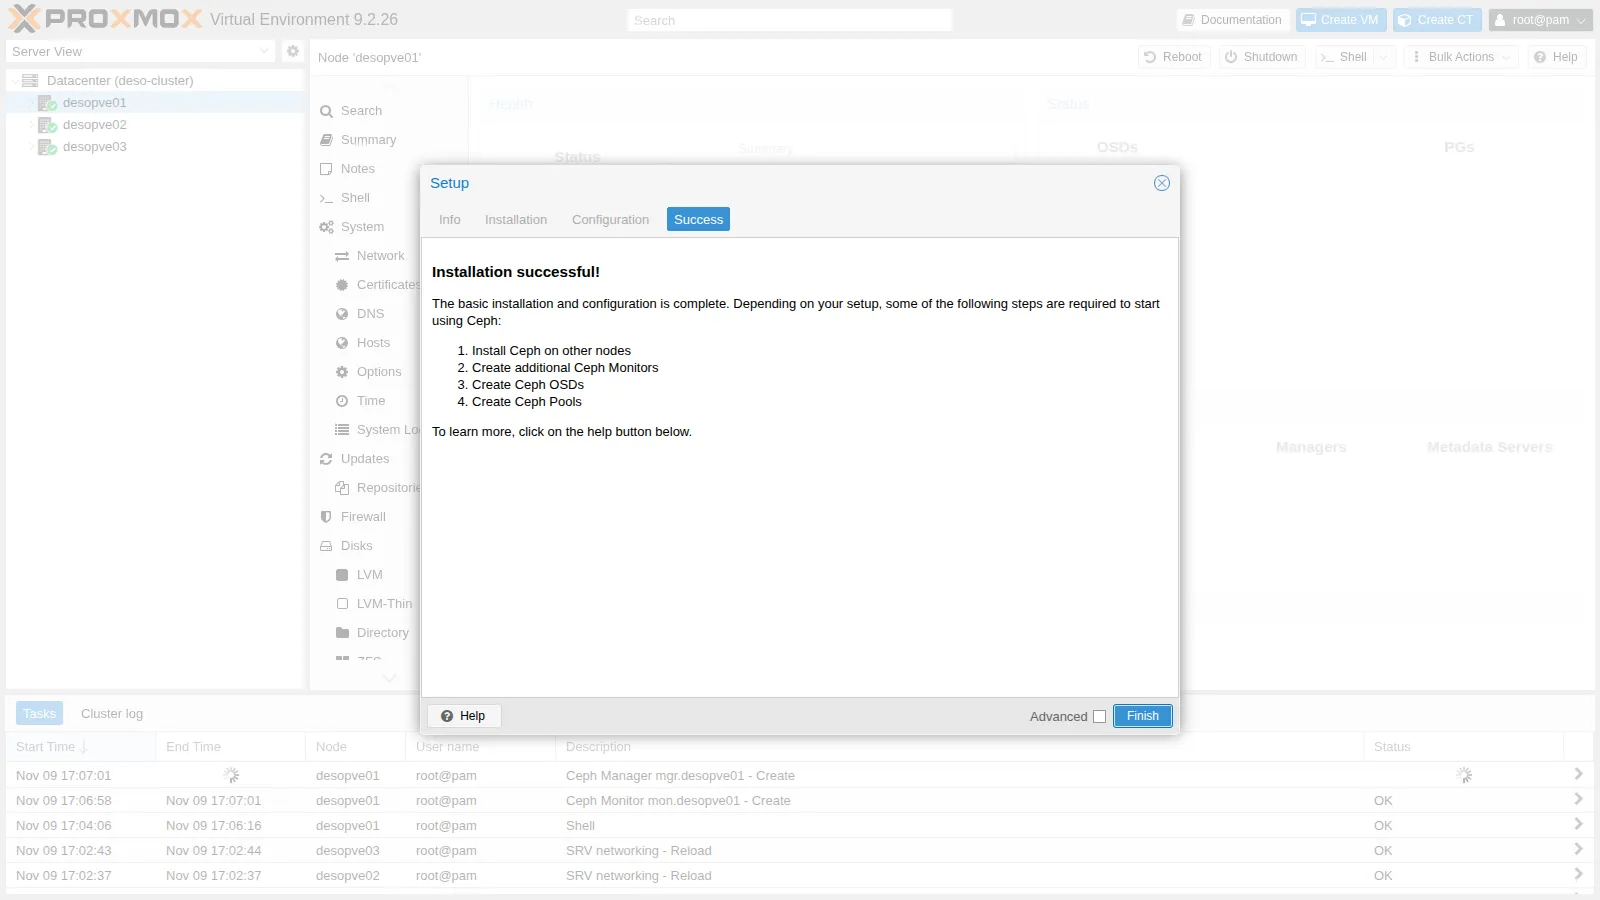
root@desopve01 cat /etc/pve/ceph.confOutput [global]auth_client_required = cephxauth_cluster_required = cephxauth_service_required = cephxcluster_network = 10.51.10.21/24fsid = cfd9bc4d-a092-487e-9c25-2a042c84bbbfmon_allow_pool_delete = truemon_host = 10.50.10.21ms_bind_ipv4 = truems_bind_ipv6 = falseosd_pool_default_min_size = 2osd_pool_default_size = 3public_network = 10.50.10.21/24...- Il file sta in
/etc/pve, quindi è già uguale su tutti i nodi del cluster Proxmox. - Le reti sono scritte con l’indirizzo del nodo (
10.50.10.21/24): Ceph usa solo la parte di rete, cioè 10.50.10.0/24, quindi funziona per tutti i nodi.
- Il file sta in
-
Sugli altri due nodi installa i pacchetti da riga di comando, confermando con Y:
root@desopve02 pveceph install --repository no-subscription --version tentacleOutput ...reloading API to load new Ceph RADOS library...root@desopve02 ceph --versionOutput ceph version 20.2.5 (18a25ea6153a998538b0b02f656cd62b4cadaca4) tentacle (stable)La configurazione non va ripetuta: i nodi leggono
ceph.confda/etc/pve.
3. Monitor e manager su tutti i nodi
Sezione intitolata “3. Monitor e manager su tutti i nodi”-
Ceph → Monitor → Create (riquadro Monitor), Host
desopve02. Poi Create nel riquadro Manager, sempre perdesopve02.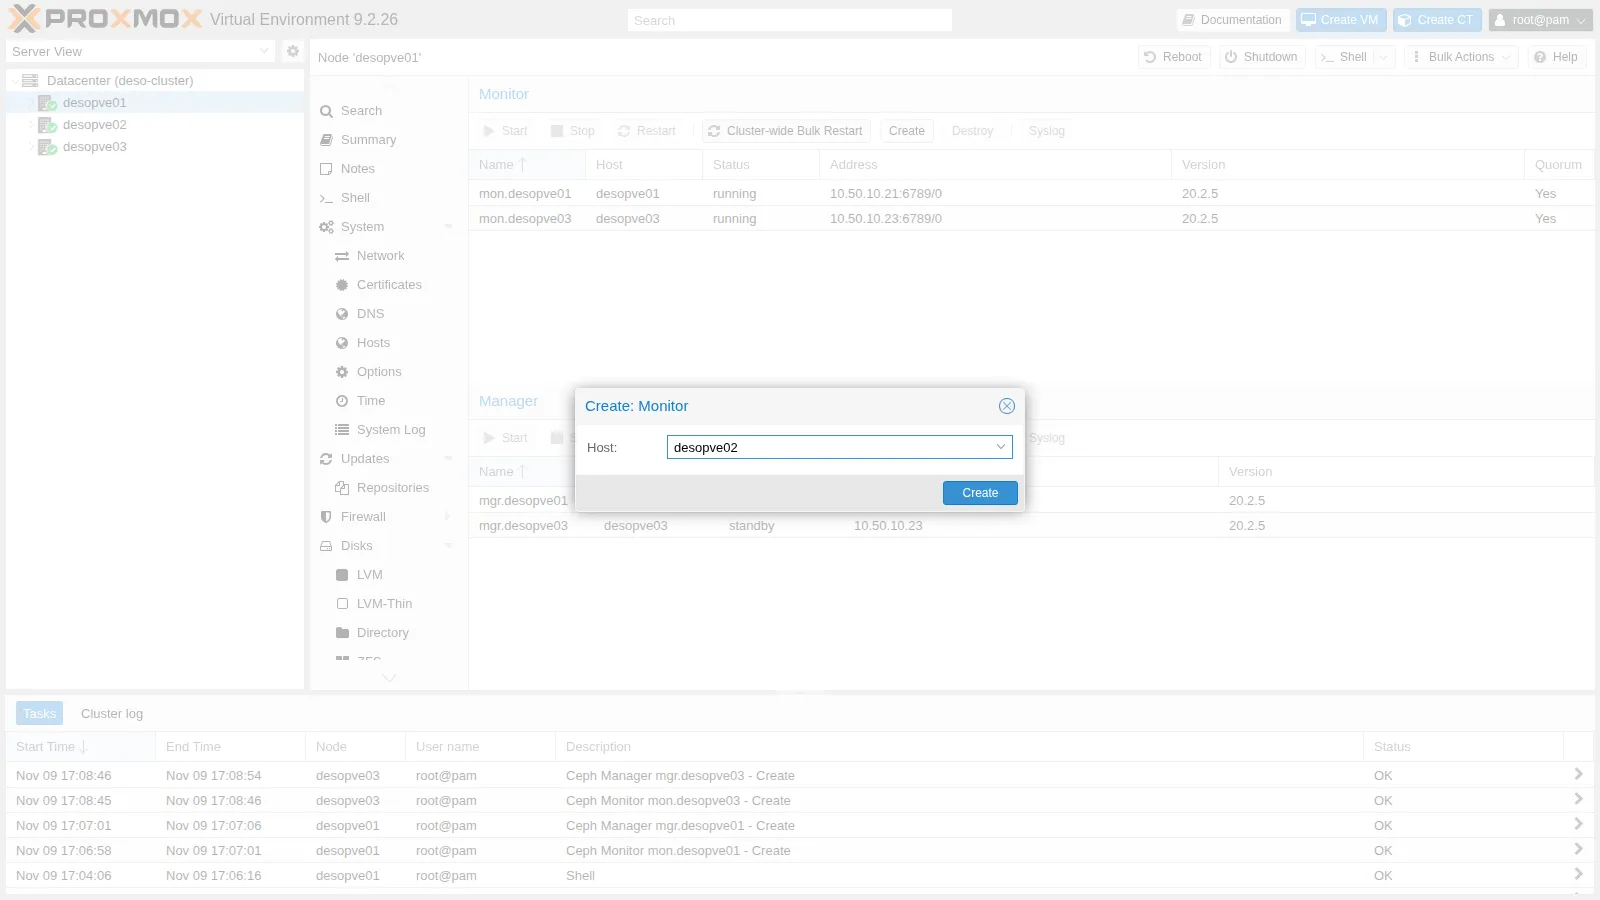
-
Per
desopve03usa la riga di comando:root@desopve03 pveceph mon createOutput monmaptool: writing epoch 1 to /tmp/monmap (2 monitors)...root@desopve03 pveceph mgr createOutput starting service '[email protected]' -
Il risultato: tre monitor in quorum e tre manager, uno attivo e due in attesa.
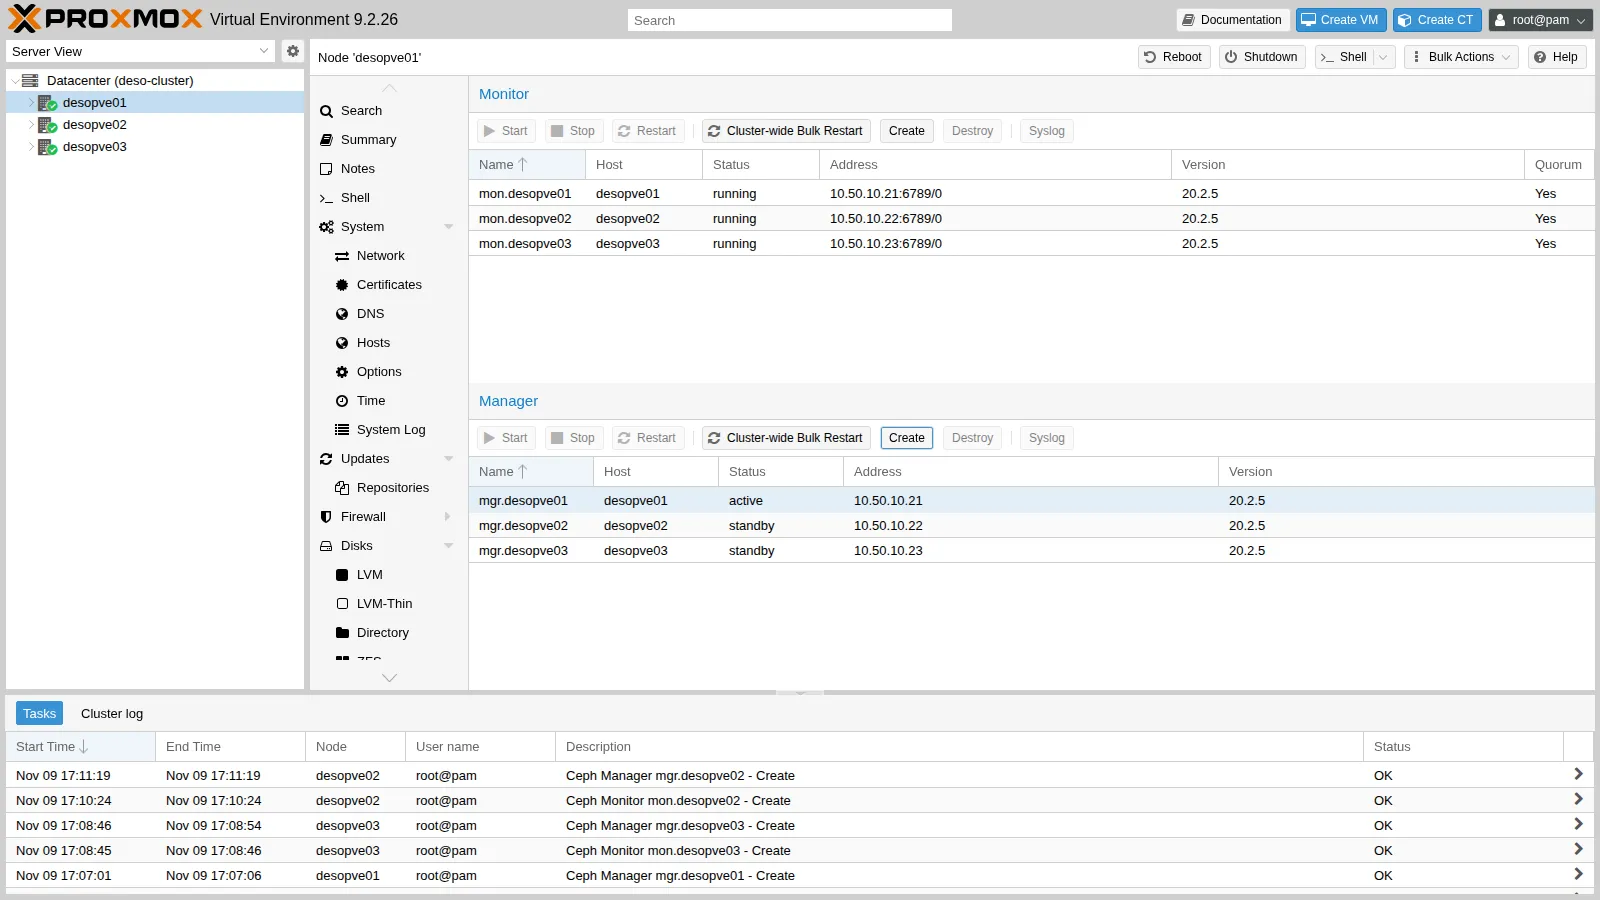
root@desopve01 ceph mon statOutput e3: 3 mons at {desopve01=[v2:10.50.10.21:3300/0,v1:10.50.10.21:6789/0],desopve02=[v2:10.50.10.22:3300/0,v1:10.50.10.22:6789/0],desopve03=[v2:10.50.10.23:3300/0,v1:10.50.10.23:6789/0]} removed_ranks: {} disallowed_leaders: {}, election epoch 12, leader 0 desopve01, quorum 0,1,2 desopve01,desopve03,desopve02I monitor ascoltano sulla rete pubblica di Ceph (10.50.10.x), non sulla rete di gestione.
4. Gli OSD
Sezione intitolata “4. Gli OSD”-
Nodo desopve01 → Ceph → OSD → Create: OSD. Disk
/dev/sdc, DB Disk use OSD disk: database e journal di BlueStore stanno sullo stesso disco.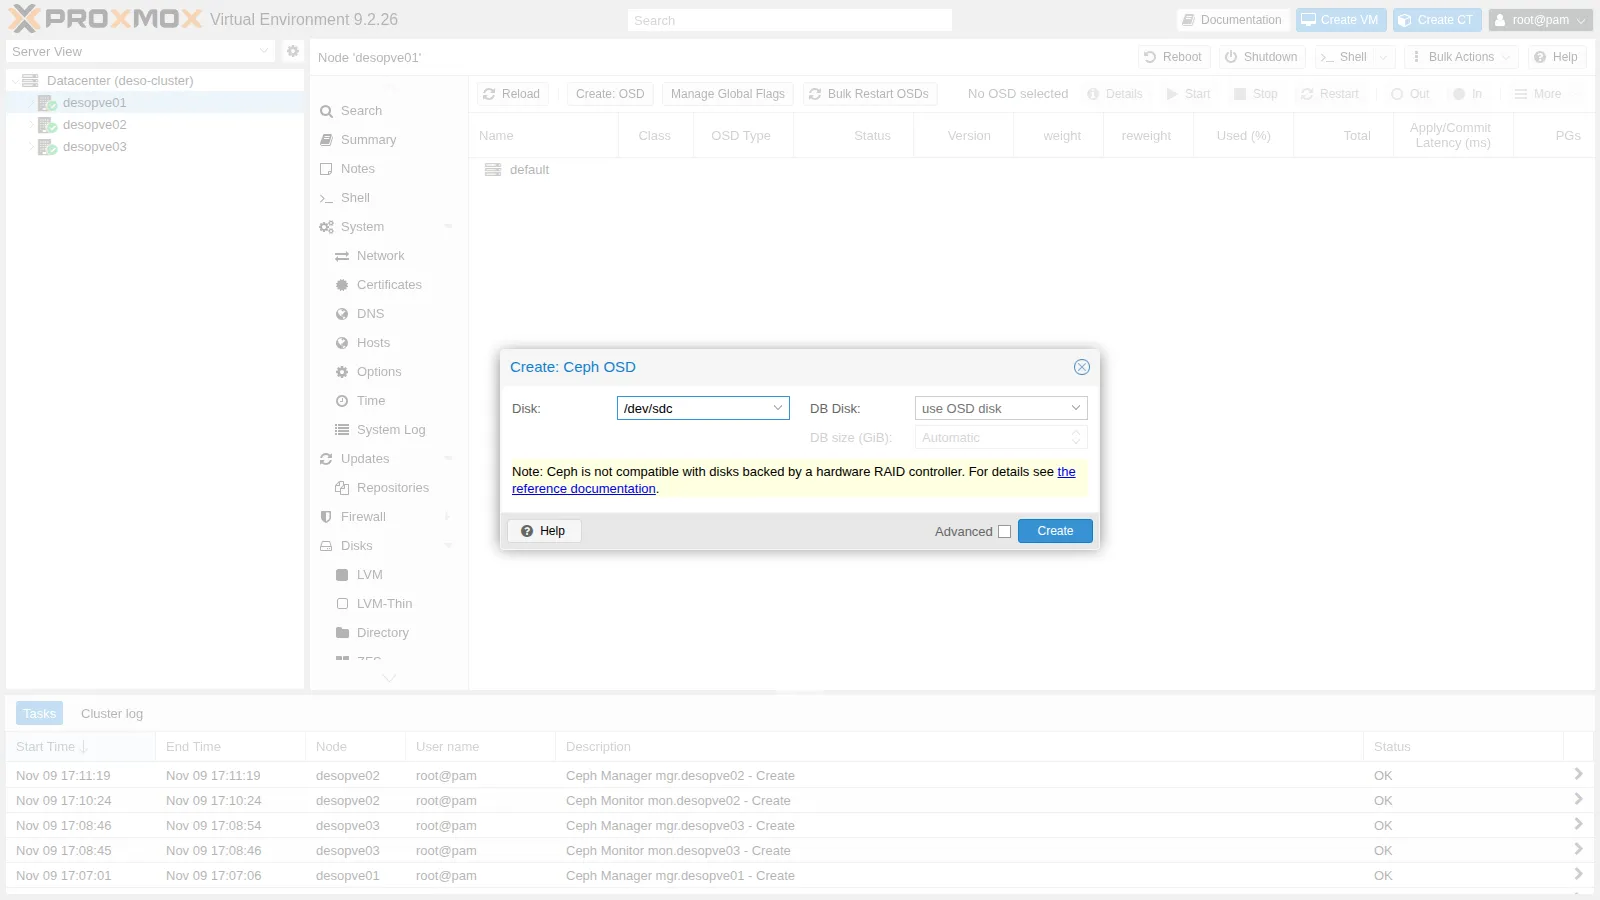
In produzione, con dischi rotativi, si mette il DB su un SSD veloce (DB Disk); con dischi tutti SSD o NVMe non serve. La nota ricorda che Ceph vuole vedere i dischi direttamente: niente controller RAID hardware.
-
Gli altri cinque OSD da riga di comando, due per nodo:
root@desopve01 pveceph osd create /dev/sddOutput ...--> ceph-volume lvm create successful for: /dev/sddroot@desopve02 pveceph osd create /dev/sdcpveceph osd create /dev/sddroot@desopve03 pveceph osd create /dev/sdcpveceph osd create /dev/sddOgni comando termina con la stessa riga
ceph-volume lvm create successful.Ogni OSD è un volume LVM creato da
ceph-volumesull’intero disco, con BlueStore come formato:root@desopve01 ceph-volume lvm list /dev/sdc | grep -E "osd id|objectstore|block device"Output block device /dev/ceph-92836807-f4fd-4193-a256-dc9f557c2df7/osd-block-eff89a0e-fa94-462d-ad23-49e431295708objectstore bluestoreosd id 0 -
L’albero degli OSD mostra la gerarchia che CRUSH usa:
root default→ tre host → due OSD ciascuno.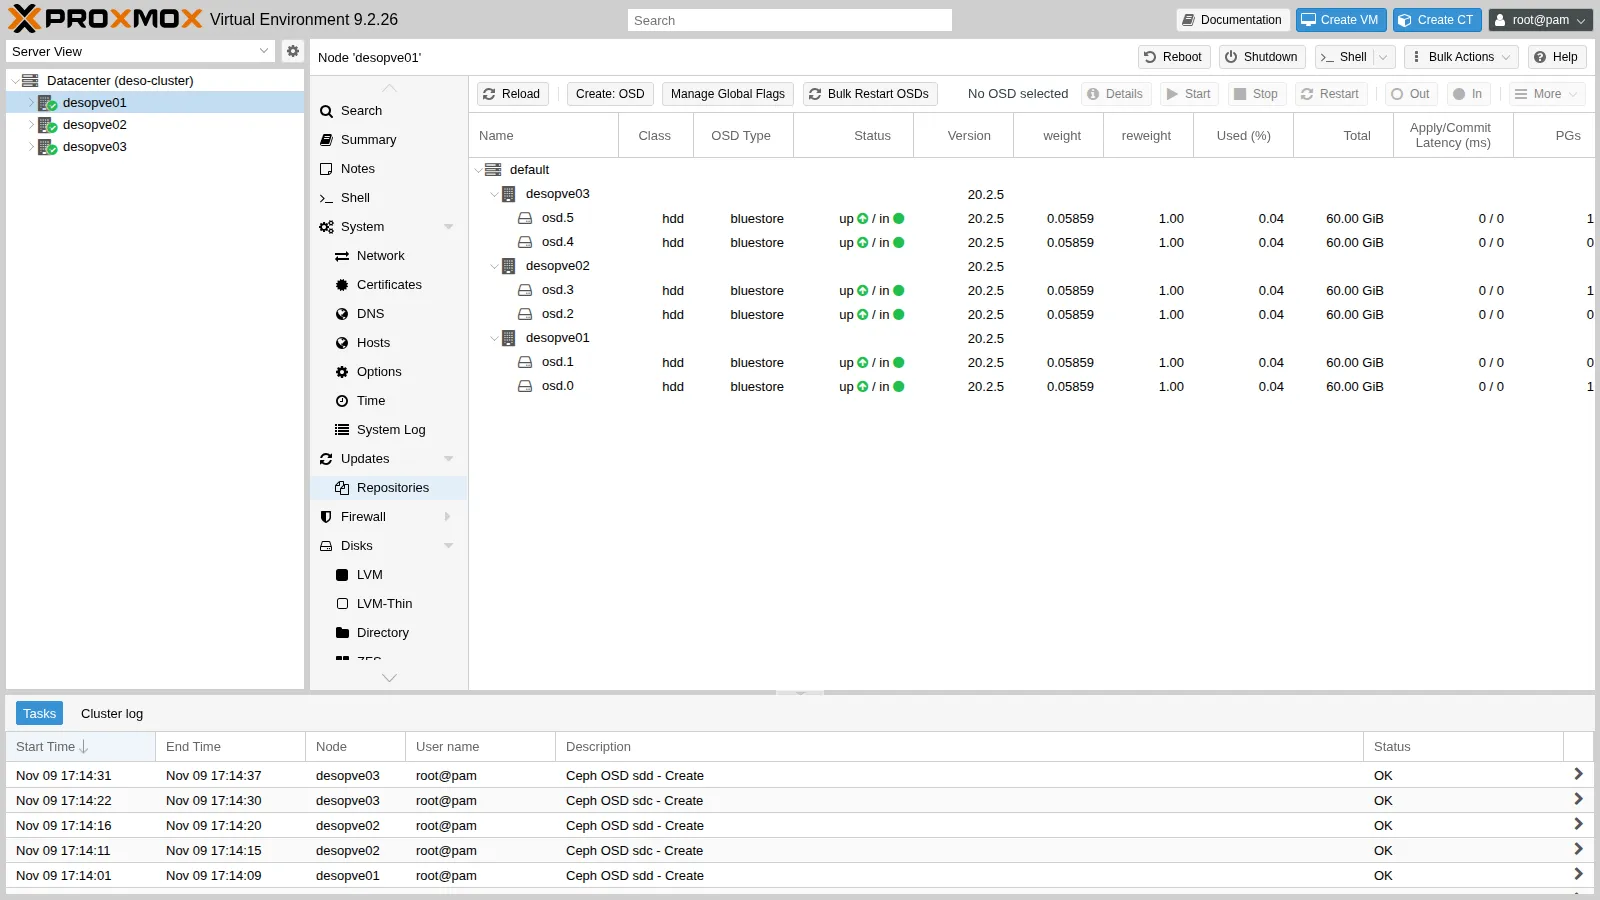
root@desopve01 ceph osd treeOutput ID CLASS WEIGHT TYPE NAME STATUS REWEIGHT PRI-AFF-1 0.35156 root default-3 0.11719 host desopve010 hdd 0.05859 osd.0 up 1.00000 1.000001 hdd 0.05859 osd.1 up 1.00000 1.00000-5 0.11719 host desopve022 hdd 0.05859 osd.2 up 1.00000 1.000003 hdd 0.05859 osd.3 up 1.00000 1.00000-7 0.11719 host desopve034 hdd 0.05859 osd.4 up 1.00000 1.000005 hdd 0.05859 osd.5 up 1.00000 1.00000- WEIGHT è la capacità in TiB (60 GiB = 0,0586 TiB): CRUSH distribuisce i dati in proporzione.
- CLASS
hddè la device class rilevata in automatico. Nel lab 18 la usiamo per costruire regole CRUSH diverse.
5. Pool RBD e storage del cluster
Sezione intitolata “5. Pool RBD e storage del cluster”-
Ceph → Pools → Create: Name
rbd-vm, Size 3, Min. Size 2, PG Autoscale Modeon, Add as Storage spuntato.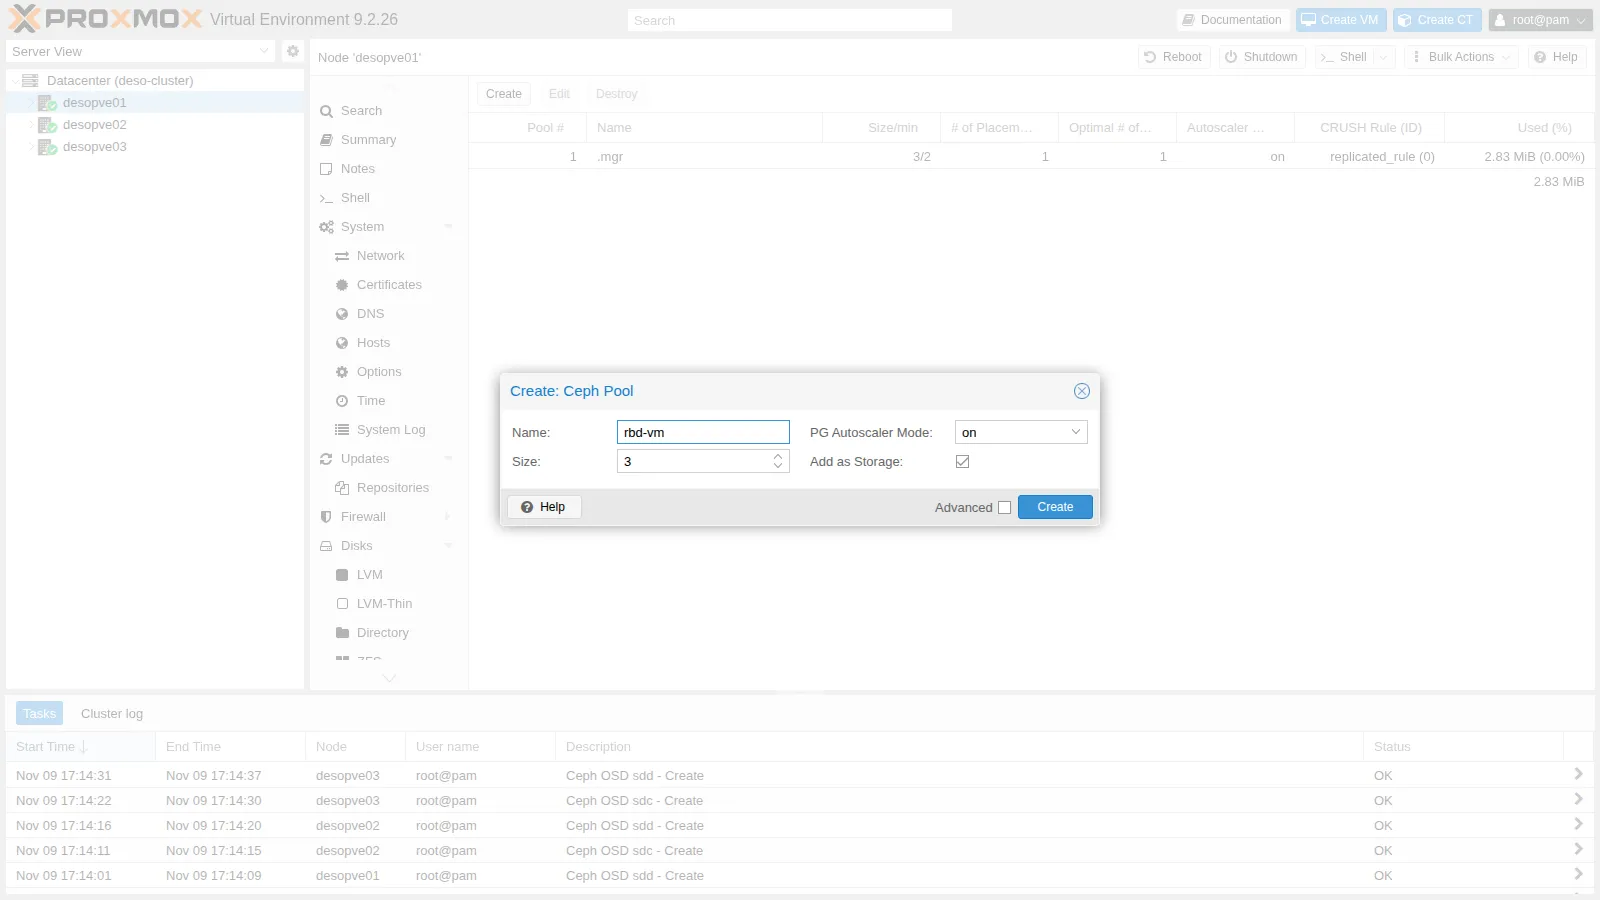
Add as Storage crea anche lo storage
rbd-vmdi Proxmox, disponibile su tutti i nodi per dischi di VM e container:root@desopve01 grep -A3 "rbd: rbd-vm" /etc/pve/storage.cfgOutput rbd: rbd-vmcontent rootdir,imageskrbd 0pool rbd-vm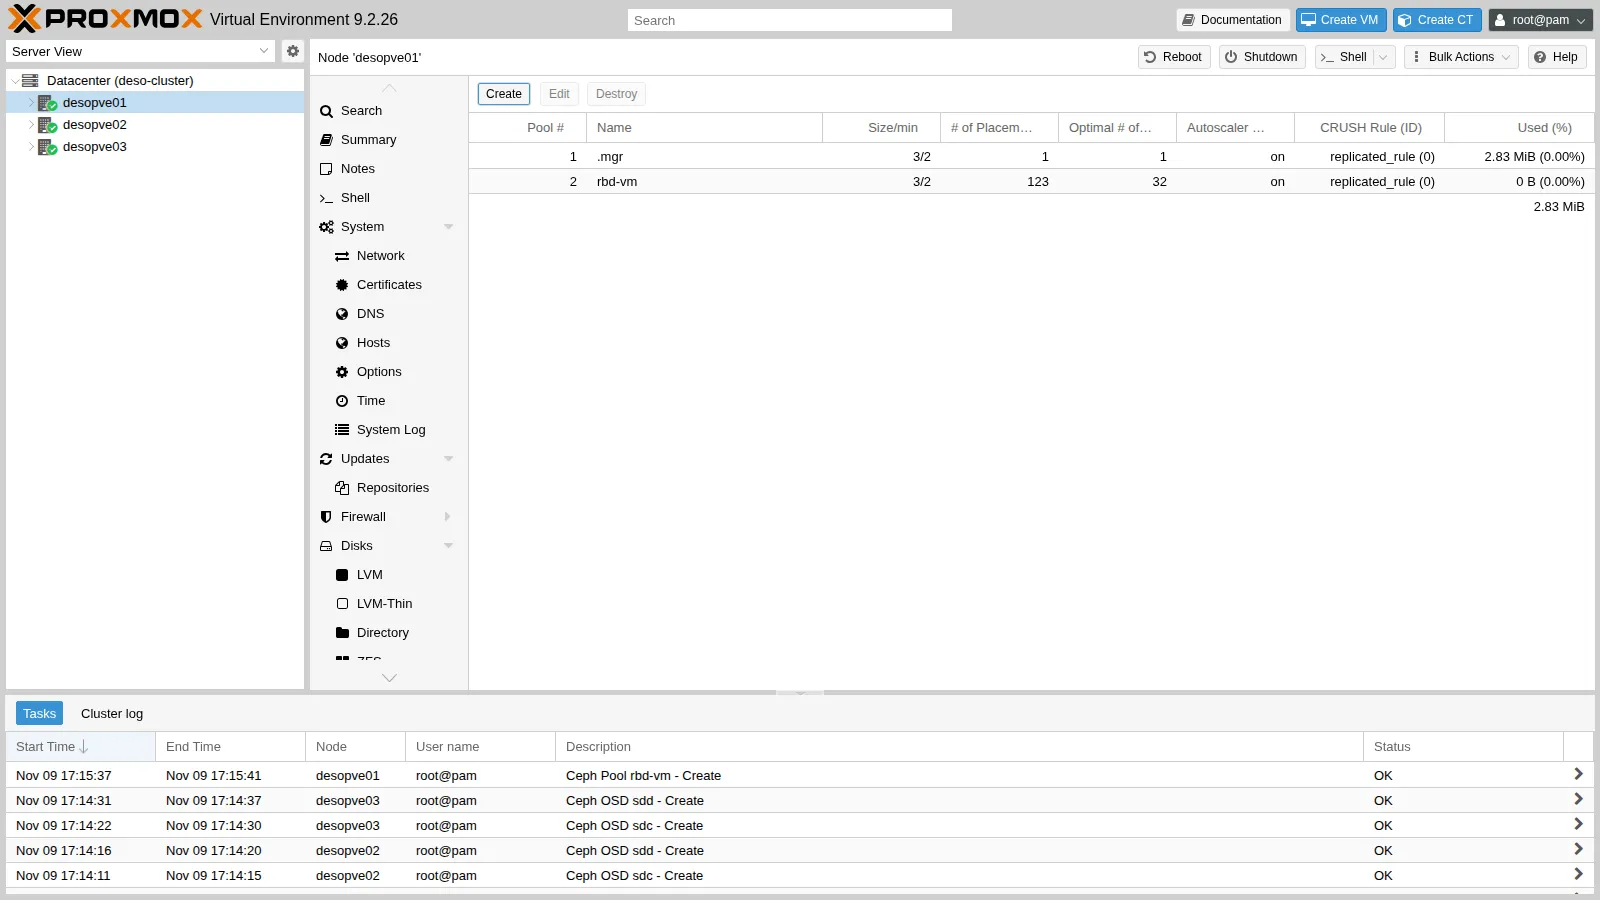
-
Il pool nasce con 128 PG; l’autoscaler, che vede un pool vuoto, li riduce subito a 32. Lo stato dell’autoscaler qui sotto è stato ripreso dopo il passo 6, quando il pool contiene già il disco della VM 100:
root@desopve01 ceph osd pool autoscale-statusOutput POOL SIZE TARGET SIZE RATE RAW CAPACITY RATIO FINAL RATIO TARGET RATIO EFFECTIVE RATIO BIAS PG_NUM NEW PG_NUM AUTOSCALE BULK.mgr 966.6k 3.0 359.9G 0.0000 0.0050 1.0 1 on Falserbd-vm 6561M 3.0 359.9G 0.0534 0.1600 1.0 32 on False...Il pool
.mgrlo crea Ceph per i moduli del manager: non va toccato. -
Ceph → Configuration mostra
ceph.confe la CRUSH map: la regolareplicated_rulesceglie un OSD da ciascun host diverso (chooseleaf_firstndi tipohost).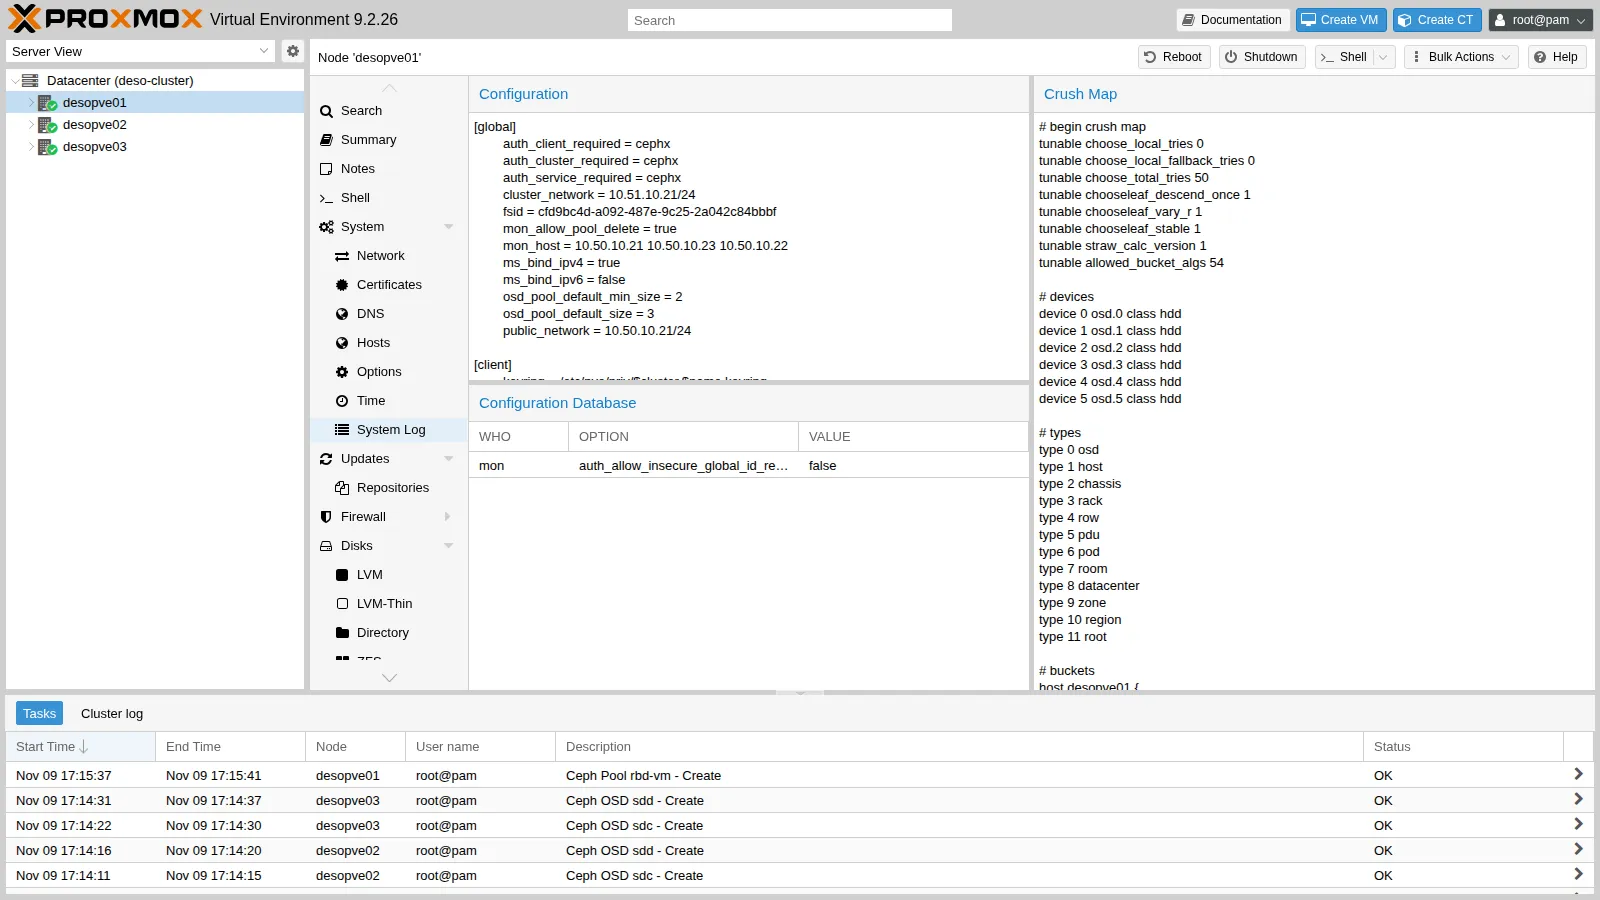
root@desopve01 ceph osd crush rule dump replicated_rule | grep -A2 chooseleafOutput "op": "chooseleaf_firstn","num": 0,"type": "host" -
La pagina Ceph del nodo riassume lo stato:
HEALTH_OK, 6 OSD up e in, tutti i PGactive+clean, tre monitor e tre manager.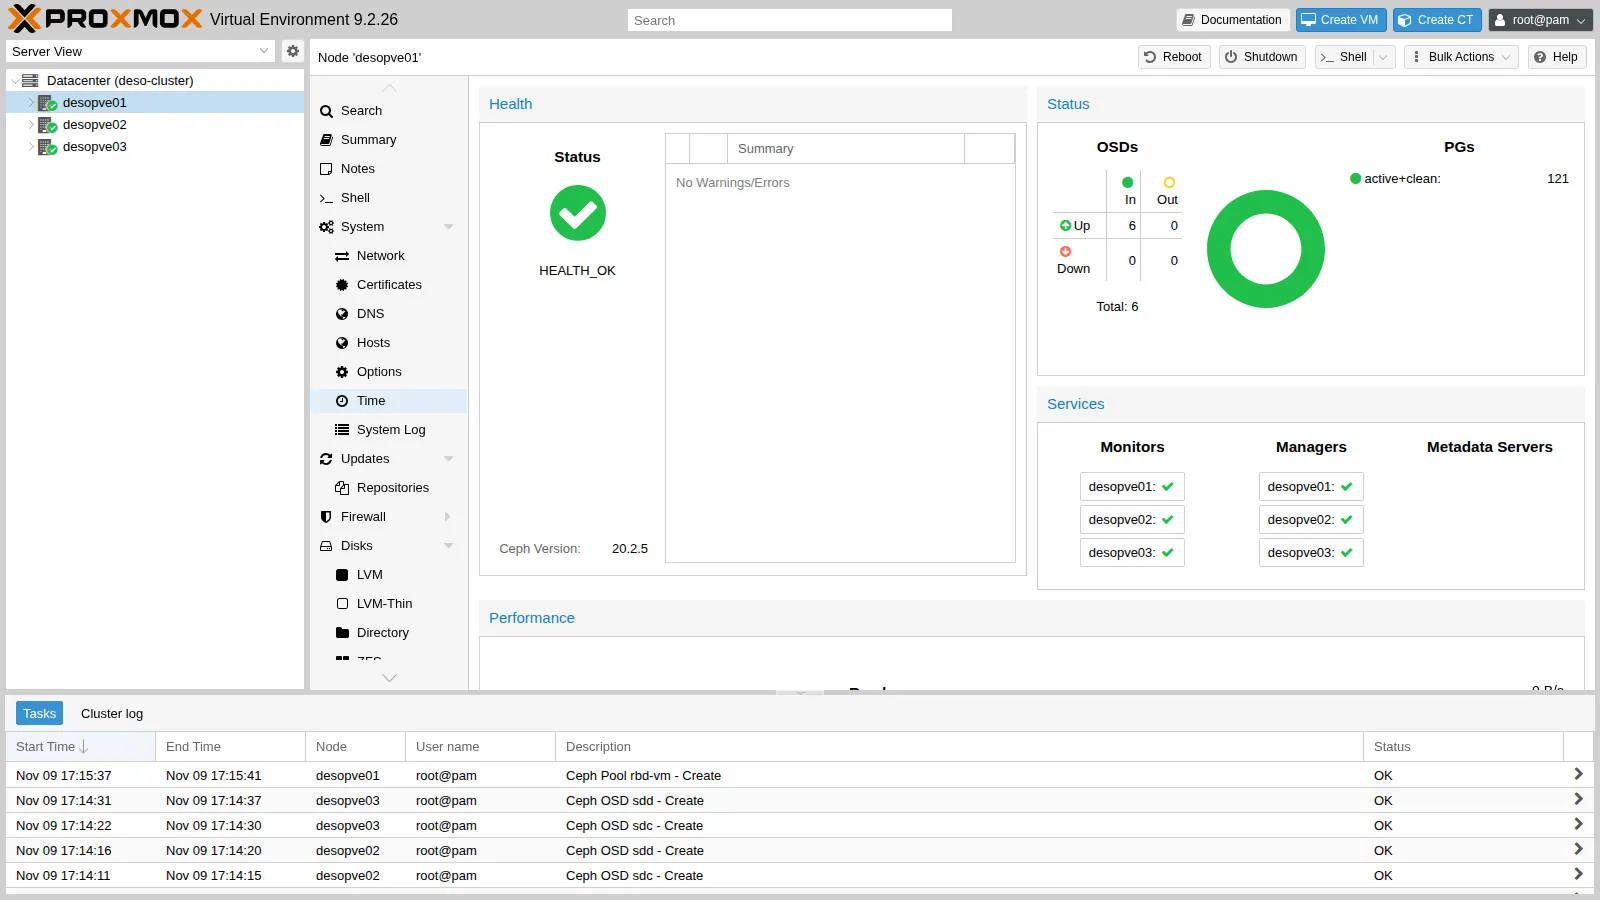
6. Una VM su Ceph e la migrazione senza copia del disco
Sezione intitolata “6. Una VM su Ceph e la migrazione senza copia del disco”-
Sposta a caldo il disco della VM 100 da
local-zfsal pool RBD (come nel lab 08):root@desopve01 time qm disk move 100 scsi0 rbd-vm --delete 1Output mirror-scsi0: Completed successfully.mirror-scsi0: mirror-job finishedremoving source volume 'local-zfs:vm-100-disk-0' after successful copyreal 3m55.737sroot@desopve01 rbd -p rbd-vm ls -lOutput NAME SIZE PARENT FMT PROT LOCKvm-100-disk-0 16 GiB 2 exclroot@desopve01 rbd info rbd-vm/vm-100-disk-0 | grep -E "size|order|features"Output size 16 GiB in 4096 objectsorder 22 (4 MiB objects)features: layering, exclusive-lock, object-map, fast-diff, deep-flatten- Il disco è diventato un’immagine RBD di 4096 oggetti da 4 MiB, ognuno replicato tre volte.
exclindica il lock esclusivo: solo il nodo che fa girare la VM può scriverci.
-
Migra la VM a caldo su
desopve02: Migrate → Target nodedesopve02. Il dialogo non chiede uno storage di destinazione: il disco è già condiviso.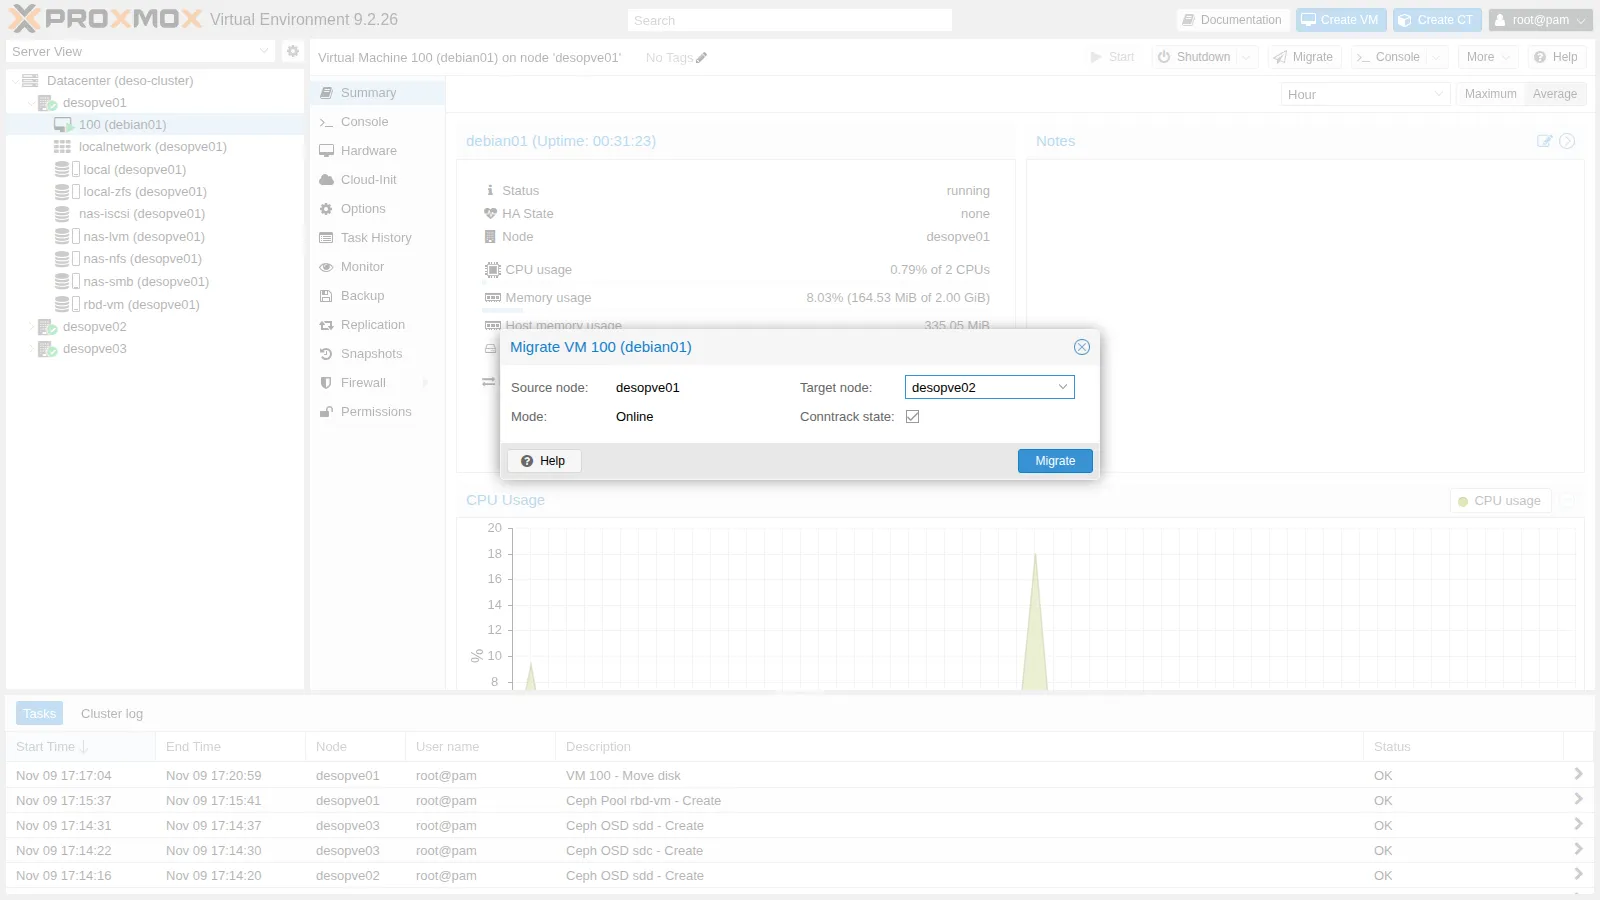
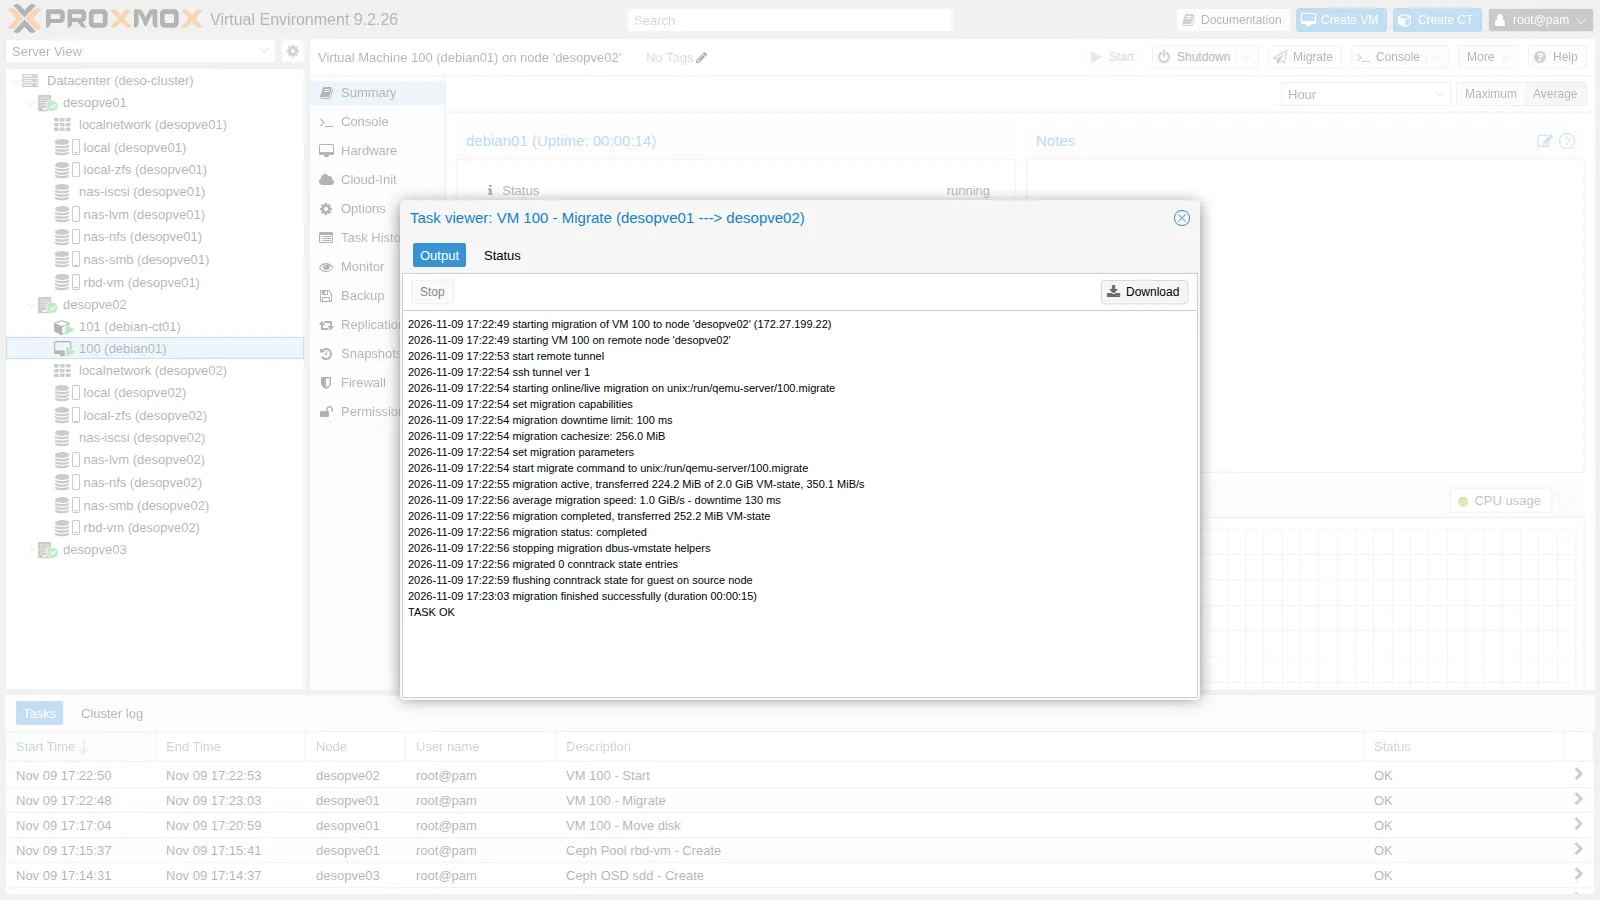 2026-11-09 17:22:54 migration downtime limit: 100 ms2026-11-09 17:22:56 average migration speed: 1.0 GiB/s - downtime 130 ms2026-11-09 17:23:03 migration finished successfully (duration 00:00:15)
Passa solo la RAM della VM: il disco resta su Ceph. I tre valori del log misurano cose diverse, come spiega il Lab 48: il task è durato 15 secondi; i 130 ms sono il fermo che QEMU riporta per il passaggio finale, non la pausa vista da un client; e l’
average migration speednon è una velocità misurata ma la RAM totale del guest divisa per la durata della fase di memoria in secondi interi, quindi con 2 GiB di RAM 1,0 GiB/s dice solo che questa fase è durata circa 2 secondi. Per confronto, nel Lab 11 la stessa VM, con il disco da 16 GiB su storage locale, ha richiesto 1 minuto e 13 secondi, di cui 57 per il mirror del disco. -
Riporta la VM su
desopve01:root@desopve02 qm migrate 100 desopve01 --onlineOutput ...2026-11-09 17:25:55 migration finished successfully (duration 00:00:14)
7. CephFS per ISO, template e backup
Sezione intitolata “7. CephFS per ISO, template e backup”RBD offre dischi a blocchi per VM e container. Per i file (ISO, template, backup) Ceph offre CephFS, un file system condiviso montato su tutti i nodi. CephFS ha bisogno di almeno un MDS.
-
Crea due metadata server, uno attivo e uno di riserva:
root@desopve01 pveceph mds createOutput starting service '[email protected]'root@desopve02 pveceph mds createOutput starting service '[email protected]' -
Ceph → CephFS → Create CephFS: Name
cephfs, Placement Groups 128, Add as Storage spuntato.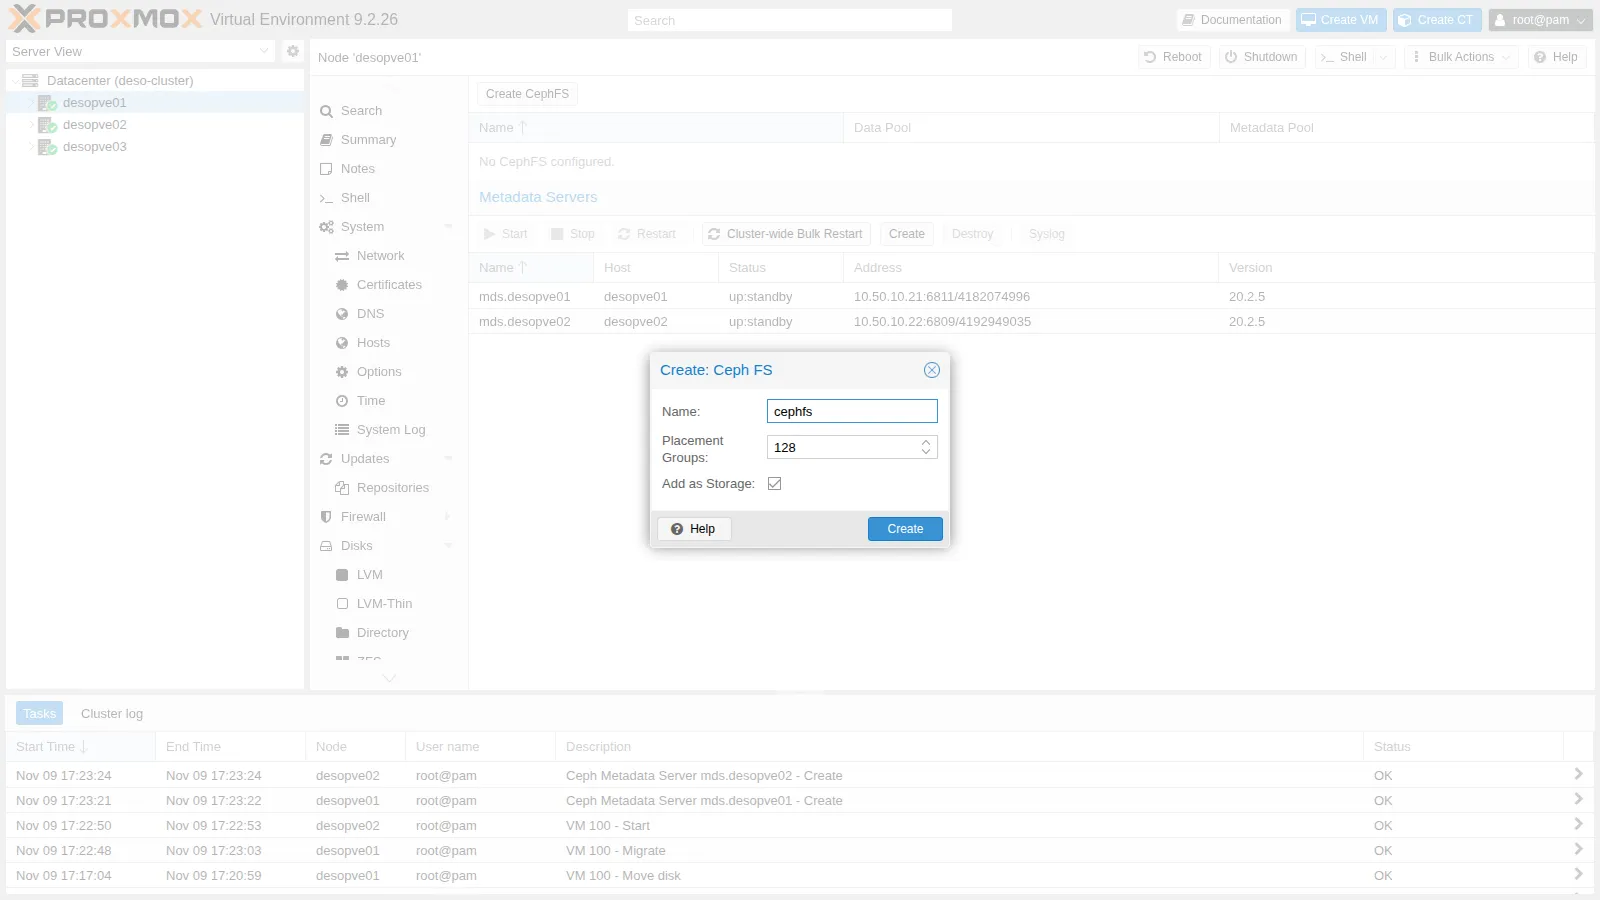
Proxmox crea due pool,
cephfs_dataper i contenuti ecephfs_metadataper i metadati, e lo storagecephfsmontato in/mnt/pve/cephfssu ogni nodo.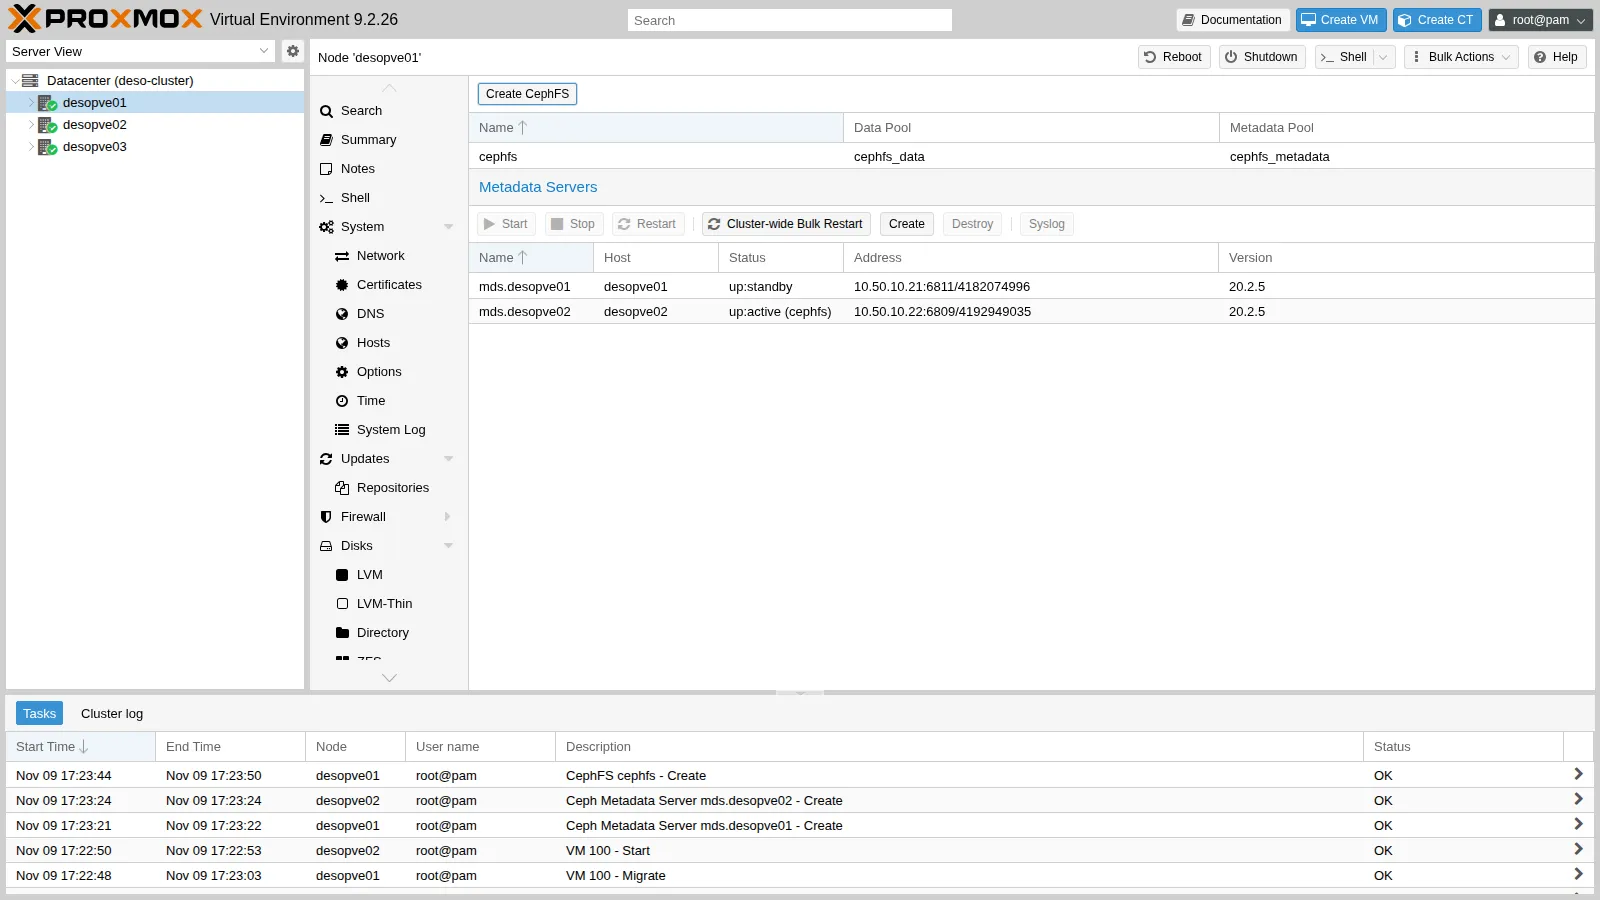
-
Verifica e prova a copiarci la ISO Debian:
root@desopve01 ceph fs statusOutput cephfs - 3 clients======RANK STATE MDS ACTIVITY DNS INOS DIRS CAPS0 active desopve02 Reqs: 0 /s 14 17 16 15POOL TYPE USED AVAILcephfs_metadata metadata 174k 105Gcephfs_data data 0 105GSTANDBY MDSdesopve01root@desopve01 grep -A4 "cephfs: cephfs" /etc/pve/storage.cfgOutput cephfs: cephfspath /mnt/pve/cephfscontent iso,vztmpl,backupfs-name cephfsroot@desopve01 cp /mnt/pve/nas-smb/template/iso/debian-13.7.0-amd64-netinst.iso /mnt/pve/cephfs/template/iso/pvesm list cephfsOutput Volid Format Type Size VMIDcephfs:iso/debian-13.7.0-amd64-netinst.iso iso iso 792723456Ora la ISO è visibile da tutti e tre i nodi senza dipendere dal NAS.
Verifica e test
Sezione intitolata “Verifica e test”-
Stato generale:
root@desopve01 ceph -sOutput cluster:id: cfd9bc4d-a092-487e-9c25-2a042c84bbbfhealth: HEALTH_OKservices:mon: 3 daemons, quorum desopve01,desopve03,desopve02 (age 15m) [leader: desopve01]mgr: desopve01(active, since 18m), standbys: desopve03, desopve02mds: 1/1 daemons up, 1 standbyosd: 6 osds: 6 up (since 11m), 6 in (since 11m); 1 remapped pgsdata:volumes: 1/1 healthypools: 4 pools, 183 pgsobjects: 1.71k objects, 6.5 GiBusage: 20 GiB used, 340 GiB / 360 GiB availpgs: 183 active+cleanLa riga
1 remapped pgs, come lo statoactive+remapped+backfillingche può comparire per qualche minuto durante la creazione dei pool, indica che l’autoscaler sta cambiando il numero di PG e spostando i dati. È normale e si risolve da solo. -
Quanto spazio c’è davvero:
root@desopve01 ceph dfOutput --- RAW STORAGE ---CLASS SIZE AVAIL USED RAW USED %RAW USEDhdd 360 GiB 340 GiB 20 GiB 20 GiB 5.48TOTAL 360 GiB 340 GiB 20 GiB 20 GiB 5.48--- POOLS ---POOL ID PGS STORED OBJECTS USED %USED MAX AVAIL.mgr 1 1 961 KiB 2 2.8 MiB 0 106 GiBrbd-vm 2 41 6.4 GiB 1.69k 19 GiB 5.71 106 GiBcephfs_data 3 108 0 B 1 0 B 0 106 GiBcephfs_metadata 4 32 52 KiB 22 243 KiB 0 106 GiB- Raw: 6 dischi × 60 GiB = 360 GiB.
- STORED contro USED: il disco della VM contiene 6,4 GiB di dati, che con tre copie occupano 19 GiB.
- MAX AVAIL 106 GiB: circa un terzo dello spazio libero (340 / 3 = 113 GiB), meno il margine che Ceph tiene per non riempire gli OSD (full ratio). Con la replica a 3 si usa un terzo della capacità grezza.
-
Distribuzione sugli OSD:
root@desopve01 ceph osd dfOutput ID CLASS WEIGHT REWEIGHT SIZE RAW USE DATA OMAP META AVAIL %USE VAR PGS STATUS0 hdd 0.05859 1.00000 60 GiB 2.5 GiB 2.5 GiB 289 KiB 61 MiB 57 GiB 4.19 0.77 94 up1 hdd 0.05859 1.00000 60 GiB 4.1 GiB 4.0 GiB 287 KiB 96 MiB 56 GiB 6.76 1.23 88 up2 hdd 0.05859 1.00000 60 GiB 2.6 GiB 2.5 GiB 184 KiB 61 MiB 57 GiB 4.30 0.79 100 up3 hdd 0.05859 1.00000 60 GiB 4.0 GiB 3.9 GiB 281 KiB 96 MiB 56 GiB 6.65 1.21 82 up4 hdd 0.05859 1.00000 60 GiB 3.4 GiB 3.3 GiB 280 KiB 96 MiB 57 GiB 5.61 1.02 86 up5 hdd 0.05859 1.00000 60 GiB 3.2 GiB 3.1 GiB 280 KiB 61 MiB 57 GiB 5.35 0.98 96 upTOTAL 360 GiB 20 GiB 19 GiB 1.6 MiB 473 MiB 340 GiB 5.48Ogni host ha circa un terzo dei dati: è l’effetto della regola CRUSH per host.
-
Migrazione: la VM 100 si sposta tra i nodi senza copiare il disco: un task di 15 secondi, con 130 ms di fermo riportato da QEMU.
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Rete: su
desopve01-03la schedanic2porta due VLAN senza gateway:nic2.50(10.50.10.21-23/24, public network di Ceph) enic2.51(10.51.10.21-23/24, cluster network). - Ceph Tentacle 20.2.5 su
desopve01-03,HEALTH_OK:- 3 MON e 3 MGR (attivo su
desopve01), 2 MDS (attivo sudesopve02, standby sudesopve01); - 6 OSD BlueStore su
/dev/sdce/dev/sdddi ogni nodo (osd.0-osd.5), classehdd; - pool
rbd-vm(replica 3/2, autoscaler attivo) e poolcephfs_data/cephfs_metadata.
- 3 MON e 3 MGR (attivo su
- Storage del cluster: si aggiungono
rbd-vm(RBD, dischi di VM e container) ecephfs(ISO, template, backup), che contiene la ISO Debian 13.7. - VM 100
debian01: accesa sudesopve01, con il disco surbd-vm:vm-100-disk-0. Non è più sulocal-zfs. - CT 101: invariato, acceso su
desopve02. desopve04: invariato, fuori dal cluster.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Ceph unisce i dischi di più nodi: i MON tengono la mappa e il quorum, gli OSD scrivono e replicano i dati, i MGR raccolgono statistiche, gli MDS servono solo per CephFS.
- I dati di un pool sono divisi in PG e CRUSH li distribuisce tra gli host secondo una regola. Con la replica 3/2 si usa un terzo della capacità grezza.
- Il wizard di Proxmox installa Ceph e scrive
ceph.confin/etc/pve, così tutto il cluster lo condivide. Gli altri nodi ricevono solo i pacchetti. - Le reti di Ceph vanno separate dalla gestione: con le VLAN basta una scheda.
- Con il disco su RBD, una VM migra in pochi secondi perché si sposta solo la RAM.
- CephFS offre a tutti i nodi uno spazio condiviso per ISO, template e backup, senza un NAS esterno.