

Lab 46 – Backup con vzdump: modalità, compressione, fleecing, retention e restore
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- Sistemi: nodi
desopve01-03, NASdesonas. Per misurare le interruzioni, unpingogni 0,2 s verso la VM dalla rete di gestione. - Credenziali:
root@pam→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Tre backup della stessa VM nelle tre modalità, snapshot, suspend e stop, con l’interruzione vista dalla rete misurata per ciascuna, per poter scegliere la modalità adatta a ogni tipo di guest.
- Lo stesso backup con le quattro opzioni di compressione, confrontando dimensioni e durate.
- Backup su NFS, CephFS e SMB, uno dei quali con il fleecing, con l’immagine temporanea creata e rimossa da vzdump.
- Un disco escluso dal backup di una VM, e i mount point dei container che restano fuori dal backup (bind mount) riconosciuti nel log.
- Un backup protetto che sopravvive a una retention (prune), prima simulata e poi applicata.
- Un job pianificato notturno sul pool
web, con retention e note automatiche, eseguito una volta a mano. - Una VM e un container ripristinati su un altro nodo e un altro storage, con nuovi indirizzi MAC.
Come funziona
Sezione intitolata “Come funziona”vzdump è lo strumento di backup integrato. Produce un file per guest (vzdump-qemu-<vmid>-<data>.vma.zst per le VM, vzdump-lxc-<vmid>-<data>.tar.zst per i container) su uno storage che accetta il contenuto backup. Ogni file contiene tutto: configurazione e dischi. Non ci sono backup incrementali: ogni volta si salva tutto il contenuto, compresso. Per i backup incrementali con deduplica serve Proxmox Backup Server (Lab 47).
Modalità.
| Modalità | VM | Container |
|---|---|---|
| snapshot | la VM resta accesa; QEMU tiene traccia dei blocchi mentre li copia, quindi il backup è coerente con l’istante di partenza. Con il guest agent, i filesystem vengono “congelati” per un attimo (fs-freeze/fs-thaw) |
il container viene sospeso per un attimo per fare lo snapshot dello storage (ZFS, Ceph, LVM-thin), poi la copia avviene dallo snapshot |
| suspend | la VM viene messa in pausa per avviare il backup, poi riparte. Resta per compatibilità: la documentazione consiglia invece snapshot | rsync a caldo, pausa, secondo rsync |
| stop | spegnimento pulito; la VM riparte appena il backup è avviato, e la copia continua in background | il container resta spento per tutta la durata del backup e riparte alla fine: fermo potenzialmente lungo |
Fleecing. Durante un backup snapshot, quando il guest vuole scrivere su un blocco non ancora copiato, QEMU deve prima copiare quel blocco sul backup. Se la destinazione è lenta, il guest rallenta. Con il fleecing il blocco vecchio va invece in un’immagine temporanea su uno storage veloce (idealmente locale, thin e con discard) e il guest scrive subito.
Retention (prune). Le opzioni keep-last, keep-hourly, keep-daily, keep-weekly, keep-monthly, keep-yearly dicono quanti backup tenere per ciascun intervallo. Dopo ogni backup del job, quelli non coperti vengono cancellati. Un backup protetto non viene mai cancellato dal prune.
Che cosa misurano il log e il ping. La durata in Finished Backup of VM … (hh:mm:ss) è quella dell’intero backup, in secondi interi. In modalità suspend e stop il log riporta anche resuming VM again after N seconds: vzdump conta, in secondi interi, dal momento in cui sospende la VM o ne avvia lo spegnimento al momento in cui la lascia ripartire. Quel valore non comprende ciò che succede dopo nel guest, come l’avvio che segue uno stop. Il ping ogni 0,2 s dalla rete di gestione mostra quello che vede un client: risposte perse o in ritardo.
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Gli output e i tempi di questo lab vengono da una prova eseguita il 10 novembre 2026 (ultima verifica: novembre 2026), in questa configurazione:
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04) |
| VM della prova | VM 104 web01: Debian 13 dal template 9000, 2 GiB di RAM, disco da 8 GiB su rbd-vm con circa 1,2 GB di dati, guest agent attivo (Lab 40) |
| Destinazioni dei backup | nas-nfs: NFS 4.2 verso il NAS TrueNAS SCALE 25.10 (Lab 12, Lab 13); nas-smb: SMB 3.11 verso lo stesso NAS (Lab 14); cephfs: Ceph 20.2.5 (Lab 17) |
| vzdump | opzioni predefinite tranne quelle indicate in ogni comando: zstd con un thread se non si indica --zstd |
Cosa misura e cosa non misura. Le modalità e la compressione sono state provate una o due volte ciascuna, su una sola VM piccola e quasi scarica. Il ping misura la raggiungibilità in rete, non il disco del guest: non mostra per quanto fs-freeze blocca le scritture del guest, né quanto il backup le rallenta. Le durate dipendono dal NAS, dalla rete e dalla CPU del nodo, che questa prova non separa.
Procedura
Sezione intitolata “Procedura”1. Gli storage di destinazione
Sezione intitolata “1. Gli storage di destinazione”pvesm status --content backupName Type Status Total (KiB) Used (KiB) Available (KiB) %cephfs cephfs active 100483072 7921664 92561408 7.88%local dir active 45995008 1143936 44851072 2.49%nas-nfs nfs active 56481792 0 56481792 0.00%nas-smb cifs active 57458048 977024 56481024 1.70%local è sul disco del nodo: se si perde il nodo, si perdono anche i backup. In produzione i backup vanno fuori dal nodo.
2. Le tre modalità, misurate
Sezione intitolata “2. Le tre modalità, misurate”Facciamo tre backup della VM 104 (web01, disco di 8 GiB su Ceph, guest agent attivo) su nas-nfs, mentre da un’altra macchina un ping ogni 0,2 secondi verso la VM misura le interruzioni:
vzdump 104 --mode snapshot --storage nas-nfs --compress zstd --notes-template '{{guestname}} - prova modalità snapshot'INFO: backup mode: snapshotINFO: creating vzdump archive '/mnt/pve/nas-nfs/dump/vzdump-qemu-104-2026_11_10-04_28_17.vma.zst'INFO: issuing guest-agent 'fs-freeze' commandINFO: starting backup via QMP commandINFO: issuing guest-agent 'fs-thaw' commandINFO: started backup task '461881ef-c1a7-4b5e-9526-4a451d72f0a8'INFO: resuming VM againINFO: archive file size: 355MBINFO: Finished Backup of VM 104 (00:00:17)Lo stesso con --mode suspend e --mode stop:
INFO: backup mode: suspendINFO: suspending guestINFO: resuming VM again after 4 secondsINFO: Finished Backup of VM 104 (00:00:31)INFO: backup mode: stopINFO: stopping virtual guestINFO: starting kvm to execute backup taskINFO: resuming VM again after 13 secondsINFO: Finished Backup of VM 104 (00:00:38)| Modalità | Durata del backup | Pausa nel log di vzdump | Cosa ha visto il ping (uno ogni 0,2 s) |
|---|---|---|---|
| snapshot | 17 s | nessuna: vzdump non mette in pausa la VM (resuming VM again è senza secondi) |
144 risposte su 144 |
| suspend | 29-31 s | resuming VM again after 4 seconds |
nessuna risposta persa, ma alcune in ritardo fino a 3,0 s |
| stop | 38 s | resuming VM again after 13 seconds |
106 risposte su 219: circa 23 secondi senza risposte |
Per ogni modalità, che cosa è stato misurato, come leggerlo e come verificarlo:
- snapshot. Nessuna risposta del ping persa. Il ping però mostra solo che la VM ha continuato a rispondere in rete: non misura il disco del guest durante
fs-freeze, né il rallentamento delle sue scritture mentre il backup è in corso. Li mostrerebbe una sonda di scrittura nel guest, come quella del Lab 18, attiva durante il backup. - suspend. Secondo vzdump la VM è rimasta in pausa 4 secondi; il ping non ha perso risposte, ma alcune sono arrivate con un ritardo fino a 3,0 s. È compatibile con richieste rimaste in attesa durante la pausa e servite alla ripresa, e i due valori concordano entro la loro risoluzione (1 secondo per il log, 0,2 per il ping). Per verificarlo confronta gli orari di
ping -Dcon le righesuspending guesteresuming VM againdel log. - stop. vzdump riporta 13 secondi dall’inizio dello spegnimento alla ripartenza della VM; il ping, circa 23 secondi senza risposte (113 mancanti su 219). La differenza è compatibile con l’avvio del guest dopo la ripartenza, che vzdump non conta: la VM era stata spenta, quindi deve fare di nuovo il boot prima di rispondere. Per verificarlo guarda la sequenza di avvio del guest (
systemd-analyze,journalctl -b) e confronta gli orari del ping con quelli del log.
snapshot è la modalità da usare quasi sempre: in questa prova la VM non ha mai smesso di rispondere e, con il guest agent, fs-freeze migliora la coerenza dei filesystem. suspend resta per compatibilità. stop dà la coerenza massima, perché il guest viene spento in modo pulito prima che la copia inizi, ma costa un riavvio: qui circa 23 secondi senza rete.
3. Compressione
Sezione intitolata “3. Compressione”Lo stesso backup della VM 104 con i quattro algoritmi:
for C in 0 lzo gzip zstd; do vzdump 104 --mode snapshot --storage nas-nfs --compress $C; done| Compressione | File | Dimensione | Durata del backup |
|---|---|---|---|
nessuna (0) |
.vma |
1,15 GB | 33 s |
lzo |
.vma.lzo |
521 MB | 41 s |
gzip |
.vma.gz |
381 MB | 1 min 10 s |
zstd (1 thread, il default della GUI) |
.vma.zst |
353 MB | 25 s (17 s in una seconda prova) |
zstd con --zstd 0 (metà dei core) |
.vma.zst |
354 MB | 14 s |
Il disco da 8 GiB contiene circa 1,2 GB di dati: i blocchi vuoti non finiscono nel backup. In questa prova zstd ha prodotto il file più piccolo e, con --zstd 0, il backup più breve; è anche il default della GUI. Da CLI il default di --compress è 0 (nessuna compressione), quindi va indicato --compress zstd o impostato in /etc/vzdump.conf. --zstd 0 usa metà dei core del nodo per comprimere.
Le durate vengono da una sola esecuzione ciascuna (due per zstd con un thread, 25 e 17 s), su uno storage di rete condiviso con il resto del laboratorio: confronta l’ordine di grandezza, non il secondo. La prova non separa il tempo speso a comprimere da quello speso a scrivere sul NAS. Per vederlo osserva l’uso di CPU del compressore sul nodo durante il backup (top) e ripeti lo stesso backup sullo storage local del nodo, che toglie di mezzo la rete.
4. Container e destinazione CephFS
Sezione intitolata “4. Container e destinazione CephFS”Il container 101 (rootfs su local-zfs) in modalità snapshot su cephfs:
vzdump 101 --mode snapshot --storage cephfs --compress zstdINFO: filesystem type on dumpdir is 'ceph' -using /var/tmp/vzdumptmp430726_101 for temporary filesINFO: including mount point rootfs ('/') in backupINFO: backup mode: snapshotINFO: create storage snapshot 'vzdump'INFO: creating vzdump archive '/mnt/pve/cephfs/dump/vzdump-lxc-101-2026_11_10-04_34_41.tar.zst'INFO: archive file size: 208MBINFO: Finished Backup of VM 101 (00:00:28)Per i container vzdump crea uno snapshot dello storage (vzdump su ZFS) e lo archivia. Su CephFS i file temporanei vanno in /var/tmp del nodo.
5. Escludere dischi; i bind mount
Sezione intitolata “5. Escludere dischi; i bind mount”Aggiungiamo alla VM 100 un secondo disco con l’opzione backup=0 (in GUI: Hardware → Edit → Advanced → Backup senza spunta) e facciamo il backup:
qm set 100 --scsi1 rbd-vm:1,backup=0vzdump 100 --mode snapshot --storage cephfs --compress zstdINFO: include disk 'scsi0' 'rbd-vm:vm-100-disk-0' 16GINFO: exclude disk 'scsi1' 'rbd-vm:vm-100-disk-1' (backup=no)INFO: archive file size: 5.53GBINFO: Finished Backup of VM 100 (00:02:25)Si escludono così, per esempio, i dischi di cache o di dati salvati in altro modo. Attenzione: al restore quel disco non c’è. Finita la prova, togli e cancella il disco aggiunto:
qm disk unlink 100 --idlist scsi1 --forceNei container, i bind mount (cartelle del nodo montate nel CT) sono sempre esclusi; i mount point su storage sono esclusi per default e inclusi solo con backup=1, come il mp0 del CT 141:
vzdump 141 --mode snapshot --storage cephfs --compress zstdINFO: including mount point mp0 ('/data') in backupINFO: excluding bind mount point mp1 ('/condivisa') from backup (not a volume)INFO: excluding bind mount point mp2 ('/progetti') from backup (not a volume)I dati dei bind mount vanno salvati a parte, sul nodo o sullo storage che li ospita.
6. Fleecing verso uno storage lento
Sezione intitolata “6. Fleecing verso uno storage lento”Salviamo la VM 104 sulla condivisione SMB, con il fleecing su Ceph:
vzdump 104 --mode snapshot --storage nas-smb --compress zstd --fleecing enabled=1,storage=rbd-vmINFO: starting new backup job: vzdump 104 --storage nas-smb --mode snapshot --fleecing '1,storage=rbd-vm' --compress zstdINFO: drive-scsi0: attaching fleecing image rbd-vm:vm-104-fleece-0 to QEMUINFO: archive file size: 354MBINFO: removing (old) fleecing image 'rbd-vm:vm-104-fleece-0'INFO: Finished Backup of VM 104 (00:00:19)Per ogni disco vzdump crea un’immagine vm-<vmid>-fleece-N sullo storage indicato e la cancella alla fine. Lo storage del fleecing deve avere spazio per i blocchi riscritti durante il backup. La documentazione consiglia uno storage locale veloce, thin e con discard, e tra gli esempi cita LVM-thin, RBD e ZFS con sparse; qui si usa Ceph RBD (rbd-vm). Questa prova mostra che l’immagine viene creata e rimossa; non misura l’effetto del fleecing sulle scritture del guest, che è il suo scopo. Per misurarlo fai girare nel guest una sonda di scrittura (come nel Lab 18) durante un backup verso nas-smb, con e senza fleecing.
7. Backup protetti e retention
Sezione intitolata “7. Backup protetti e retention”Dopo le prove, la VM 104 ha almeno otto backup su nas-nfs. Proteggiamo il primo (in GUI: Change Protection):
pvesh set /nodes/desopve01/storage/nas-nfs/content/nas-nfs:backup/vzdump-qemu-104-2026_11_10-04_28_17.vma.zst --protected 1Nella vista dello storage il backup ora ha lo scudo della protezione.
Simuliamo una retention keep-last=2:
pvesm prune-backups nas-nfs --vmid 104 --keep-last 2 --dry-run 1NOTE: this is only a preview and might not be what a subsequentprune call does if backups are removed/added in the meantime.
Backup Backup-ID Prune-Markvzdump-qemu-104-2026_11_10-04_28_17.vma.zst qemu/104 protectedvzdump-qemu-104-2026_11_10-04_28_48.vma.zst qemu/104 removevzdump-qemu-104-2026_11_10-04_29_36.vma.zst qemu/104 removevzdump-qemu-104-2026_11_10-04_30_50.vma.zst qemu/104 removevzdump-qemu-104-2026_11_10-04_31_25.vma qemu/104 removevzdump-qemu-104-2026_11_10-04_31_59.vma.lzo qemu/104 removevzdump-qemu-104-2026_11_10-04_32_42.vma.gz qemu/104 removevzdump-qemu-104-2026_11_10-04_33_54.vma.zst qemu/104 removevzdump-qemu-104-2026_11_10-04_34_21.vma.zst qemu/104 keepvzdump-qemu-104-2026_11_10-04_39_45.vma.zst qemu/104 keepPoi una retention reale keep-last=3:
pvesm prune-backups nas-nfs --vmid 104 --keep-last 3pvesm list nas-nfs --vmid 104vzdump-qemu-104-2026_11_10-04_28_17.vma.zstvzdump-qemu-104-2026_11_10-04_33_54.vma.zstvzdump-qemu-104-2026_11_10-04_34_21.vma.zstvzdump-qemu-104-2026_11_10-04_39_45.vma.zstRestano gli ultimi tre più quello protetto. Dalla GUI si fa lo stesso con Prune group, che mostra per ogni backup se e perché viene tenuto:
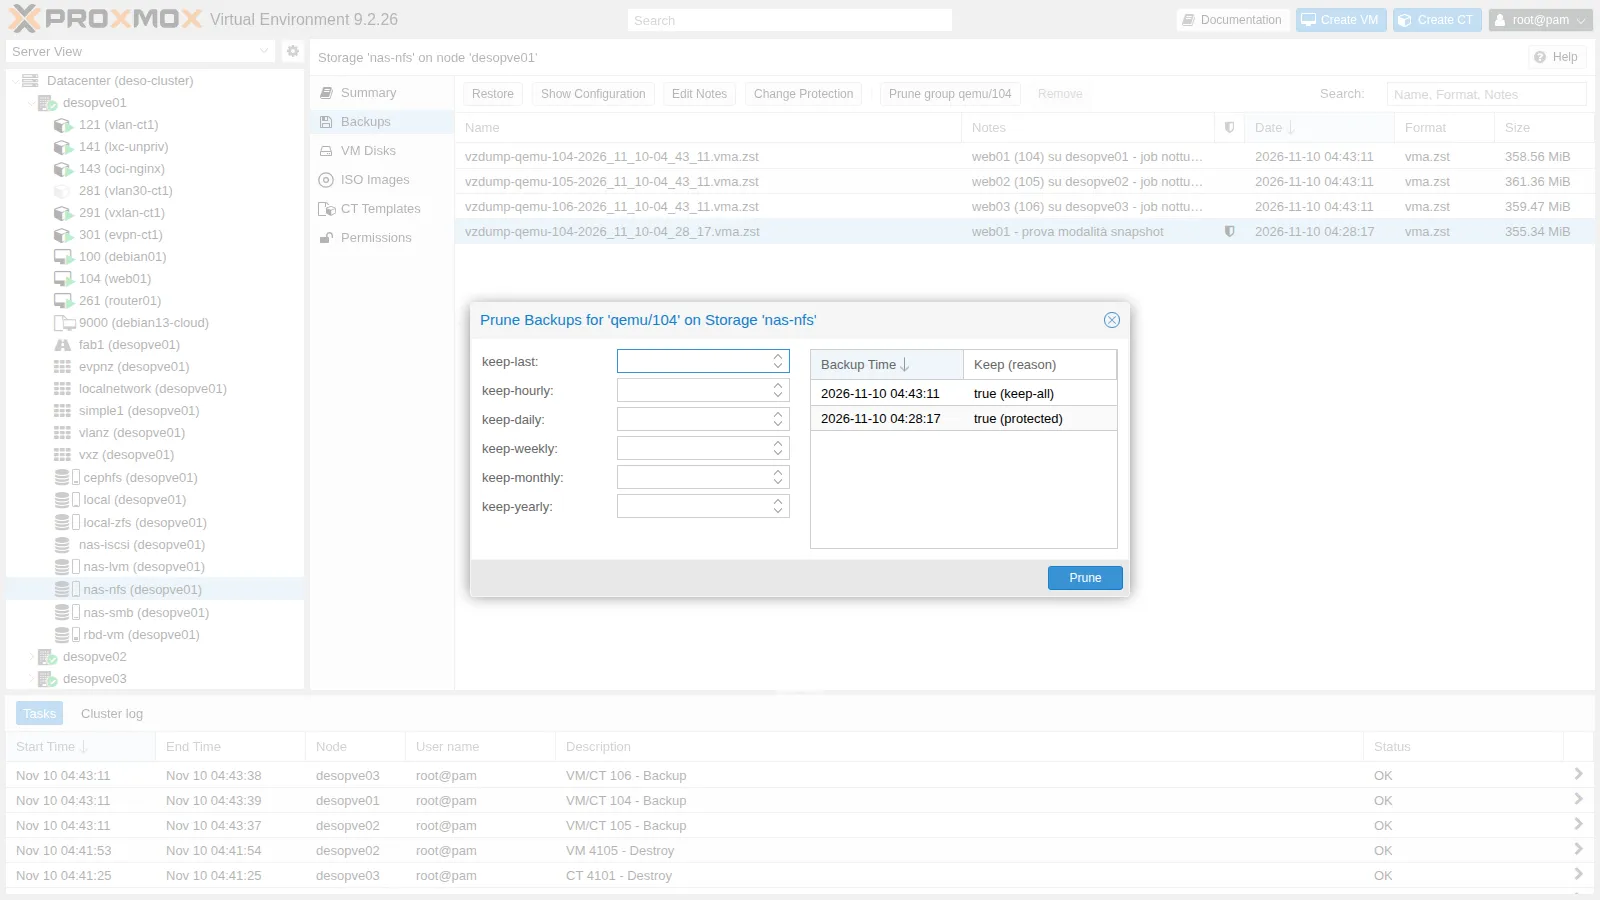
8. Un job pianificato
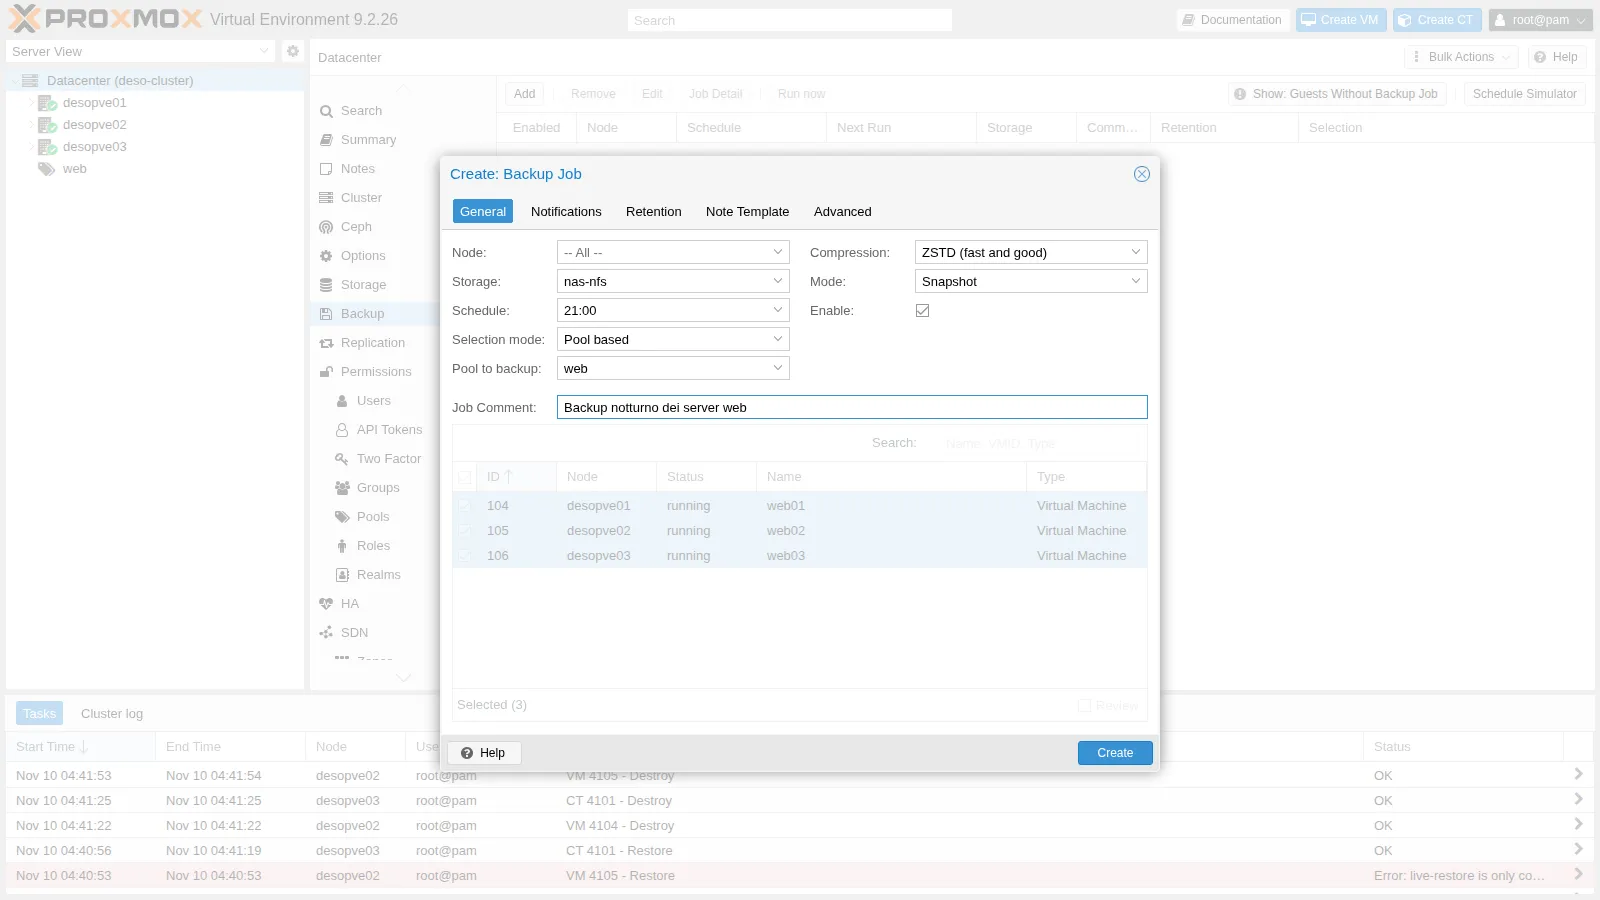
Sezione intitolata “8. Un job pianificato”In Datacenter → Backup → Add creiamo il job notturno per il pool web. Nella scheda General: storage nas-nfs, Schedule 21:00, Selection mode Pool based con il pool web, modalità Snapshot, compressione ZSTD:
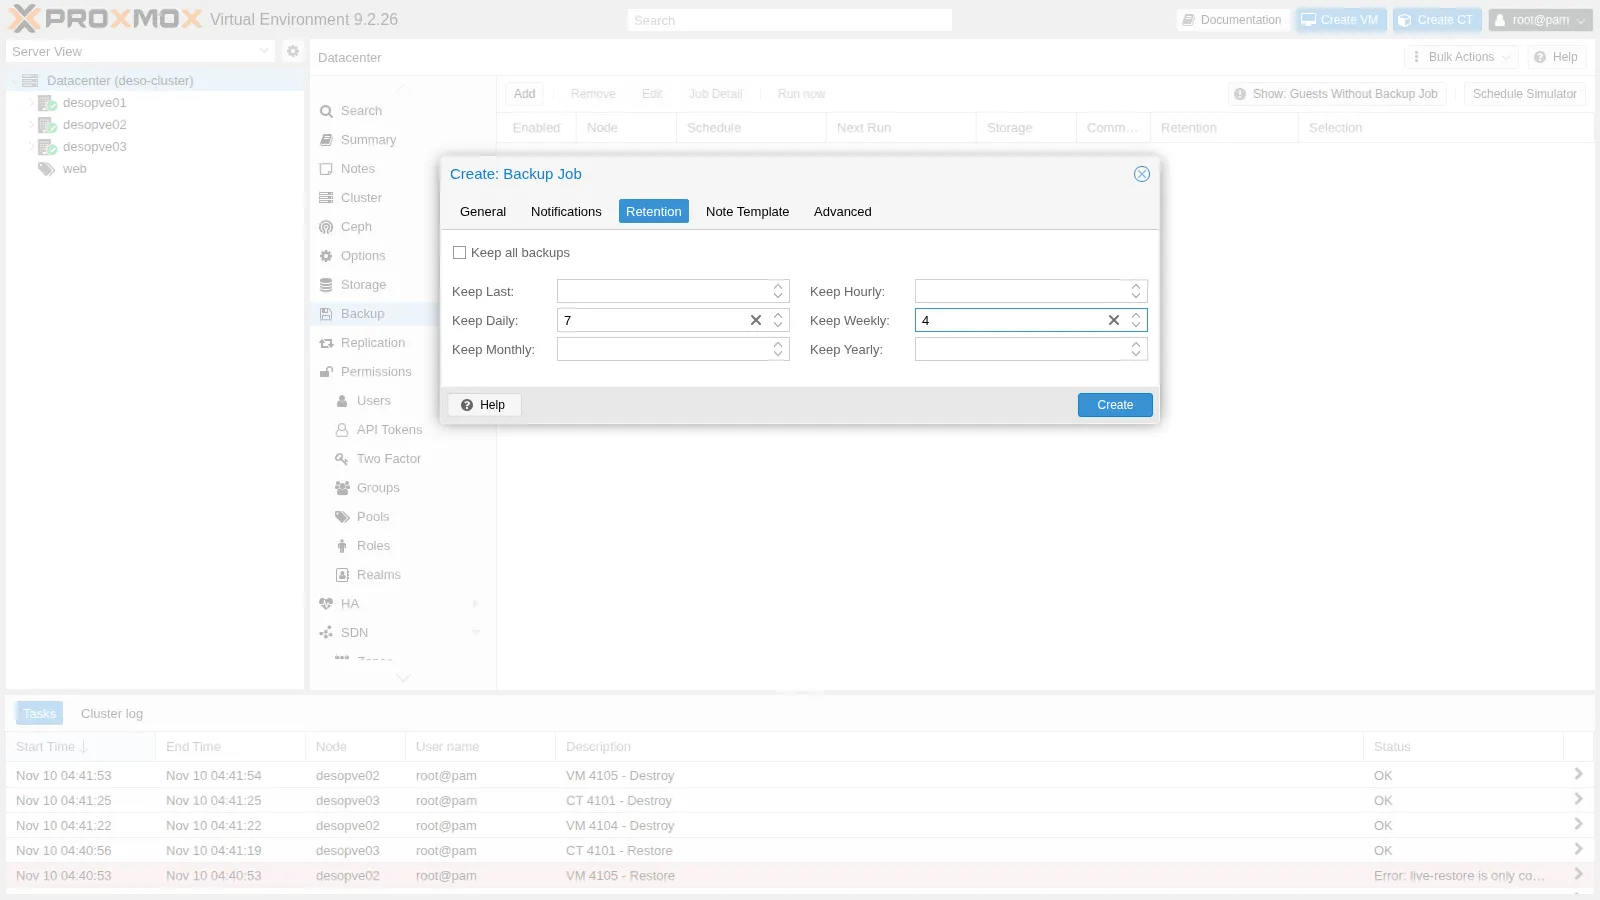
Retention: keep-daily=7, keep-weekly=4, cioè un backup al giorno per una settimana e uno a settimana per un mese.
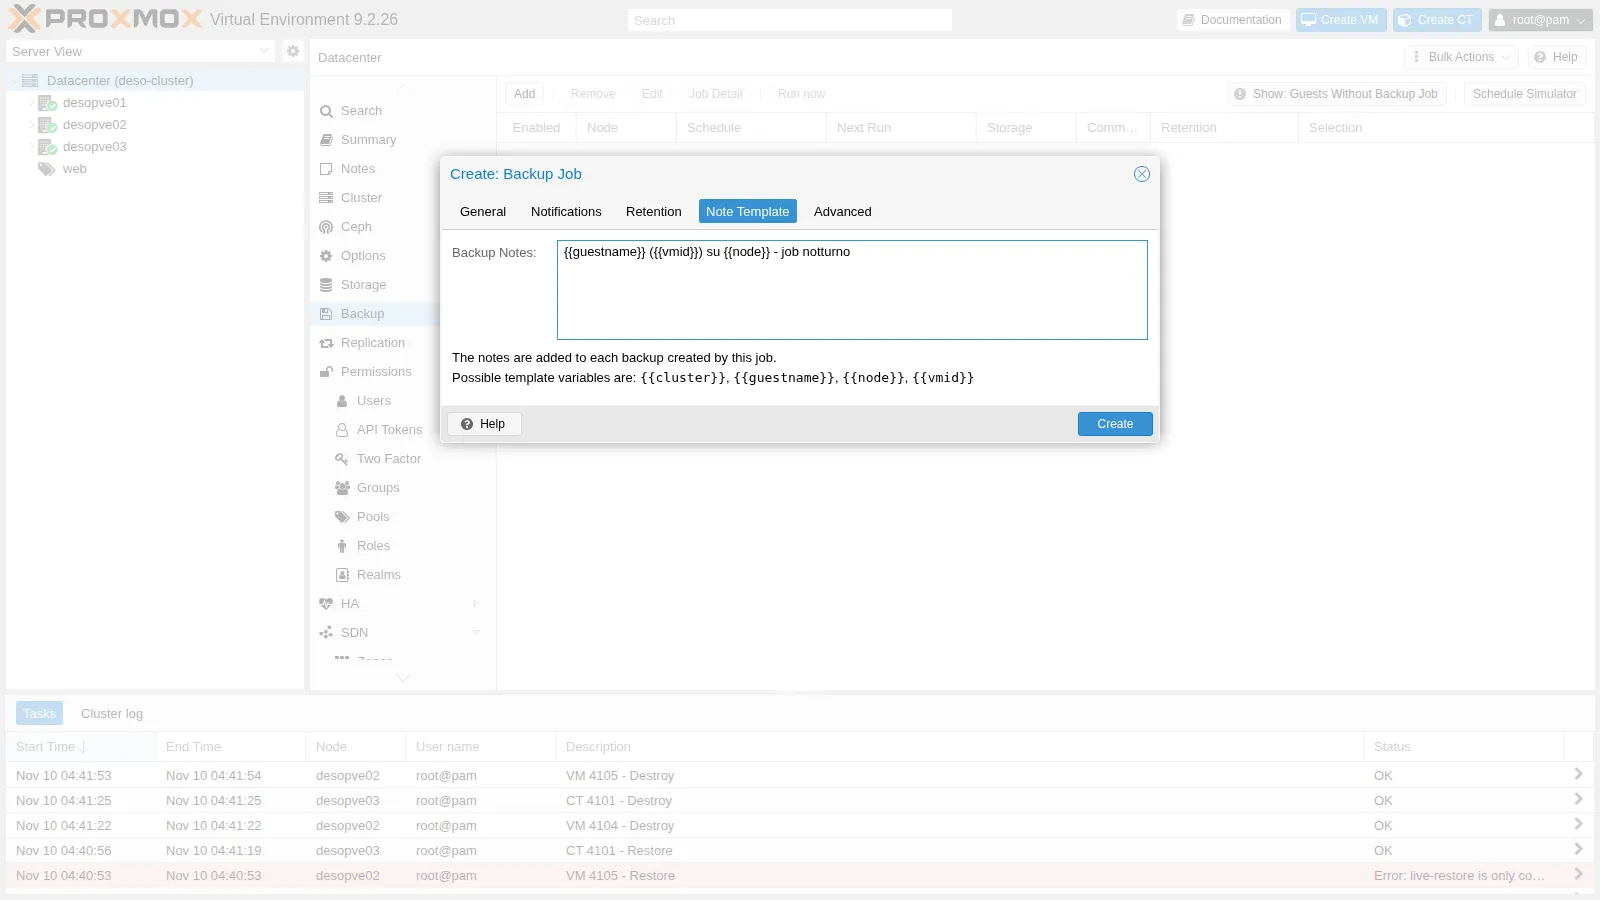
Note Template: le note di ogni backup si compongono con le variabili {{guestname}}, {{vmid}}, {{node}}, {{cluster}}:
Advanced: fleecing attivo su rbd-vm. Il pannello mostra anche i default che si possono cambiare (thread di zstd, banda, I/O worker):
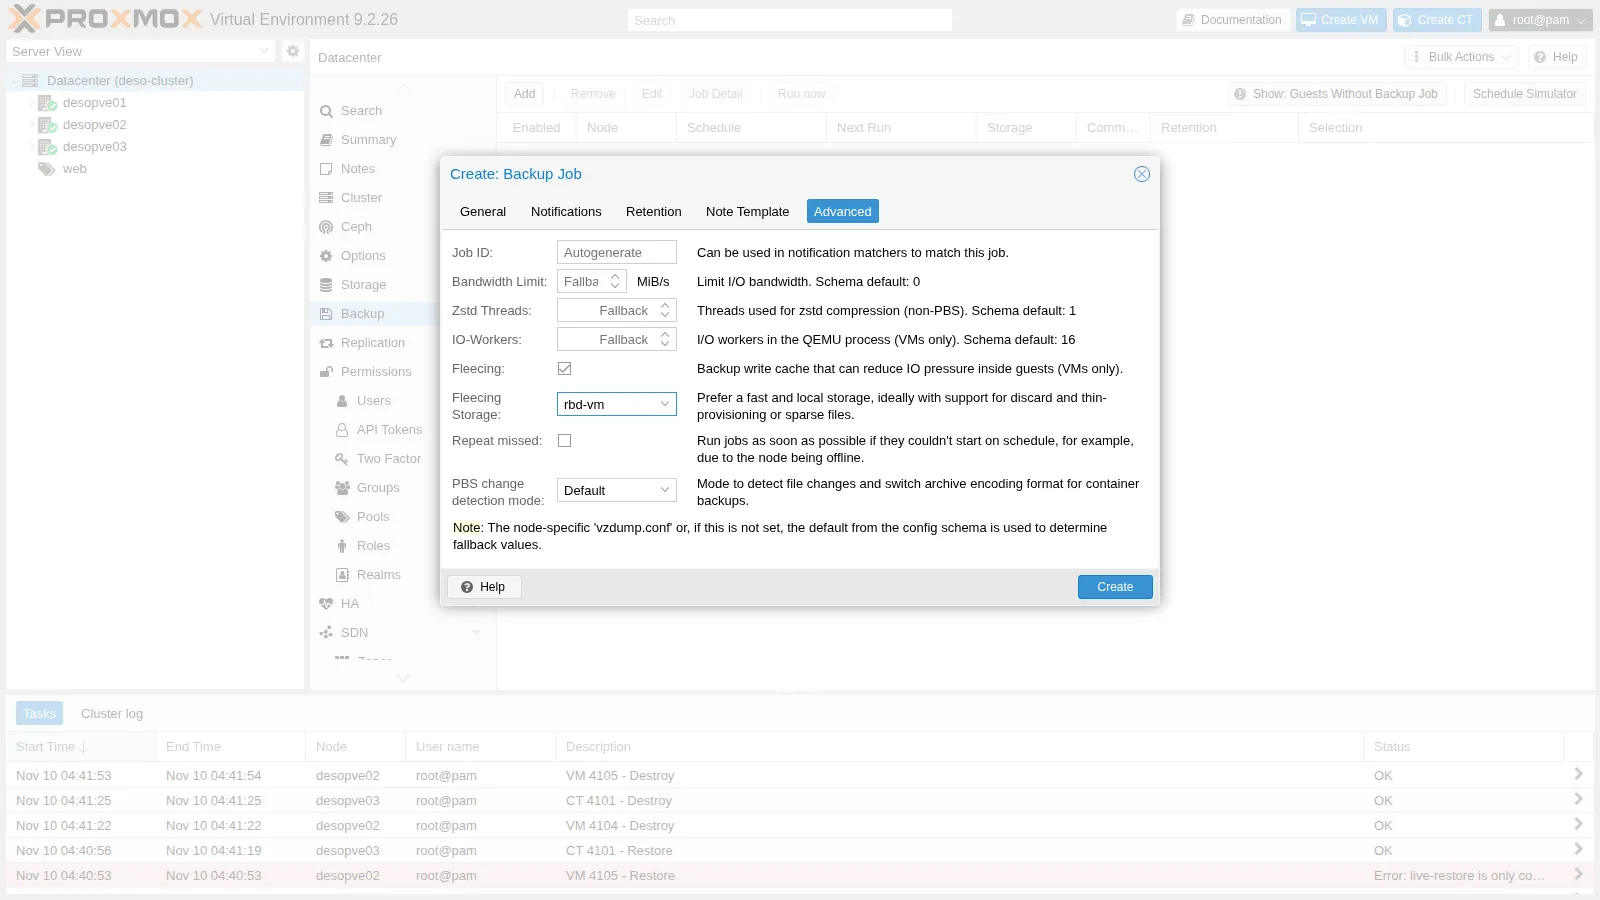
Il job viene salvato in /etc/pve/jobs.cfg:
vzdump: backup-c5fdd165-9aa0 comment Backup notturno dei server web schedule 21:00 compress zstd enabled 1 fleecing 1,storage=rbd-vm mode snapshot notes-template {{guestname}} ({{vmid}}) su {{node}} - job notturno notification-mode notification-system pool web prune-backups keep-daily=7,keep-weekly=4 repeat-missed 0 storage nas-nfs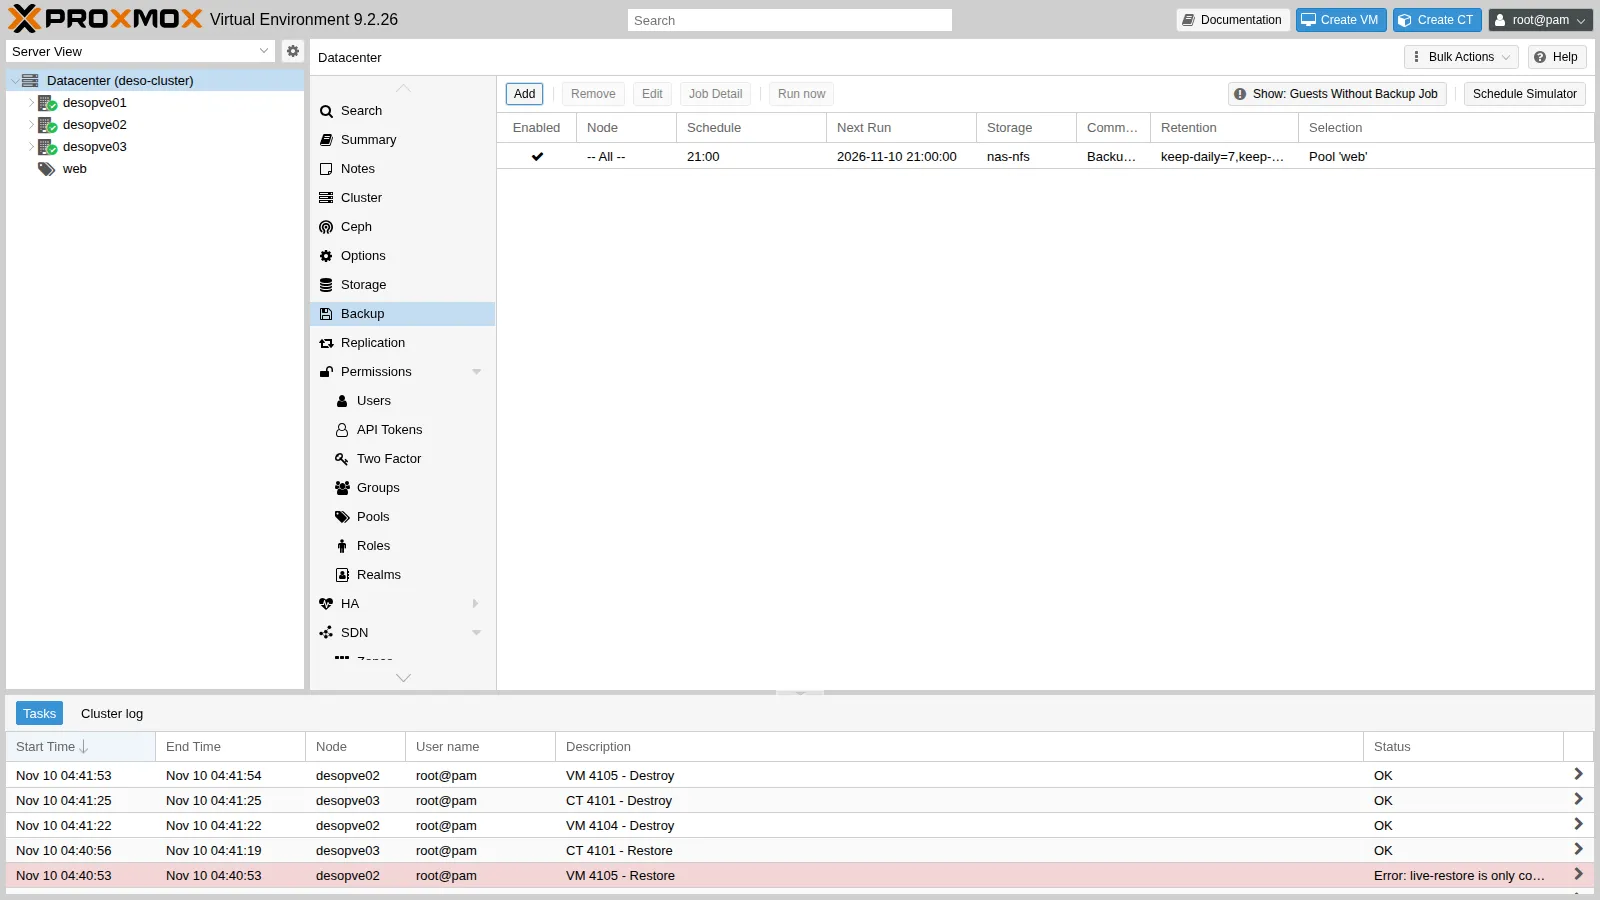
Con Run now lo eseguiamo subito: parte un task vzdump su ogni nodo che ospita una VM del pool. Nel log della VM 104 si vede anche la retention:
INFO: drive-scsi0: attaching fleecing image rbd-vm:vm-104-fleece-0 to QEMUINFO: prune older backups with retention: keep-daily=7, keep-weekly=4INFO: removing backup 'nas-nfs:backup/vzdump-qemu-104-2026_11_10-04_33_54.vma.zst'INFO: removing backup 'nas-nfs:backup/vzdump-qemu-104-2026_11_10-04_34_21.vma.zst'INFO: removing backup 'nas-nfs:backup/vzdump-qemu-104-2026_11_10-04_39_45.vma.zst'INFO: pruned 3 backup(s) not covered by keep-retention policyINFO: removing (old) fleecing image 'rbd-vm:vm-104-fleece-0'INFO: Finished Backup of VM 104 (00:00:28)keep-daily=7 tiene un backup per giorno, il più recente: i tre backup di oggi fatti prima sono stati cancellati. Quello protetto è rimasto. Nella vista dello storage si vedono le note generate dal modello e lo scudo dei backup protetti:
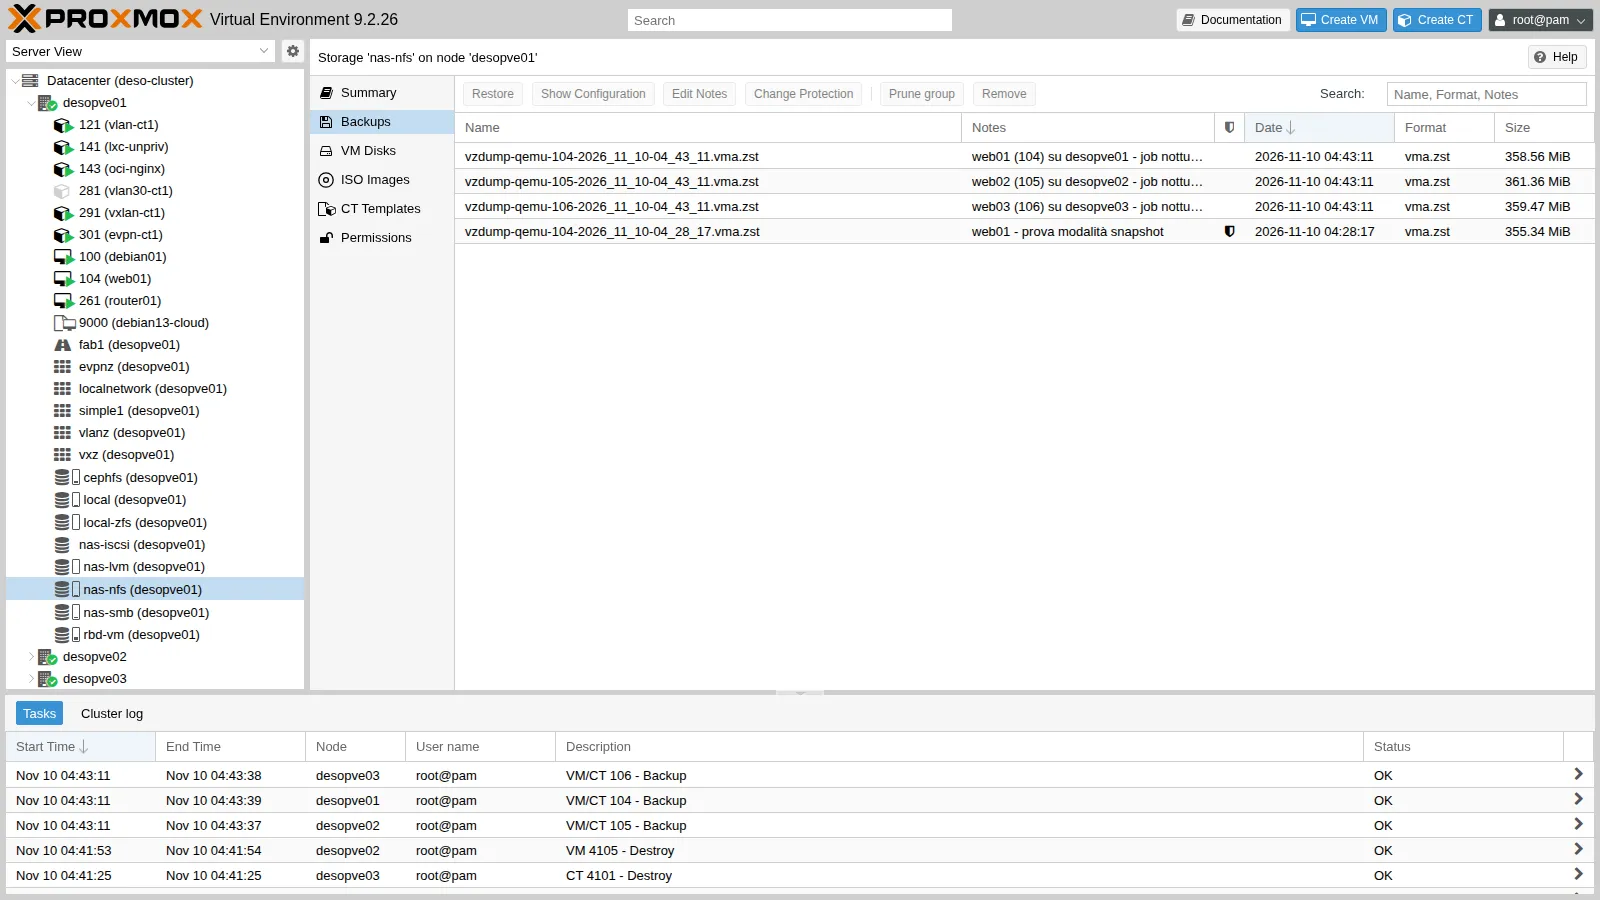
9. Restore su un altro nodo e un altro storage
Sezione intitolata “9. Restore su un altro nodo e un altro storage”Ripristiniamo l’ultimo backup della VM 104 come nuova VM 4104 su desopve02, sullo storage locale local-zfs. Con --unique vengono generati nuovi indirizzi MAC, per non creare un doppione in rete:
V=$(pvesm list nas-nfs --vmid 104 | awk 'NR>1 {v=$1} END {print v}') # il backup più recentetime qmrestore $V 4104 --storage local-zfs --unique 1qm config 4104 | grep -E '^(name|scsi0|net0|agent)'new volume ID is 'local-zfs:vm-4104-cloudinit'new volume ID is 'local-zfs:vm-4104-disk-0'progress 100% (read 8589934592 bytes, duration 8 sec)total bytes read 8589934592, sparse bytes 7360720896 (85.7%)space reduction due to 4K zero blocks 4.29%
real 0m18.836sagent: enabled=1name: web01net0: virtio=BC:24:11:22:EA:5E,bridge=vmbr0scsi0: local-zfs:vm-4104-disk-0,discard=on,iothread=1,size=8G,ssd=1L’originale aveva il disco su Ceph; il restore lo ha messo su ZFS locale. La copia non va avviata finché ha lo stesso IP dell’originale.
Il live-restore (la VM parte subito mentre i dati arrivano in background) non è disponibile con i file vzdump:
qmrestore $V 4105 --storage local-zfs --live-restore 1error before or during data restore, some or all disks were not completely restored. VM 4105 state is NOT cleaned up.live-restore is only compatible with backup images from a Proxmox Backup ServerLo vedremo nel Lab 47 con Proxmox Backup Server.
Il restore del container 101 come CT 4101 su desopve03:
time pct restore 4101 cephfs:backup/vzdump-lxc-101-2026_11_10-04_34_41.tar.zst --storage local-zfs --unique 1pct config 4101 | grep -E '^(hostname|rootfs|net0|unprivileged)'extracting archive '/mnt/pve/cephfs/dump/vzdump-lxc-101-2026_11_10-04_34_41.tar.zst'Total bytes read: 715776000 (683MiB, 31MiB/s)merging backed-up and given configuration..
real 0m24.179shostname: debian-ct01net0: name=eth0,bridge=vmbr0,firewall=1,gw=172.27.199.1,hwaddr=BC:24:11:1D:C4:48,ip=172.27.199.101/24,type=vethrootfs: local-zfs:subvol-4101-disk-0,size=8Gunprivileged: 1Il container ripristinato resta non privilegiato come l’originale. In GUI il restore si fa selezionando il backup nello storage e premendo Restore, oppure dalla scheda Backup del guest.
Puliamo le copie di prova:
qm destroy 4104 --purge 1qm destroy 4105 --purge 1 # la VM lasciata dal live-restore fallitopct destroy 4101 --purge 110. Hook script
Sezione intitolata “10. Hook script”Per eseguire azioni prima e dopo i backup (fermare un’applicazione, copiare il file altrove, mandare un messaggio) vzdump chiama uno script a ogni fase (job-start, backup-start, pre-stop, post-restart, backup-end, job-end…). Un esempio commentato è fornito con Proxmox VE:
ls /usr/share/doc/pve-manager/examples/ | grep -i hookvzdump-hook-script.plLo script si attiva con l’opzione script del job o in /etc/vzdump.conf.
Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se ogni backup termina con Finished Backup, se il job pianificato compare nell’elenco e applica la sua retention, e se le copie ripristinate esistono sul nuovo nodo e sul nuovo storage, con nuovi indirizzi MAC.
| Prova | Criterio di successo | Risultato nel lab |
|---|---|---|
| Backup snapshot con guest agent | fs-freeze/fs-thaw nel log, nessuna risposta del ping persa |
17 s; 144 risposte su 144 |
| Backup suspend | VM messa in pausa e ripresa da vzdump | 4 s di pausa secondo il log; nessuna risposta persa, alcune in ritardo fino a 3,0 s |
| Backup stop | VM spenta e riaccesa da sola | ripartita dopo 13 s secondo il log; circa 23 s senza risposte al ping |
| Compressione | un file valido con ogni algoritmo | zstd il più piccolo (353-354 MB); 14 s con --zstd 0 |
Disco con backup=0 |
exclude disk 'scsi1' nel log |
come atteso |
| Bind mount di un CT | excluding bind mount point … (not a volume) |
come atteso |
| Fleecing | immagine vm-104-fleece-0 creata e rimossa |
come atteso |
| Backup protetto | marcato protected e mai cancellato dal prune |
conservato sia da keep-last sia dalla retention del job |
| Job pianificato | backup del pool web su tre nodi, note dal modello, retention applicata |
come atteso |
| Restore di VM e CT su altro nodo e storage | VM 4104 e CT 4101 creati, nuovi MAC | VM ripristinata in 18,8 s e CT in 24,2 s (time) |
| Live-restore da file vzdump | rifiutato | live-restore is only compatible with backup images from a Proxmox Backup Server |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Job pianificato
backup-c5fdd165-9aa0: poolweb(VM 104-106) ogni giorno alle 21:00 sunas-nfs, snapshot, zstd, fleecing surbd-vm, retentionkeep-daily=7,keep-weekly=4, note{{guestname}} ({{vmid}}) su {{node}} - job notturno. - Backup presenti:
nas-nfs: VM 104, 105, 106 del job; VM 104 della prova snapshot, protetto;cephfs: CT 101, CT 141, VM 100;nas-smb: VM 104 (prova di fleecing) e il backup del CT 101 del Lab 14.
- VM 100 di nuovo con il solo disco
scsi0; VM 4104 e 4105 e CT 4101 eliminati.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Quale modalità per quale guest. snapshot quasi sempre: in questa prova il ping non ha mai perso una risposta, e il guest agent congela i filesystem per lo snapshot. stop solo quando vuoi il guest spento in modo pulito prima della copia e puoi accettare un riavvio, qui circa 23 secondi senza rete per una piccola VM Debian. Per un container stop significa restare spento per tutto il backup. suspend solo per compatibilità.
- Dove tenere i backup. Fuori dal nodo:
localsi perde con il nodo. vzdump salva un file completo per guest; per backup incrementali e deduplica serve PBS (Lab 47). - Quale compressione. zstd, da indicare esplicitamente in CLI, dove il default è nessuna compressione; con
--zstd 0usa metà dei core, se il nodo ha CPU libera durante il backup. - Che cosa resta fuori dal backup. I dischi con
backup=0, i mount point dei container senzabackup=1e sempre i bind mount: vanno salvati in altro modo. - Quando usare il fleecing. Quando la destinazione del backup è lenta, su uno storage veloce e con spazio per i blocchi riscritti; misura il suo effetto sul guest prima di contarci.
- Come impostare la retention.
keep-dailyconserva un backup al giorno, il più recente; simula prima con--dry-rune proteggi i backup che devono sopravvivere. Un job per pool salva anche le VM aggiunte al pool in seguito. - Come ripristinare. Il restore può cambiare nodo e storage;
--uniqueevita MAC duplicati; il live-restore richiede PBS.