

Lab 10 – ZFS: pool, ridondanza, compressione, snapshot e guasti
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti: Lab 09. Su
desopve04i quattro dischi da 20 GB (sdb,sdc,sdd,sde) sono vuoti. - Nodi:
desopve04come banco di prova edesopve01(installato su ZFS, lab 03) per l’invio remoto degli snapshot. - Template:
debian-13-standard_13.6-1_amd64.tar.zstnello storagelocaldidesopve04(lab 09). - Indirizzi:
172.27.199.141per il container di prova. - Hardware per i test di guasto: i dischi di
desopve04sono in vani hot-swap e si estraggono a nodo acceso. Tieni pronto un quinto disco da 20 GB, nuovo, da inserire nel Test 2 come disco di riserva (vedi l’hardware del laboratorio). - Credenziali:
root/<password-lab>→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Un pool
tanksudesopve04, creato prima come mirror dall’interfaccia web e poi ricostruito da riga di comando come RAIDZ1 su tre dischi con i nomi stabiliby-path, e registrato come storagetank:zpool statuslo mostra ONLINE epvesm statusmostra lo storage attivo. - Un disco del mirror corrotto di proposito e riparato da uno scrub, con l’impronta del file di prova invariata e il pool di nuovo integro.
- Spazio grezzo, spazio utilizzabile e rapporto di compressione del RAIDZ1 letti con
zpool listezfs list, per tre dataset con compressione diversa. - Un dataset ripristinato con un rollback e copiato con
zfs send/receive, per intero e in modo incrementale, nello stesso pool e versodesopve01, con i dati ricevuti verificati. - L’ARC di
desopve04limitato a 2 GiB, a caldo e in/etc/modprobe.d/zfs.conf. - Un disco estratto dal RAIDZ1 in funzione: il pool, DEGRADED, continua a servire il container e torna ONLINE dopo
zpool replace; poi al pool si aggiunge un disco di riserva.
Come funziona
Sezione intitolata “Come funziona”Pool, vdev e dataset
Sezione intitolata “Pool, vdev e dataset”ZFS fa insieme il lavoro di un RAID, di un volume manager e di un file system:
 pool (zpool)           tank                         │ vdev               raidz1-0  (o mirror-0, o un disco singolo)                    ┌────┼────┐ dischi           sdb   sdc   sdd
dataset e zvol tank/dati file system, montato in /tank/dati tank/vm-990-disk-0 zvol: un block device, /dev/zvol/tank/vm-990-disk-0- Un pool è fatto di uno o più vdev. La ridondanza sta dentro ogni vdev: se si perde un vdev intero, si perde il pool.
- Un vdev può essere un disco singolo, un mirror (2 o più copie identiche), un RAIDZ1/2/3 (parità distribuita, sopporta la perdita di 1, 2 o 3 dischi) o un dRAID. Ci sono poi vdev speciali (
log,cache,special) e i dischi di riserva (spare). - Nel pool si creano dataset (file system) e zvol (block device). Le proprietà, come la compressione, si ereditano dal genitore e si possono cambiare per ciascuno.
In Proxmox VE uno storage zfspool mette i dischi delle VM in zvol e quelli dei container in dataset (subvol), con una quota pari alla dimensione del disco.
Perché ZFS non perde i dati in silenzio
Sezione intitolata “Perché ZFS non perde i dati in silenzio”- Copy-on-write: ZFS non sovrascrive mai un blocco, ne scrive uno nuovo e poi aggiorna i puntatori. Una scrittura interrotta non lascia il file system a metà, e gli snapshot sono istantanei e, appena creati, non occupano spazio.
- Checksum di ogni blocco, conservati nel blocco padre: ZFS si accorge se un disco restituisce dati sbagliati, anche senza errori di I/O.
- Autoriparazione: se il vdev è ridondante, ZFS legge la copia buona e riscrive quella rovinata. Lo scrub rilegge tutto il pool per scovare e correggere gli errori latenti.
Mirror o RAIDZ?
Sezione intitolata “Mirror o RAIDZ?”| Mirror (2 dischi) | RAIDZ1 (3 dischi) | RAIDZ2 (4+ dischi) | |
|---|---|---|---|
| Spazio utile | 50% | circa 66% | circa 50% con 4 dischi, di più con molti dischi |
| Dischi persi senza danni | 1 per mirror | 1 | 2 |
| Prestazioni casuali (IOPS) | in scrittura circa quelle di un disco per mirror, in lettura di più, secondo i dischi del mirror; in entrambi i casi crescono con il numero di mirror | quelle di circa un disco per vdev | quelle di circa un disco per vdev |
| Ricostruzione (resilver) | copia da un solo disco | ricalcolo dalla parità su tutti i dischi | ricalcolo dalla parità |
La documentazione di Proxmox VE ricorda che per le VM in esecuzione la misura che conta di più è in genere quella degli IOPS, e che un vdev RAIDZ offre all’incirca gli IOPS di un disco singolo. Per i dischi delle VM questo porta a scegliere mirror o mirror in striping (RAID10); RAIDZ conviene per backup e archivi, dove conta di più lo spazio. Su RAIDZ, inoltre, i blocchi piccoli occupano più spazio di quanto dica il rapporto nominale di parità, perché ognuno richiede almeno un settore di parità: il passo 5 ne mostra l’effetto.
L’ARC è la cache di lettura di ZFS in RAM. Più è grande, più letture può servire senza toccare i dischi, ma la RAM che occupa non è disponibile per le VM finché ZFS non la restituisce. Dalla versione 8.1 l’installazione di Proxmox VE limita l’ARC al 10% della RAM, con un massimo di 16 GiB, scrivendo il limite in /etc/modprobe.d/zfs.conf.
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Gli output di questo lab vengono da una prova del 9 novembre 2026, la data che compare nei log, nella configurazione descritta qui sotto. I valori di spazio, compressione e durata dipendono da questa configurazione: con altre versioni, altri dischi o altri dati cambiano.
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04) |
| ZFS | la versione distribuita per quel kernel. Durante la prova non è stata annotata su desopve04: la mostra zfs version. Come riferimento, l’Appendice A riporta zfsutils-linux 2.4.4-pve1 su un nodo di prova con lo stesso kernel |
| Nodo di prova | desopve04: 4 core, 16 GB di RAM (15,6 GiB secondo arc_summary), sistema su ext4/LVM in un disco da 50 GB, quattro dischi da 20 GB in vani hot-swap sullo stesso controller (pci-0000:02:00.0), più un quinto disco da 20 GB per il Test 2 (Lab 01) |
tank |
prima un mirror su due dischi (compression=on, cioè LZ4, ashift=12), poi un RAIDZ1 su tre dischi con ashift=12, compression=lz4 e atime=off; storage zfspool con sparse 1 |
ARC di desopve04 |
massimo di 1,6 GiB impostato dall’installazione, portato a 2 GiB nel passo 9 |
| Nodo remoto | desopve01, pool di sistema rpool: un mirror ZFS su due dischi da 50 GB (Lab 03) |
| Dati di prova | 1500 MiB di dati casuali per lo scrub; una copia di /usr/share/doc e /usr/lib/python3 del nodo (112 MiB di dati logici) per compressione, snapshot e send/receive |
I modelli di dischi e controller sono oscurati, come indicato nelle convenzioni del manuale.
Cosa mostrano le prove e cosa no. Mostrano come si comporta ZFS su un pool piccolo e quasi vuoto, in un solo nodo: rilevamento e riparazione dei danni, conteggio dello spazio, ripristino dopo il guasto di un disco. Le durate (uno scrub di 5 secondi, un resilver di 12) e i valori di spazio valgono per queste quantità di dati, da un centinaio di megabyte a 1,5 GB, e per questa disposizione dei dischi. Non sono misure di prestazioni: non dicono quanto dura uno scrub o un resilver su dischi grandi e pieni o sotto carico, né quanto costa la compressione in CPU.
Procedura
Sezione intitolata “Procedura”1. Il pool di sistema di desopve01
Sezione intitolata “1. Il pool di sistema di desopve01”L’installazione del lab 03 ha creato rpool, un mirror sulle partizioni 3 dei due dischi da 50 GB:
zpool status rpool pool: rpool state: ONLINEconfig:
NAME STATE READ WRITE CKSUM rpool ONLINE 0 0 0 mirror-0 ONLINE 0 0 0 scsi-<seriale-disco-sda>-part3 ONLINE 0 0 0 scsi-<seriale-disco-sdb>-part3 ONLINE 0 0 0
errors: No known data errorszpool listNAME SIZE ALLOC FREE CKPOINT EXPANDSZ FRAG CAP DEDUP HEALTH ALTROOTrpool 49G 5.44G 43.6G - - 3% 11% 1.00x ONLINE -L’installer usa i nomi in /dev/disk/by-id, che contengono modello e numero di serie del disco e non cambiano se cambia l’ordine sda, sdb… Nel manuale i seriali sono sostituiti da segnaposto, perché dipendono dall’hardware.
2. Creare un mirror dall’interfaccia web
Sezione intitolata “2. Creare un mirror dall’interfaccia web”-
Su
desopve04apri Disks → ZFS → Create: ZFS. -
Name
tank, RAID LevelMirror, Compressionon(cioè LZ4), ashift12(settori da 4 KiB), Add Storage attivo. Spunta/dev/sdbe/dev/sdc.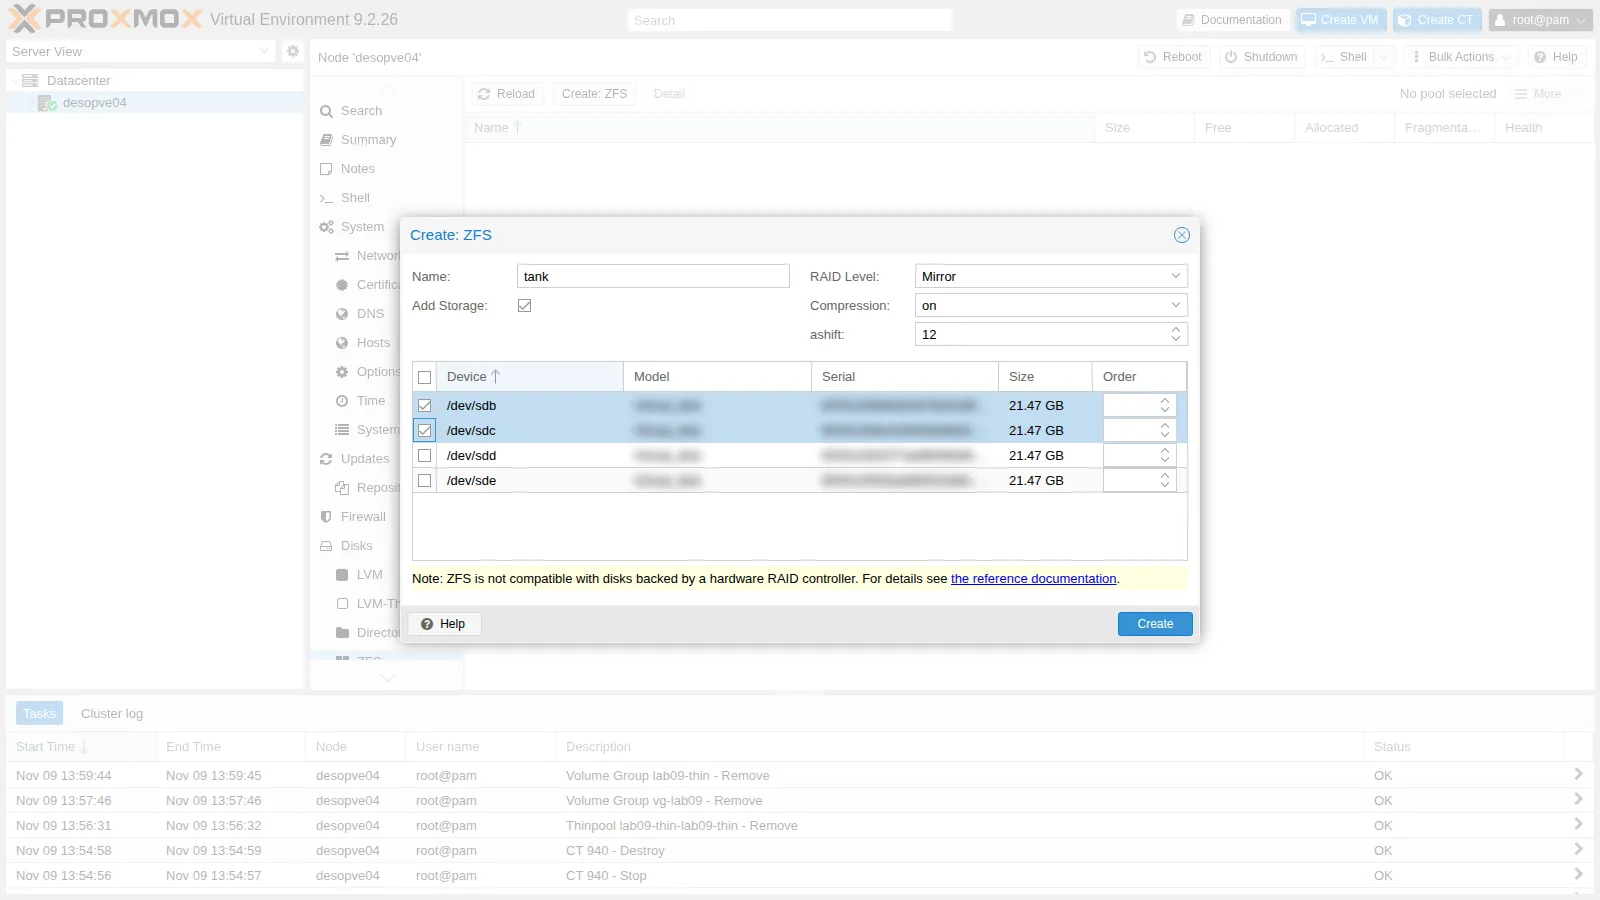
-
Premi Create. Il pool compare nell’elenco; Detail mostra lo stato dei dischi, come
zpool status.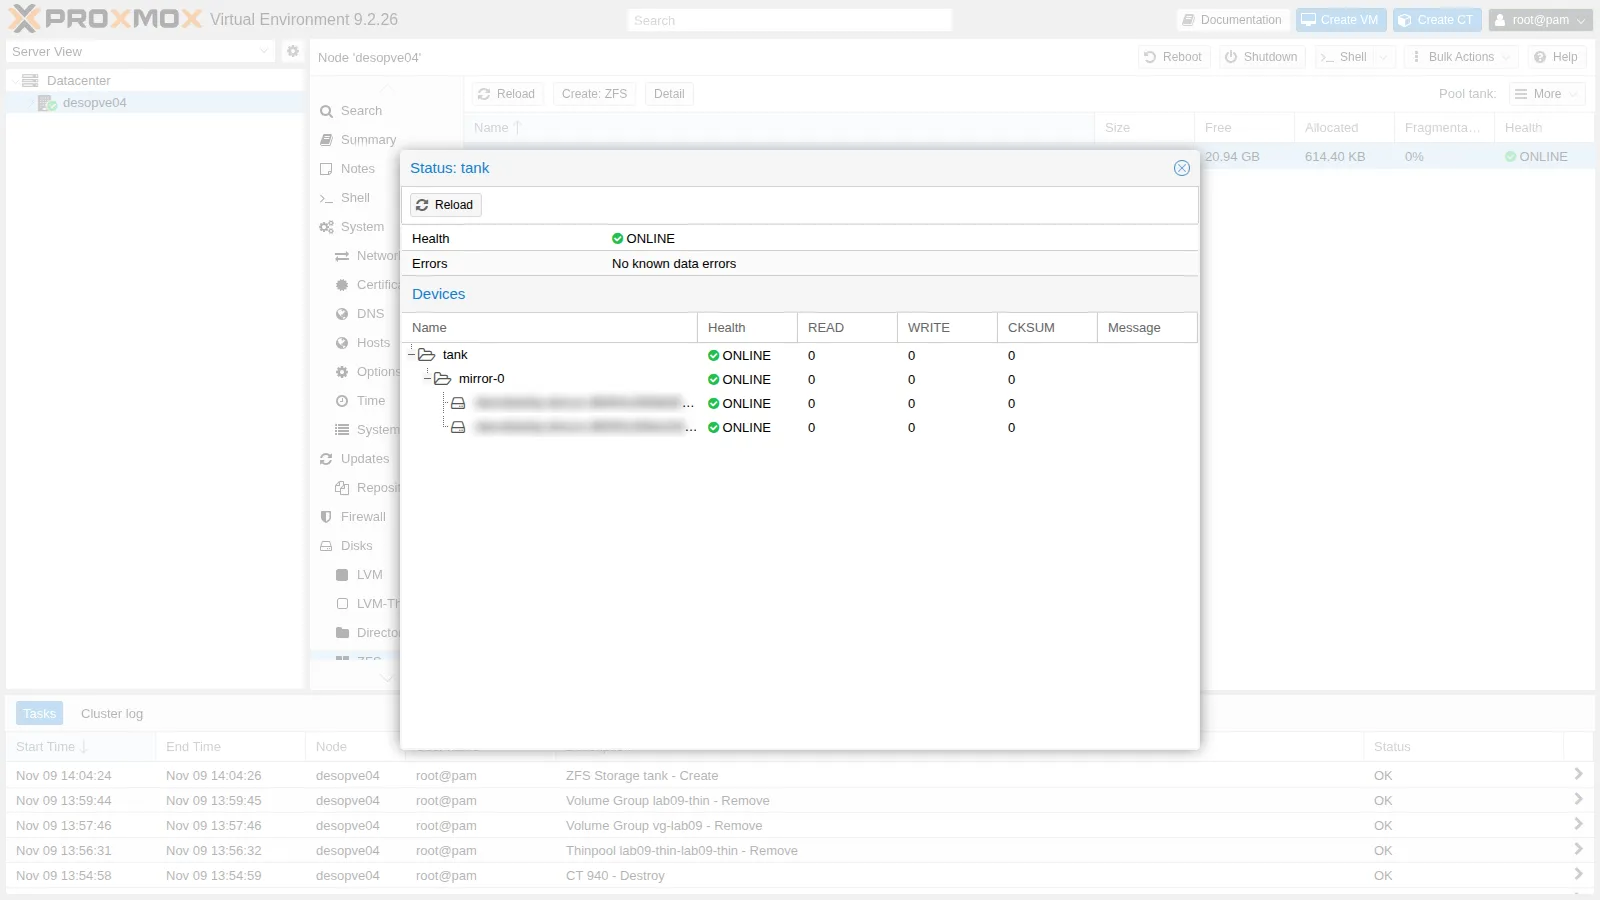
-
Da riga di comando:
root@desopve04 zpool status tankOutput pool: tankstate: ONLINEconfig:NAME STATE READ WRITE CKSUMtank ONLINE 0 0 0mirror-0 ONLINE 0 0 0scsi-<seriale-disco-sdb> ONLINE 0 0 0scsi-<seriale-disco-sdc> ONLINE 0 0 0errors: No known data errorsroot@desopve04 grep -A4 "zfspool: tank" /etc/pve/storage.cfgOutput zfspool: tankpool tankcontent rootdir,imagesmountpoint /tanknodes desopve04
3. Autoriparazione: corrompere un disco del mirror
Sezione intitolata “3. Autoriparazione: corrompere un disco del mirror”Questo passo distrugge di proposito una parte dei dati di un disco. Fallo solo su un pool di prova.
-
Crea un dataset, scrivi 1,5 GB di dati casuali e annota l’impronta del file:
root@desopve04 zfs create tank/datidd if=/dev/urandom of=/tank/dati/archivio.bin bs=1M count=1500 status=nonemd5sum /tank/dati/archivio.binOutput 15bd171a50378dae9c3153c9c48bdb00 /tank/dati/archivio.bin -
Sovrascrivi con zeri 3 GB della partizione dati di
sdc, partendo da 64 MiB per non toccare le etichette di ZFS all’inizio del disco:root@desopve04 dd if=/dev/zero of=/dev/sdc1 bs=1M seek=64 count=3000 oflag=direct status=none -
Lancia uno scrub e attendi che finisca (
-w):root@desopve04 zpool scrub -w tankzpool status tankOutput pool: tankstate: ONLINEstatus: One or more devices has experienced an unrecoverable error. Anattempt was made to correct the error. Applications are unaffected.action: Determine if the device needs to be replaced, and clear the errorsusing 'zpool clear' or replace the device with 'zpool replace'.see: https://openzfs.github.io/openzfs-docs/msg/ZFS-8000-9Pscan: scrub repaired 962M in 00:00:05 with 0 errors on Mon Nov 9 14:06:41 2026config:NAME STATE READ WRITE CKSUMtank ONLINE 0 0 0mirror-0 ONLINE 0 0 0scsi-<seriale-disco-sdb> ONLINE 0 0 0scsi-<seriale-disco-sdc> ONLINE 0 0 7.57Kerrors: No known data errors- Misura: lo scrub termina con
repaired 962M in 00:00:05 with 0 errors. Sul secondo disco il contatoreCKSUMsegna 7.57K, mentreREADeWRITErestano a 0. - Interpretazione: il disco ha restituito zeri al posto dei dati senza segnalare alcun errore di I/O, e solo i checksum dei blocchi lo hanno rivelato; ZFS ha riscritto i blocchi rovinati con la copia buona del primo disco. I 962 MiB riparati sono meno dei 3000 MiB sovrascritti: è compatibile con uno scrub che legge solo i blocchi allocati, per cui gli zeri scritti sullo spazio libero passano inosservati e non fanno danni.
- Verifica:
zpool list tankprima della prova mostra quanto spazio è allocato;zpool events -velenca gli eventi di errore di checksum, con il disco e le posizioni coinvolte.
- Misura: lo scrub termina con
-
Il file è intatto. Azzera i contatori:
root@desopve04 md5sum /tank/dati/archivio.binOutput 15bd171a50378dae9c3153c9c48bdb00 /tank/dati/archivio.binroot@desopve04 zpool clear tankzpool status -x tankOutput pool 'tank' is healthyIn produzione, un disco con errori di checksum va tenuto d’occhio, e sostituito se gli errori si ripetono. Il pacchetto
zfsutils-linuxprogramma uno scrub mensile di tutti i pool (/etc/cron.d/zfsutils-linux), ezfs-zedpuò segnalare i problemi con una mail aroot: che la mail arrivi davvero dipende dalla configurazione della posta del nodo, trattata nel Lab 51.
4. Creare un RAIDZ1 da riga di comando
Sezione intitolata “4. Creare un RAIDZ1 da riga di comando”Ora ricostruisci tank come RAIDZ1 su tre dischi. Prima elimini lo storage e il pool mirror:
pvesm remove tankzpool destroy tankPer indicare i dischi, invece di sdb… (che possono cambiare a ogni avvio) usa /dev/disk/by-path, che identifica la porta del controller. È un’alternativa stabile a by-id, comoda quando si vuole sapere in quale slot sta un disco:
ls -l /dev/disk/by-path/ | grep -v part | awk '{print $9, $11}' | grep scsipci-0000:02:00.0-scsi-0:0:0:0 ../../sdapci-0000:02:00.0-scsi-0:0:1:0 ../../sdbpci-0000:02:00.0-scsi-0:0:2:0 ../../sdcpci-0000:02:00.0-scsi-0:0:3:0 ../../sddpci-0000:02:00.0-scsi-0:0:4:0 ../../sdecd /dev/disk/by-pathzpool create -o ashift=12 -O compression=lz4 -O atime=off tank raidz1 pci-0000:02:00.0-scsi-0:0:1:0 pci-0000:02:00.0-scsi-0:0:2:0 pci-0000:02:00.0-scsi-0:0:3:0zpool status tank pool: tank state: ONLINEconfig:
NAME STATE READ WRITE CKSUM tank ONLINE 0 0 0 raidz1-0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:1:0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:2:0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:3:0 ONLINE 0 0 0
errors: No known data errorszpool list tankNAME SIZE ALLOC FREE CKPOINT EXPANDSZ FRAG CAP DEDUP HEALTH ALTROOTtank 59.5G 856K 59.5G - - 0% 0% 1.00x ONLINE -zfs list tankNAME USED AVAIL REFER MOUNTPOINTtank 512K 38.4G 128K /tank-o ashift=12è una proprietà del pool, fissata per sempre alla creazione;-Oimposta le proprietà del dataset radice, che i figli ereditano.atime=offevita una scrittura a ogni lettura di file.zpool listmostra lo spazio grezzo dei tre dischi, parità compresa: 59,5 GiB.zfs listmostra quello utilizzabile, cioè quanto i dataset possono davvero riempire: 38,4 GiB. I due terzi di 59,5 GiB sarebbero 39,7 GiB: l’equivalente di un disco va alla parità, e la differenza che resta è compatibile con la piccola quota del pool (1/32 per impostazione predefinita, lo slop space) che ZFS tiene di riserva e non mostra mai come disponibile. La quota è fissata dal parametro del modulospa_slop_shift(cat /sys/module/zfs/parameters/spa_slop_shift).
Aggiungi lo storage, con l’opzione sparse come local-zfs:
pvesm add zfspool tank --pool tank --content images,rootdir --sparse 1 --nodes desopve04pvesm statusName Type Status Total (KiB) Used (KiB) Available (KiB) %local dir active 22203544 5768732 15281584 25.98%local-lvm lvmthin active 14217216 0 14217216 0.00%tank zfspool active 40265280 543 40264736 0.00%5. Compressione a confronto
Sezione intitolata “5. Compressione a confronto”Crea tre dataset con compressione diversa e copia in ciascuno gli stessi file (documentazione e librerie Python, cioè testo e codice):
for c in off lz4 zstd; do zfs create -o compression=$c tank/comp-$c; cp -a /usr/share/doc /usr/lib/python3 /tank/comp-$c/; donezfs list -o name,compression,used,logicalused,compressratio -r tank | grep -E "NAME|comp-"NAME COMPRESS USED LUSED RATIOtank/comp-lz4 lz4 111M 112M 1.63xtank/comp-off off 157M 112M 1.00xtank/comp-zstd zstd 103M 112M 1.83x- Misura: sugli stessi 112 MiB di dati logici (
LUSED), il rapporto di compressione (compressratio, colonnaRATIO) è 1,83x con zstd e 1,63x con LZ4. Senza compressione è 1,00x, e lo spazio occupato nel pool (USED) è di 157 MiB: più dei dati logici. - Interpretazione:
- su questi file, testo e codice, zstd comprime più di LZ4. La prova non misura quanto costano i due algoritmi in CPU o in tempo.
compression=on, che su questo pool vuol dire LZ4, è il predefinito che la documentazione di OpenZFS descrive come un equilibrio tra velocità e rapporto di compressione; - lo spazio in più senza compressione è compatibile con il sovraccarico di allocazione dei blocchi piccoli: ogni blocco occupa un numero intero di settori da 4 KiB (
ashift=12) e su RAIDZ1 richiede anche almeno un settore di parità. Con tanti file piccoli, come qui, questo sovraccarico si vede inUSED, e la compressione ne riassorbe una parte. È compatibile anche con il fatto che con LZ4USED(111 MiB) sia vicino aLUSED(112 MiB) nonostante un rapporto di 1,63x: il rapporto descrive la sola compressione,USEDcomprende anche il sovraccarico di allocazione. La prova non separa la quota dovuta all’arrotondamento ai settori da quella dovuta al RAIDZ.
- su questi file, testo e codice, zstd comprime più di LZ4. La prova non misura quanto costano i due algoritmi in CPU o in tempo.
- Verifica: per confrontare il costo degli algoritmi, cronometra la stessa copia in ciascun dataset (
time cp -a …) con il nodo altrimenti scarico. Per separare le due quote, copia gli stessi file in un dataset senza compressione su un mirror con lo stessoashifte confrontausedconlogicalused: quello che resta è la quota dovuta all’arrotondamento ai settori.
6. Zvol e subvol: i dischi dei guest
Sezione intitolata “6. Zvol e subvol: i dischi dei guest”Alloca un disco per una VM (VMID di prova 990) e crea un container sullo storage tank:
pvesm alloc tank 990 vm-990-disk-0 4Gsuccessfully created 'tank:vm-990-disk-0'pct create 941 local:vztmpl/debian-13-standard_13.6-1_amd64.tar.zst --hostname lab10-ct --rootfs tank:4 --memory 512 --unprivileged 1 --features nesting=1 --ostype debian --net0 name=eth0,bridge=vmbr0,ip=172.27.199.141/24,gw=172.27.199.1pvesm list tankVolid Format Type Size VMIDtank:subvol-941-disk-0 subvol rootdir 4294967296 941tank:vm-990-disk-0 raw images 4294967296 990zfs list -t all -o name,type,volsize,refquota,used,mountpoint -r tank | grep -E "NAME|990|941"NAME TYPE VOLSIZE REFQUOTA USED MOUNTPOINTtank/subvol-941-disk-0 filesystem - 4G 346M /tank/subvol-941-disk-0tank/vm-990-disk-0 volume 4G - 74.6K -pct start 941pct exec 941 -- df -h /Filesystem Size Used Avail Use% Mounted ontank/subvol-941-disk-0 4.0G 351M 3.7G 9% /- Il disco della VM è uno zvol (
volume) da 4 GiB, thin: occupa 75 KiB. - Il disco del container è un dataset (
filesystem) conrefquotadi 4 GiB: il container vede un file system da 4 GiB, e il nodo vede i suoi file direttamente in/tank/subvol-941-disk-0.
7. Snapshot e rollback
Sezione intitolata “7. Snapshot e rollback”-
Crea un dataset di prova, fai uno snapshot e cancella i file:
root@desopve04 zfs create tank/snapdemo; cp -a /usr/share/doc /tank/snapdemo/zfs snapshot tank/snapdemo@arm -rf /tank/snapdemo/doc; synczfs list -t snapshot -o name,used,refer tank/snapdemoOutput NAME USED REFERtank/snapdemo@a 64.6M 64.7Mroot@desopve04 zfs list -o space tank/snapdemoOutput NAME AVAIL USED USEDSNAP USEDDS USEDREFRESERV USEDCHILDtank/snapdemo 37.5G 64.7M 64.6M 128K 0B 0BAppena creato, uno snapshot condivide tutti i suoi blocchi con il dataset e non occupa spazio proprio. Quando i file vengono cancellati, i loro blocchi restano allo snapshot: ora il dataset occupa 128 KiB (
USEDDS) e lo snapshot 64,6 MiB (USEDSNAP). La colonnaUSEDdi uno snapshot conta solo i blocchi che appartengono a lui solo: se più snapshot condividono gli stessi blocchi, ciascuno mostra0Be lo spazio compare solo inUSEDSNAP. -
I file dello snapshot si leggono, in sola lettura, nella cartella nascosta
.zfs/snapshot. Conzfs rollbackil dataset torna esattamente com’era. Lo provi sutank/comp-zstd:root@desopve04 zfs snapshot tank/comp-zstd@primarm -rf /tank/comp-zstd/docls /tank/comp-zstdOutput python3root@desopve04 ls /tank/comp-zstd/.zfs/snapshot/prima/Output docpython3root@desopve04 zfs rollback tank/comp-zstd@primals /tank/comp-zstdOutput docpython3root@desopve04 zfs destroy -r tank/snapdemozfs rollbacktorna solo all’ultimo snapshot: per tornare a uno precedente bisogna distruggere quelli successivi (-r). Gli snapshot dei dischi di VM e container si gestiscono dall’interfaccia web, che usa proprio gli snapshot ZFS (lab 16).
8. zfs send e zfs receive
Sezione intitolata “8. zfs send e zfs receive”zfs send trasforma uno snapshot in un flusso di dati, zfs receive lo ricrea altrove. È la base della replica di Proxmox VE (lab 11).
-
Copia completa e incrementale nello stesso pool:
root@desopve04 zfs snapshot tank/comp-zstd@s1zfs send tank/comp-zstd@s1 | zfs receive tank/copiadate > /tank/comp-zstd/nuovo.txtzfs snapshot tank/comp-zstd@s2zfs send -v -i @s1 tank/comp-zstd@s2 | zfs receive tank/copiaOutput send from tank/comp-zstd@s1 to tank/comp-zstd@s2 estimated size is 49.1Ktotal estimated size is 49.1KTIME SENT SNAPSHOT tank/comp-zstd@s2root@desopve04 zfs list -t snapshot -o name,used,refer -r tank/comp-zstd tank/copiaOutput NAME USED REFERtank/comp-zstd@prima 0B 103Mtank/comp-zstd@s1 0B 103Mtank/comp-zstd@s2 0B 103Mtank/copia@s1 95.9K 111Mtank/copia@s2 0B 111Mroot@desopve04 cat /tank/copia/nuovo.txtOutput Mon Nov 9 02:07:58 PM CET 2026L’invio incrementale (
-i @s1) porta solo i blocchi cambiati tra i due snapshot:zfs send -vstima il flusso in 49,1 KiB, mentre il dataset referenzia 103 MiB. È una stima stampata prima del trasferimento, e la dimensione del flusso completo inviato per primo non è stata misurata:zfs send -nvP tank/comp-zstd@s1(una prova a vuoto) la stampa senza inviare nulla.tank/copiareferenzia 111 MiB, più dei 103 MiB dell’origine. È compatibile con un flusso inviato senza-c: i dati viaggiano non compressi e vengono compressi di nuovo all’arrivo, con la proprietà chetank/copiaeredita datank(LZ4, gli stessi 111 MiB ditank/comp-lz4). Per verificarlo:zfs get compression,compressratio tank/copia. -
Verso un altro nodo, attraverso SSH.
desopve04non fa parte del cluster, quindi prima gli serve una chiave autorizzata sudesopve01.ssh-copy-idchiede una volta la password dirootdidesopve01:root@desopve04 Output /usr/bin/ssh-copy-id: INFO: Source of key(s) to be installed: "/root/.ssh/id_rsa.pub"/usr/bin/ssh-copy-id: INFO: attempting to log in with the new key(s), to filter out any that are already installed/usr/bin/ssh-copy-id: INFO: 1 key(s) remain to be installed -- if you are prompted now it is to install the new keysNumber of key(s) added: 1...root@desopve04 Output NAME USED REFERrpool/lab10-copia 93.5M 93.5Mrpool/lab10-copia@s2 0B 93.5MIl dataset arriva su
desopve01con il suo snapshot, e lì occupa 93,5 MiB, contro i 111 MiB della copia ricevuta sutank. La differenza è compatibile con l’assenza del sovraccarico del RAIDZ surpool, che è un mirror, ma la prova non esclude altre differenze tra i due pool, come la proprietà di compressione ereditata darpoolo il suoashift. Per verificarlo:zfs get compression,compressratio,logicalreferenced rpool/lab10-copiasudesopve01, ezpool get ashiftsui due pool.
9. Dimensionare l’ARC
Sezione intitolata “9. Dimensionare l’ARC”-
Il limite attuale è nel file creato dall’installazione e nel parametro del modulo:
root@desopve04 cat /etc/modprobe.d/zfs.confOutput options zfs zfs_arc_max=1676673024root@desopve04 arc_summary -s arc | sed -n 7,12pOutput ARC status:Total memory size: 15.6 GiBMin target size: 3.1 % 499.7 MiBMax target size: 10.0 % 1.6 GiBTarget size (adaptive): 44.1 % 1.6 GiBCurrent size: 44.1 % 705.3 MiB1.676.673.024 byte sono 1,6 GiB, il 10% dei 15,6 GiB di RAM che ZFS vede sul nodo. Su
desopve01, con 32 GB di RAM, la stessa regola dà circa 3,1 GiB: il valore esatto è nel file/etc/modprobe.d/zfs.confdi quel nodo. -
Porta il limite a 2 GiB a caldo, scrivendo nel parametro del modulo, e rendilo permanente in
zfs.conf:root@desopve04 echo $((2*1024*1024*1024)) > /sys/module/zfs/parameters/zfs_arc_maxsed -i "s/^options zfs zfs_arc_max=.*/options zfs zfs_arc_max=2147483648/" /etc/modprobe.d/zfs.confarc_summary -s arc | sed -n 8,12pOutput Total memory size: 15.6 GiBMin target size: 3.1 % 499.7 MiBMax target size: 12.8 % 2.0 GiBTarget size (adaptive): 33.2 % 1.6 GiBCurrent size: 33.2 % 679.9 MiBroot@desopve04 arcstat 1 3Output time read ddread ddh% dmread dmh% pread ph% size c avail14:08:38 0 0 0 0 0 0 0 680M 1.6G 12.2G14:08:39 0 0 0 0 0 0 0 680M 1.6G 12.2G14:08:40 0 0 0 0 0 0 0 680M 1.6G 12.2GIl massimo ora è 2,0 GiB, ma l’obiettivo (
cinarcstat, Target size inarc_summary) resta a 1,6 GiB e l’ARC occupa 680 MiB. Durante il campionamento non ci sono state letture (la colonnareadè a 0): è compatibile con un ARC che cresce solo quando ci sono dati da tenere in cache, e il nuovo limite conta sotto carico. Per vederlo, osservaarcstat 1mentre leggi più dati di quanti l’ARC ne possa contenere.Sui nodi con il sistema su ZFS (come
desopve01-03) il modulo si carica dall’initramfs: dopo aver cambiatozfs.confva lanciatoupdate-initramfs -u -k all, altrimenti al riavvio vale il limite vecchio.desopve04ha il sistema su ext4, quindi non serve. Questo lab non riavviadesopve04: dopo il prossimo riavvio,cat /sys/module/zfs/parameters/zfs_arc_maxdeve restituire2147483648.
Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se ogni controllo della tabella dà il risultato atteso. L’ultima colonna riporta quanto osservato in questa prova.
| Controllo | Vale come successo | Osservato in questa prova |
|---|---|---|
Pool e storage tank |
zpool status tank ONLINE con i tre dischi by-path; tank attivo in pvesm status |
ONLINE; storage attivo |
| Scrub dopo la corruzione di un disco del mirror | scrub repaired … with 0 errors, md5sum del file invariato, pool 'tank' is healthy dopo zpool clear |
962 MiB riparati in 5 secondi, CKSUM 7.57K sul disco corrotto, stesso md5sum |
| Spazio del RAIDZ1 | lo spazio utilizzabile di zfs list è circa due terzi di quello grezzo di zpool list, o poco meno |
38,4 GiB utilizzabili su 59,5 GiB grezzi |
| Compressione | compressratio sopra 1,00x sui dataset compressi |
LZ4 1,63x, zstd 1,83x, off 1,00x |
| Rollback | la cartella cancellata torna dopo zfs rollback |
doc di nuovo in tank/comp-zstd |
zfs send/receive |
i dataset ricevuti hanno i loro snapshot, e il file scritto dopo @s1 è in tank/copia |
tank/copia@s1, @s2 e nuovo.txt; rpool/lab10-copia@s2 su desopve01 |
| ARC | arc_summary mostra un Max target size di 2,0 GiB, e zfs.conf contiene 2147483648 |
2,0 GiB a caldo; tenuta dopo un riavvio non verificata in questo lab |
| Guasto di un disco (Test 1) | pool DEGRADED ma scrivibile, ONLINE dopo zpool replace, resilver con 0 errori |
scrittura riuscita durante il guasto; resilvered 435M in 00:00:12 with 0 errors |
| Disco di riserva (Test 2) | il disco elencato sotto spares come AVAIL, autoreplace=on |
AVAIL; attivazione automatica non provata |
Test 1 – Si guasta un disco del RAIDZ
Sezione intitolata “Test 1 – Si guasta un disco del RAIDZ”Configurazione provata. tank è un RAIDZ1 su tre dischi, indicati per vano (by-path), quindi sopporta la perdita di uno di essi. Il container 941 è acceso e ha il disco su tank. Il disco nel vano scsi-0:0:3:0 viene estratto a nodo acceso.
-
Estrai a caldo il disco nel vano
scsi-0:0:3:0(sdd). Comportamento osservato: il disco sparisce dal sistema e il pool lo segnaREMOVED:root@desopve04 lsblk -d -o NAME,SIZE | grep sdOutput sda 50Gsdb 20Gsdc 20Gsde 20Groot@desopve04 zpool status tankOutput pool: tankstate: DEGRADEDstatus: One or more devices have been removed.Sufficient replicas exist for the pool to continue functioning in adegraded state.action: Online the device using zpool online' or replace the device with'zpool replace'.config:NAME STATE READ WRITE CKSUMtank DEGRADED 0 0 0raidz1-0 DEGRADED 0 0 0pci-0000:02:00.0-scsi-0:0:1:0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:2:0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:3:0 REMOVED 0 0 0errors: No known data errorsroot@desopve04 journalctl -u zfs-zed --since "-15 min" --no-hostname | tail -2Output Nov 09 14:09:18 zed[24608]: eid=246 class=statechange pool='tank' vdev=pci-0000:02:00.0-scsi-0:0:3:0-part1 vdev_state=REMOVEDNov 09 14:09:19 zed[24927]: eid=247 class=removed pool='tank' vdev=pci-0000:02:00.0-scsi-0:0:3:0-part1 vdev_state=REMOVEDzfs-zed, il demone degli eventi di ZFS, registra la rimozione alle 14:09:18 e alle 14:09:19. La prova non annota il momento esatto dell’estrazione, quindi non misura quanto ZFS abbia impiegato ad accorgersene: il log del kernel (journalctl -k) mostra quando il disco è uscito dal bus SCSI. ZED può anche avvisarerootper mail (ZED_EMAIL_ADDRin/etc/zfs/zed.d/zed.rc), ma questo lab non ne verifica la consegna: nel Lab 51 le notifiche dei lab precedenti risultano ferme nella coda di Postfix dei nodi del cluster, epostqueue -psudesopve04mostra se è ferma anche questa. -
Il pool è DEGRADED ma resta in servizio: nel container una scrittura, un
synce una lettura vanno a buon fine.root@desopve04 pct exec 941 -- sh -c "date > /root/durante-il-guasto.txt; sync; cat /root/durante-il-guasto.txt"Output Mon Nov 9 13:10:55 UTC 2026L’orologio del container è in UTC: le 13:10:55 UTC sono le 14:10:55 del nodo, circa un minuto e mezzo dopo la rimozione registrata da ZED. Una scrittura è una verifica funzionale, non una prova di prestazioni: non dice quanto rallenti il pool mentre è degradato.
In Disks → ZFS → Detail il pool e il vdev sono in giallo, con il disco
REMOVED: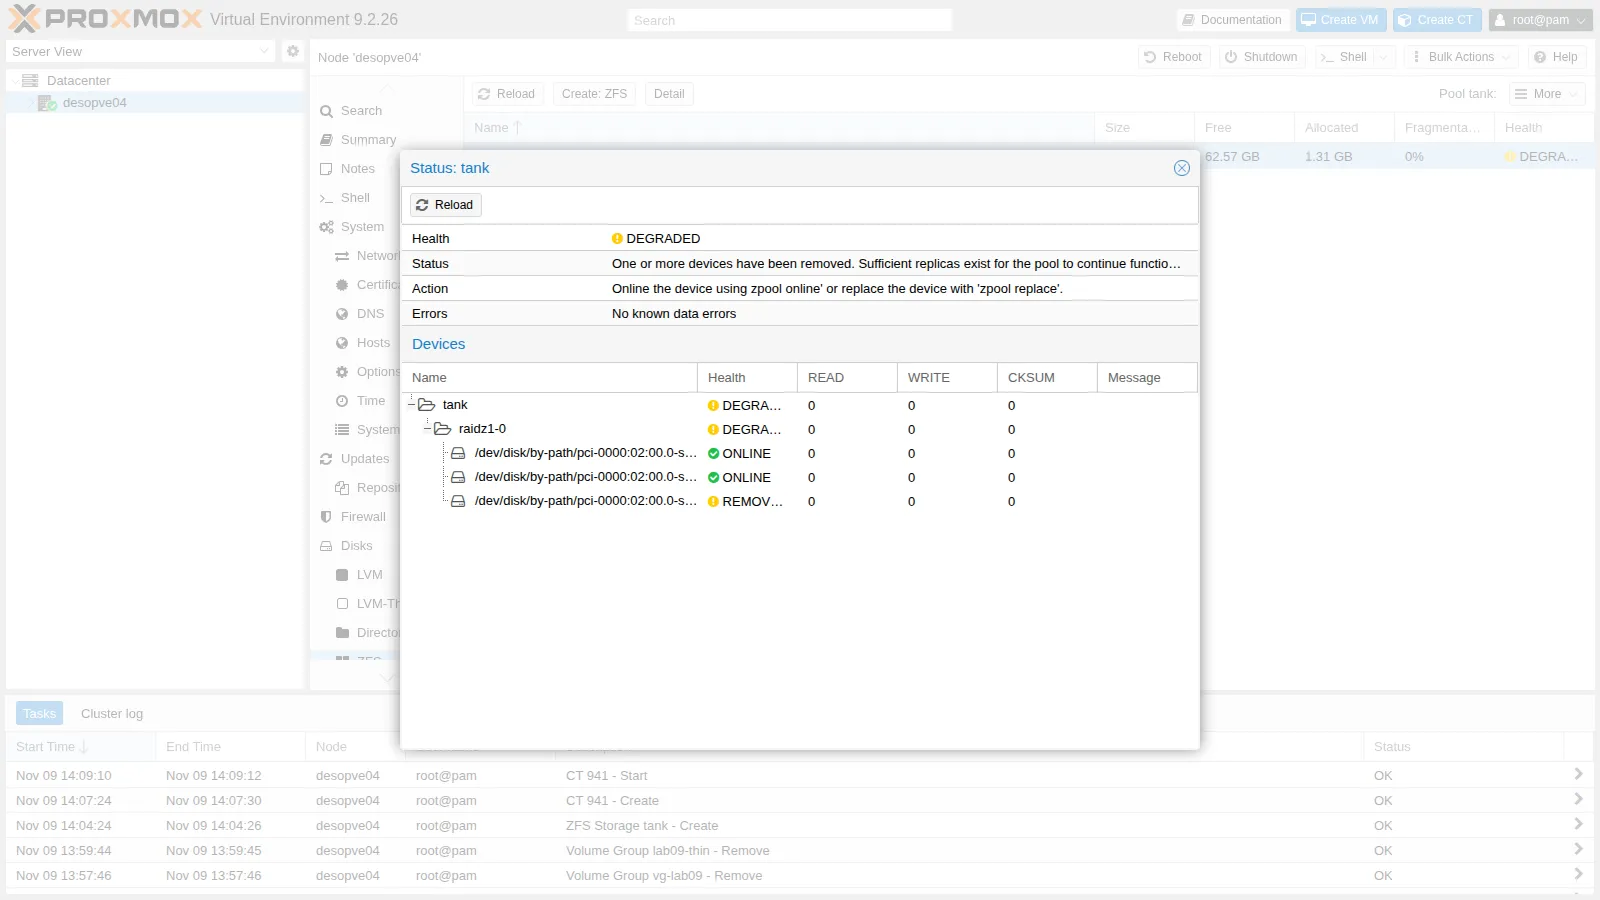
-
Decisione: il disco estratto non torna nel nodo, quindi il disco mancante si sostituisce con il disco libero
sde(vanoscsi-0:0:4:0). ZFS ricostruisce i dati mancanti dalla parità (resilver), lavorando solo sui blocchi in uso:root@desopve04 zpool replace tank pci-0000:02:00.0-scsi-0:0:3:0 /dev/disk/by-path/pci-0000:02:00.0-scsi-0:0:4:0zpool status tankOutput pool: tankstate: DEGRADEDstatus: One or more devices is currently being resilvered. The pool willcontinue to function, possibly in a degraded state.action: Wait for the resilver to complete.scan: resilver in progress since Mon Nov 9 14:11:25 20261.22G / 1.22G scanned, 345M / 1.12G issued at 173M/s100M resilvered, 30.18% done, 00:00:04 to goconfig:NAME STATE READ WRITE CKSUMtank DEGRADED 0 0 0raidz1-0 DEGRADED 0 0 0pci-0000:02:00.0-scsi-0:0:1:0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:2:0 ONLINE 0 0 0replacing-2 DEGRADED 0 0 0pci-0000:02:00.0-scsi-0:0:3:0 REMOVED 0 0 0pci-0000:02:00.0-scsi-0:0:4:0 ONLINE 0 0 0 (resilvering)errors: No known data errorsroot@desopve04 zpool wait -t resilver tank -
Risultato: alla fine del resilver ZFS stacca da solo il disco vecchio e il pool torna ONLINE:
root@desopve04 zpool status tankOutput pool: tankstate: ONLINEscan: resilvered 435M in 00:00:12 with 0 errors on Mon Nov 9 14:11:37 2026config:NAME STATE READ WRITE CKSUMtank ONLINE 0 0 0raidz1-0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:1:0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:2:0 ONLINE 0 0 0pci-0000:02:00.0-scsi-0:0:4:0 ONLINE 0 0 0errors: No known data errorsroot@desopve04 md5sum /tank/copia/nuovo.txt /tank/comp-zstd/nuovo.txtOutput 2b697b63aba1f00e8edd33f831903cf2 /tank/copia/nuovo.txt2b697b63aba1f00e8edd33f831903cf2 /tank/comp-zstd/nuovo.txtroot@desopve04 pct exec 941 -- cat /root/durante-il-guasto.txtOutput Mon Nov 9 13:10:55 UTC 2026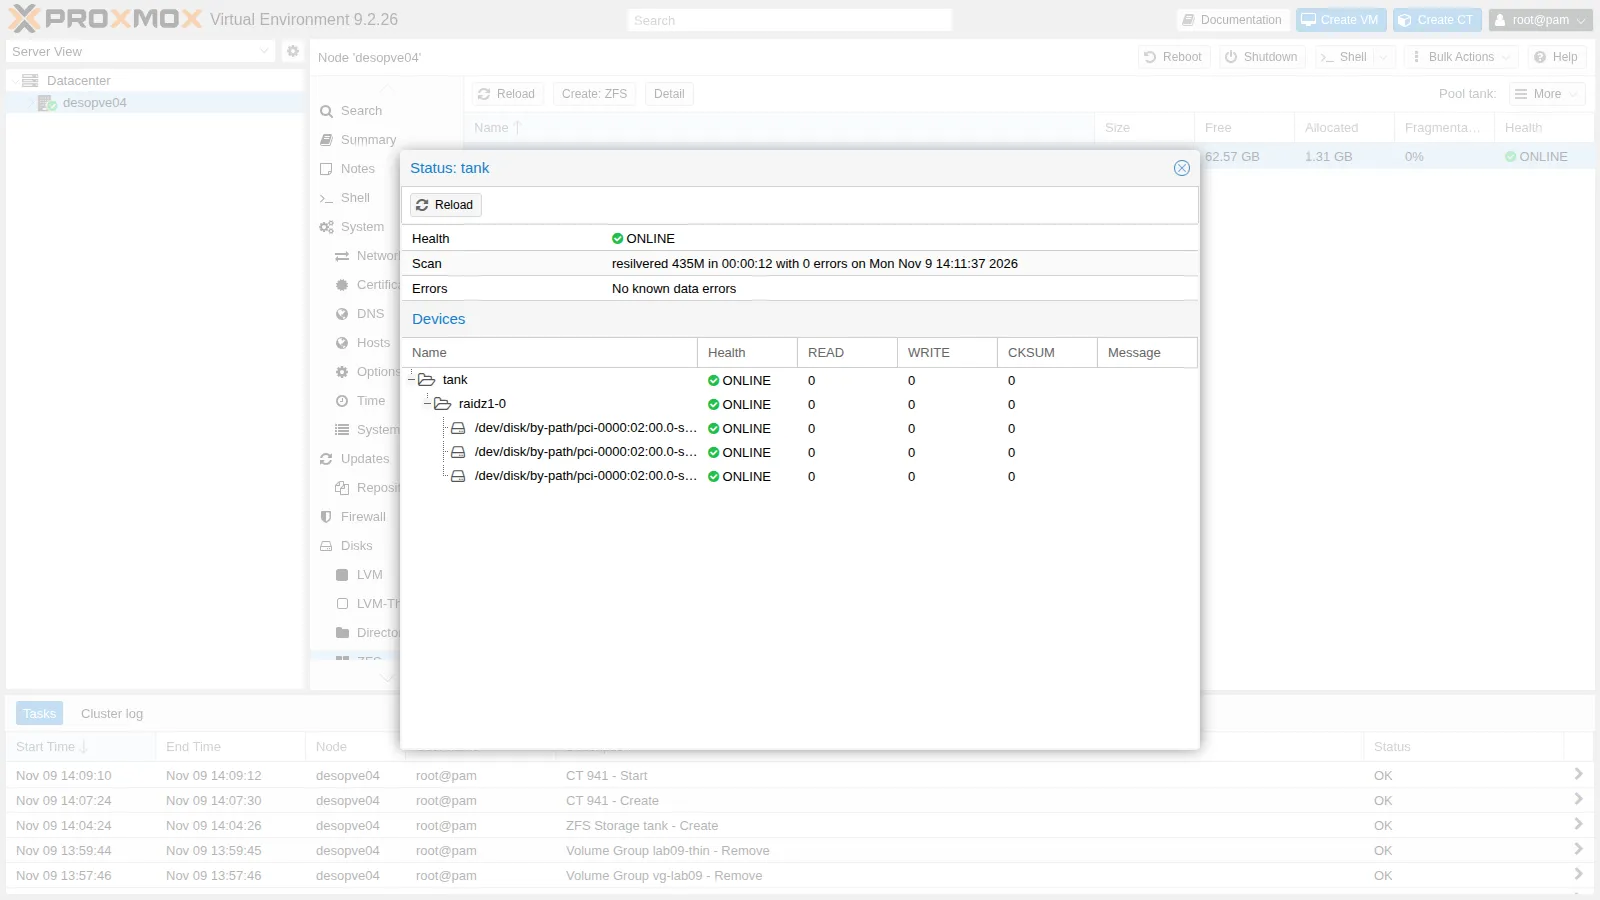
- Misura:
resilvered 435M in 00:00:12 with 0 errors. Durante il resilver la riga di avanzamento indicava 1.22G da esaminare e, in quel momento, una velocità di 173M/s. Dopo il resilver le due copie dinuovo.txthanno lo stessomd5sum, il file scritto durante il guasto si rilegge uguale ezpool statusriportaNo known data errors. - Interpretazione: i controlli non mostrano perdite di dati, nemmeno per quelli scritti mentre il pool era degradato; coprono però i file controllati, non ogni blocco del pool. Il resilver ha esaminato 1,22 GiB, una piccola parte di un disco da 20 GB: è compatibile con un resilver che lavora solo sui blocchi allocati. I 12 secondi valgono per questa quantità di dati: con un pool più pieno, o sotto carico, il resilver dura di più, e questa prova non dice quanto.
- Verifica: uno scrub dopo il resilver (
zpool scrub -w tank) rilegge tutti i blocchi e ne controlla i checksum. Per capire come cresce la durata, annotaALLOCdizpool list tankprima di estrarre il disco e ripeti la prova con più dati.
- Misura:
Test 2 – Un disco di riserva
Sezione intitolata “Test 2 – Un disco di riserva”Inserisci il disco nuovo da 20 GB nel vano libero scsi-0:0:5:0 (se il kernel non lo vede, ripeti la scansione dei bus del Lab 09). Il kernel gli dà il primo nome libero, sdd: lo stesso del disco rimosso, ma è un altro disco. È il motivo per cui i pool si costruiscono con nomi stabili (by-path o by-id) e non con sdX.
ls -l /dev/disk/by-path/ | grep -v part | awk '{print $9, $11}' | grep scsipci-0000:02:00.0-scsi-0:0:0:0 ../../sdapci-0000:02:00.0-scsi-0:0:1:0 ../../sdbpci-0000:02:00.0-scsi-0:0:2:0 ../../sdcpci-0000:02:00.0-scsi-0:0:4:0 ../../sdepci-0000:02:00.0-scsi-0:0:5:0 ../../sddzpool add tank spare /dev/disk/by-path/pci-0000:02:00.0-scsi-0:0:5:0zpool set autoreplace=on tankzpool status tank pool: tank state: ONLINE scan: resilvered 435M in 00:00:12 with 0 errors on Mon Nov 9 14:11:37 2026config:
NAME STATE READ WRITE CKSUM tank ONLINE 0 0 0 raidz1-0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:1:0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:2:0 ONLINE 0 0 0 pci-0000:02:00.0-scsi-0:0:4:0 ONLINE 0 0 0 spares pci-0000:02:00.0-scsi-0:0:5:0 AVAIL
errors: No known data errors- Lo spare (
AVAIL) resta inattivo. Secondo la documentazione di OpenZFS, se un disco del pool si guasta lo spare lo sostituisce da solo, senza aspettare un intervento umano; su Linux èzfs-zedad avviare la sostituzione e il resilver. Il disco guasto va poi sostituito, e lo spare torna disponibile. autoreplace=onfa un’altra cosa: un disco nuovo inserito nello stesso vano, cioè nella stessa posizione fisica di un disco che faceva parte del pool, viene formattato e usato da solo per sostituirlo. Anche questo richiedezfs-zedin funzione.- Questo lab non prova nessuno dei due comportamenti. Per vederli, estrai di nuovo un disco del pool e osserva
zpool status: lo spare dovrebbe passare aINUSEe il resilver partire senza alcunzpool replace; poi inserisci un disco nuovo nel vano di quello estratto.
Pulizia
Sezione intitolata “Pulizia”Elimina il container, il disco di prova e i dataset del lab, il dataset ricevuto su desopve01 e la chiave di desopve04 dal cluster. Il pool tank resta: servirà nel lab 19.
pct stop 941 && pct destroy 941 --purge 1purging CT 941 from related configurations..pvesm free tank:vm-990-disk-0Removed volume 'tank:vm-990-disk-0'for d in comp-off comp-lz4 comp-zstd copia; do zfs destroy -r tank/$d; donezfs list -r tankNAME USED AVAIL REFER MOUNTPOINTtank 794K 38.4G 139K /tankssh [email protected] 'zfs destroy -r rpool/lab10-copia; sed -i "/ root@desopve04$/d" /etc/pve/priv/authorized_keys'[email protected]: Permission denied (publickey,password).La connessione ora viene rifiutata: la chiave di desopve04 non apre più desopve01.
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Sul cluster nulla è cambiato: il dataset ricevuto è stato eliminato da
desopve01e la chiave didesopve04tolta dagliauthorized_keysdel cluster. desopve04:- pool
tank: RAIDZ1 sui dischipci-0000:02:00.0-scsi-0:0:1:0,0:2:0e0:4:0, con lo spare0:5:0. Proprietàcompression=lz4,atime=off,autoreplace=on; è vuoto, con 38,4 GiB utilizzabili; - storage
tank(zfspool, contenutiimages,rootdir,sparse, solodesopve04); - il vano
scsi-0:0:3:0è vuoto: il disco estratto nel Test 1 non torna nel nodo; - ARC limitato a 2 GiB in
/etc/modprobe.d/zfs.conf; - template
debian-13-standard_13.6-1_amd64.tar.zstnello storagelocal.
- pool
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Scegliere la disposizione dei vdev. La ridondanza sta dentro ogni vdev, e perdere un vdev significa perdere il pool. Per i dischi delle VM, dove contano gli IOPS, scegli mirror o mirror in striping; scegli RAIDZ dove conta lo spazio, come per backup e archivi.
- Dare nomi ai dischi. Costruisci i pool con nomi stabili (
by-idoby-path), mai consdX: nel Test 2 il disco nuovo ha preso il nomesdd, lo stesso del disco estratto nel Test 1. - Pianificare lo spazio. Ragiona sullo spazio utilizzabile di
zfs list, non su quello grezzo dizpool list. Su RAIDZ i file piccoli costano più di quanto dica il rapporto di parità: senza compressione 112 MiB di dati ne hanno occupati 157. - Attivare la compressione. Tienila attiva per impostazione predefinita (LZ4 o zstd) e confronta gli algoritmi sui tuoi dati con
compressratio; se conta la CPU, misurane il costo a parte, perché il rapporto non lo mostra. - Reagire agli errori di checksum. Errori
CKSUMsenza erroriREADoWRITEvogliono dire che un disco ha restituito dati sbagliati senza segnalarlo: lancia uno scrub, tieni d’occhio il disco e sostituiscilo se gli errori tornano. Mantieni lo scrub mensile e verifica che le notifiche di ZED arrivino davvero (Lab 51). - Usare snapshot e send/receive. Lo spazio trattenuto dagli snapshot si legge in
USEDSNAP; il rollback torna solo all’ultimo snapshot; l’invio incrementale sposta solo le modifiche, come fa la replica (Lab 11). - Dimensionare l’ARC. Imposta
zfs_arc_maxin base alla RAM che serve ai guest e alla dimensione dei pool (la documentazione di Proxmox VE suggerisce almeno 2 GiB più 1 GiB per TiB di spazio), a caldo e in/etc/modprobe.d/zfs.conf, conupdate-initramfs -u -k allsui nodi che si avviano da ZFS, e controlla il valore dopo il riavvio successivo. - Gestire un disco guasto. Un RAIDZ1 degradato funziona ma non ha più ridondanza: sostituisci subito il disco con
zpool replace, conferma con uno scrub e valuta uno spare, così la ricostruzione parte senza aspettare un intervento umano. Valuta la durata del resilver sui tuoi dati: i 12 secondi visti qui valgono per 1,22 GiB.
Riferimenti
Sezione intitolata “Riferimenti”- Proxmox VE – ZFS on Linux
- Proxmox VE – Scelta del livello RAID ZFS: prestazioni, spazio e parità dei blocchi piccoli
- Proxmox VE – Notifiche via mail di ZED
- Proxmox VE – Limit ZFS Memory Usage
- Proxmox VE – Local ZFS Pool Backend
- OpenZFS 2.4 –
zpool scrub: cosa esaminano scrub e resilver - OpenZFS 2.4 –
zpool replace - OpenZFS 2.4 – Dischi di riserva (hot spare) e proprietà
autoreplace - OpenZFS 2.4 – Proprietà
compressione arrotondamento a settori interi - OpenZFS 2.4 – Conteggio dello spazio:
used,usedbysnapshots,logicalused - OpenZFS 2.4 –
zfs send: flussi incrementali, compressi e prove a vuoto - OpenZFS 2.4 – Parametri del modulo:
spa_slop_shift - OpenZFS 2.4 – Pagine di manuale di
zpoolezfs