

Lab 33 – Firewall 2: nftables, firewall degli host, anti-spoofing, VNet e conntrack
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- Lab 32: firewall del Datacenter attivo, firewall degli host disattivato sui nodi del cluster, CT 101 protetto, script di prova
fwtest.ps1sul DC; - Lab 07: VM 100, migrata a caldo per verificare la rete di migrazione;
- Lab 15: percorsi iSCSI con multipath, controllati dopo l’attivazione;
- Lab 17 e Lab 22: reti di Ceph (VLAN 50/51), Corosync (VLAN 40) e migrazione (VLAN 100);
- Lab 27: zona
simple1con DHCP e DNS didnsmasq, CT 271 e 272; - Lab 29, Lab 30 e Lab 31: VXLAN, BGP/BFD sulla VLAN 61 e la fabric
fab1; - Lab 25: gestione anche in IPv6 (
fd27:199::/64).
- Lab 32: firewall del Datacenter attivo, firewall degli host disattivato sui nodi del cluster, CT 101 protetto, script di prova
- Nodi:
desopve01,desopve02,desopve03.desopve04non cambia. - Credenziali:
root/<password-lab>→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Conoscere i due motori del firewall di Proxmox VE e passare a quello basato su nftables.
- Accendere il firewall degli host di un cluster con servizi su molte reti, senza interrompere nulla e con un piano di rientro automatico.
- Impedire a un guest di usare un indirizzo IP o MAC diverso da quello assegnato.
- Filtrare il traffico dentro una VNet con il firewall delle VNet.
- Leggere lo stato delle connessioni (conntrack) e riconoscere quando è conntrack a scartare i pacchetti.
Come funziona
Sezione intitolata “Come funziona”Due motori per le stesse regole
Sezione intitolata “Due motori per le stesse regole”Le regole si scrivono sempre allo stesso modo (GUI, pvesh, file .fw); cambia il programma che le traduce nel kernel. Il motore si sceglie per nodo, con l’opzione nftables del firewall del nodo.
pve-firewall (predefinito) |
proxmox-firewall (nftables) |
|
|---|---|---|
| Tecnologia | iptables, ip6tables, ebtables, ipset | nftables |
| Guest con firewall | un bridge fwbr per ogni scheda |
nessun bridge in più: le regole stanno in una tabella bridge |
| Dove si leggono le regole | iptables -S, ipset list |
nft list ruleset |
| Firewall delle VNet SDN | non disponibile | disponibile |
| Stato in Proxmox VE 9.2 | stabile | nella GUI è ancora segnato tech preview |
Con nftables, sul nodo compaiono due tabelle:
inet proxmox-firewall: host e traffico instradato;bridge proxmox-firewall-guests: guest e VNet.
Il firewall dell’host in un cluster vero
Sezione intitolata “Il firewall dell’host in un cluster vero”Nel Lab 32 si è visto che le regole automatiche dell’host coprono:
- la gestione (GUI, SSH, console) dal set
management, a cui si aggiunge da sola la rete del cluster; - Corosync tra i nodi.
Tutto il resto arriva sulla policy DROP. In questo cluster i servizi tra i nodi sono molti di più:
| Servizio | Rete | Porte |
|---|---|---|
| Corosync, secondo collegamento | VLAN 40, 10.40.10.0/24 | UDP 5405-5412 |
| Ceph public e cluster | VLAN 50/51, 10.50.10.0/24 e 10.51.10.0/24 | macro Ceph (TCP 6789, 3300, 6800-7300) |
| BGP del controller EVPN | VLAN 61, 10.61.10.0/24 | TCP 179 |
| BFD | VLAN 61 | UDP 3784-3785 |
VXLAN della zona evpnz |
VLAN 61 | UDP 4789 |
VXLAN della zona vxz |
fabric, 10.80.80.0/24 | UDP 4789 |
| Migrazione | VLAN 100, 10.100.10.0/24 | SSH e TCP 60000-60050 |
DHCP e DNS di dnsmasq |
VNet vnsimp1 |
UDP 67, DNS |
| Ping al gateway SDN | subnet SDN | ICMP echo |
| Gestione in IPv6 | fd27:199::/64 |
come per IPv4 |
OpenFabric non compare: usa pacchetti IS-IS di livello 2, non IP, e il firewall non li tocca.
Il “dead man’s switch”
Sezione intitolata “Il “dead man’s switch””Prima di accendere il firewall di un nodo da remoto si programma un rientro automatico: un timer che fra 4 minuti spegne di nuovo il firewall. Se tutto funziona, si disinnesca il timer. Se invece la modifica taglia fuori l’operatore o un servizio, il timer rimette le cose come prima senza bisogno di andare in console.
Anti-spoofing
Sezione intitolata “Anti-spoofing”Ogni guest con il firewall attivo ha due protezioni contro l’uso di indirizzi altrui:
- Filtro MAC (
MAC filter, attivo di default): il guest può trasmettere solo con il MAC configurato nella sua scheda. - Filtro IP (
IP filter, spento di default): il guest può usare come sorgente solo gli indirizzi del setipfilter-net<n>. Se il set non viene creato a mano, Proxmox VE lo riempie con gli indirizzi configurati nella scheda e con l’indirizzo link-local IPv6 derivato dal MAC.
Il firewall delle VNet
Sezione intitolata “Il firewall delle VNet”Le regole di una VNet hanno la direzione forward e una policy propria (policy_forward). Il ruleset generato in questo laboratorio mostra dove si applicano:
- al traffico tra i guest della stessa VNet (bridge, catena
forwarddella tabellabridge); - al traffico tra la VNet e il nodo stesso (catene
host-bridge-inputehost-bridge-output): gateway, DHCP, DNS.
Il traffico che dalla VNet viene instradato verso altre reti non passa da queste regole. Per filtrarlo servono le regole dei guest (in uscita) o quelle dell’host.
conntrack
Sezione intitolata “conntrack”Il firewall è stateful: per ogni connessione il kernel tiene una voce nella tabella di conntrack (NEW, ESTABLISHED, RELATED, INVALID). Le risposte di una connessione permessa passano senza bisogno di regole. Un pacchetto che conntrack non riesce a collegare a nessuno stato valido è INVALID e viene scartato.
Procedura
Sezione intitolata “Procedura”1. Le regole per i servizi del cluster
Sezione intitolata “1. Le regole per i servizi del cluster”Prima gli alias delle reti del cluster:
A() { pvesh create /cluster/firewall/aliases --name "$1" --cidr "$2" --comment "$3"; }A rete-corosync-2 10.40.10.0/24 "Corosync, secondo collegamento (VLAN 40)"A ceph-public 10.50.10.0/24 "Ceph public network (VLAN 50)"A ceph-cluster 10.51.10.0/24 "Ceph cluster network (VLAN 51)"A underlay-evpn 10.61.10.0/24 "Underlay EVPN: BGP, BFD, VXLAN (VLAN 61)"A fabric 10.80.80.0/24 "Indirizzi dei nodi nella fabric fab1"A rete-migrazione 10.100.10.0/24 "Rete di migrazione (VLAN 100)"A rete-gestione-v6 fd27:199::/64 "Rete di gestione IPv6"Poi due IPSet:
management, con la rete di gestione IPv4 e IPv6. Senza questo set, l’accesso in IPv6 verrebbe bloccato, come visto sudesopve04nel Lab 32.reti-sdn, con le subnet SDN che hanno il gateway sui nodi.
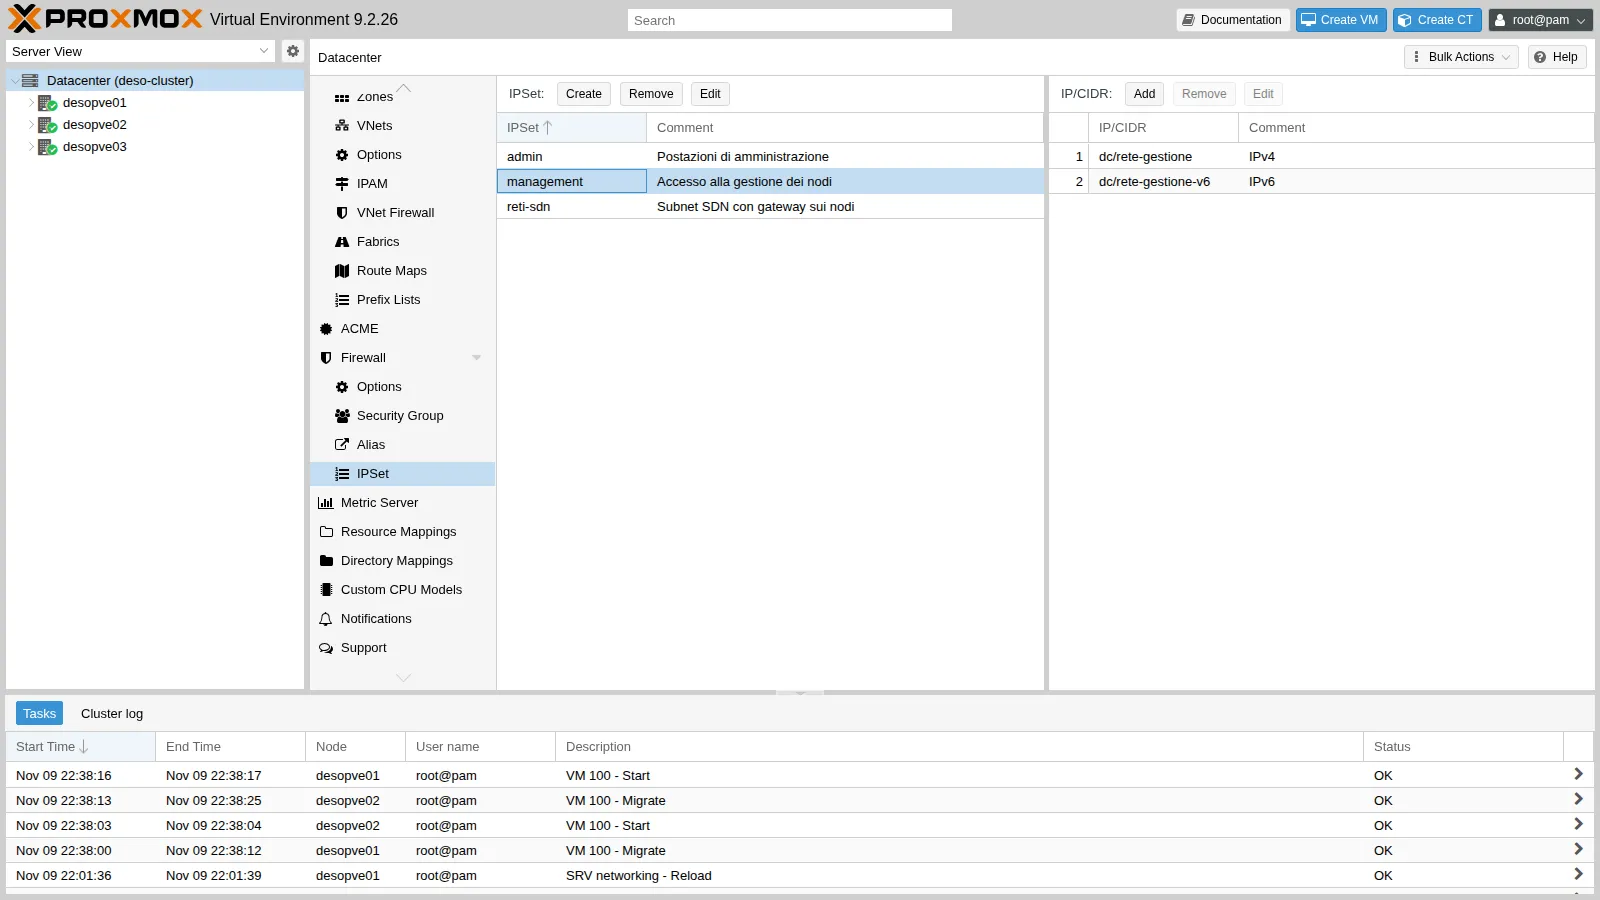
pvesh create /cluster/firewall/ipset --name management --comment "Accesso alla gestione dei nodi"pvesh create /cluster/firewall/ipset/management --cidr dc/rete-gestione --comment "IPv4"pvesh create /cluster/firewall/ipset/management --cidr dc/rete-gestione-v6 --comment "IPv6"pvesh create /cluster/firewall/ipset --name reti-sdn --comment "Subnet SDN con gateway sui nodi"for c in 10.60.60.0/24 10.71.71.0/24 10.72.72.0/24; do pvesh create /cluster/firewall/ipset/reti-sdn --cidr $cdoneInfine il security group servizi-cluster, con una regola per ogni riga della tabella vista sopra:
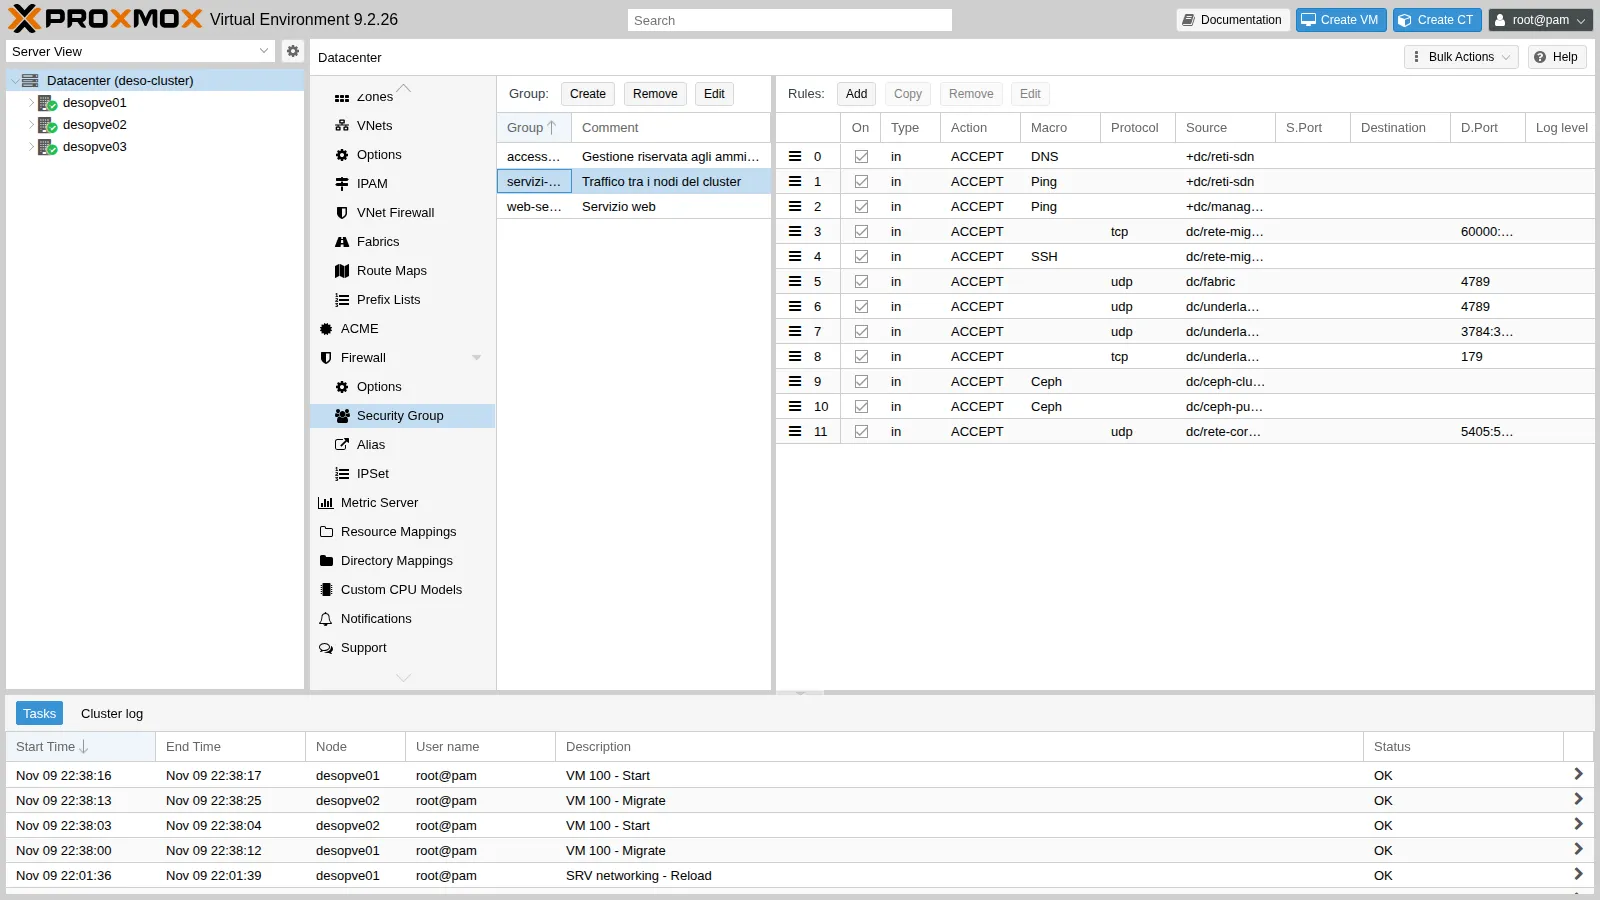
Da riga di comando, su un qualsiasi nodo. Ogni regola creata con pvesh va in cima al gruppo, quindi per ottenere l’ordine della tabella si parte dall’ultima:
G=/cluster/firewall/groups/servizi-clusterpvesh create /cluster/firewall/groups --group servizi-cluster --comment "Traffico tra i nodi del cluster"# ogni regola nuova va in cima: si creano dall'ultima alla primapvesh create $G --type in --action ACCEPT --source dc/rete-corosync-2 --proto udp --dport 5405:5412 --enable 1 --comment "Corosync link 1"pvesh create $G --type in --action ACCEPT --macro Ceph --source dc/ceph-public --enable 1 --comment "Ceph public"pvesh create $G --type in --action ACCEPT --macro Ceph --source dc/ceph-cluster --enable 1 --comment "Ceph cluster"pvesh create $G --type in --action ACCEPT --source dc/underlay-evpn --proto tcp --dport 179 --enable 1 --comment "BGP (controller EVPN)"pvesh create $G --type in --action ACCEPT --source dc/underlay-evpn --proto udp --dport 3784:3785 --enable 1 --comment "BFD"pvesh create $G --type in --action ACCEPT --source dc/underlay-evpn --proto udp --dport 4789 --enable 1 --comment "VXLAN zona evpnz"pvesh create $G --type in --action ACCEPT --source dc/fabric --proto udp --dport 4789 --enable 1 --comment "VXLAN zona vxz sulla fabric"pvesh create $G --type in --action ACCEPT --macro SSH --source dc/rete-migrazione --enable 1 --comment "Migrazione: tunnel SSH"pvesh create $G --type in --action ACCEPT --source dc/rete-migrazione --proto tcp --dport 60000:60050 --enable 1 --comment "Migrazione: porte dati"pvesh create $G --type in --action ACCEPT --macro Ping --source +dc/management --enable 1 --comment "Ping dalla gestione"pvesh create $G --type in --action ACCEPT --macro Ping --source +dc/reti-sdn --enable 1 --comment "Ping dei guest verso il gateway SDN"pvesh create $G --type in --action ACCEPT --macro DNS --source +dc/reti-sdn --enable 1 --comment "DNS di dnsmasq per le zone SDN"[group servizi-cluster] # Traffico tra i nodi del cluster
IN DNS(ACCEPT) -source +dc/reti-sdn # DNS di dnsmasq per le zone SDNIN Ping(ACCEPT) -source +dc/reti-sdn # Ping dei guest verso il gateway SDNIN Ping(ACCEPT) -source +dc/management # Ping dalla gestioneIN ACCEPT -source dc/rete-migrazione -p tcp -dport 60000:60050 # Migrazione: porte datiIN SSH(ACCEPT) -source dc/rete-migrazione # Migrazione: tunnel SSHIN ACCEPT -source dc/fabric -p udp -dport 4789 # VXLAN zona vxz sulla fabricIN ACCEPT -source dc/underlay-evpn -p udp -dport 4789 # VXLAN zona evpnzIN ACCEPT -source dc/underlay-evpn -p udp -dport 3784:3785 # BFDIN ACCEPT -source dc/underlay-evpn -p tcp -dport 179 # BGP (controller EVPN)IN Ceph(ACCEPT) -source dc/ceph-cluster # Ceph clusterIN Ceph(ACCEPT) -source dc/ceph-public # Ceph publicIN ACCEPT -source dc/rete-corosync-2 -p udp -dport 5405:5412 # Corosync link 1La regola per il DHCP di dnsmasq deve indicare l’interfaccia vnsimp1, perché la richiesta DHCP arriva con sorgente 0.0.0.0. In un security group l’interfaccia non è ammessa:
400 Parameter verification failed.type: parameter -i not allowed for this rule typeVa quindi nelle regole di ciascun nodo, insieme al gruppo:
for n in desopve01 desopve02 desopve03; do pvesh create /nodes/$n/firewall/rules --type in --action ACCEPT --proto udp --dport 67 \ --iface vnsimp1 --enable 1 --comment "DHCP di dnsmasq nella zona simple1" pvesh create /nodes/$n/firewall/rules --type group --action servizi-cluster --enable 1done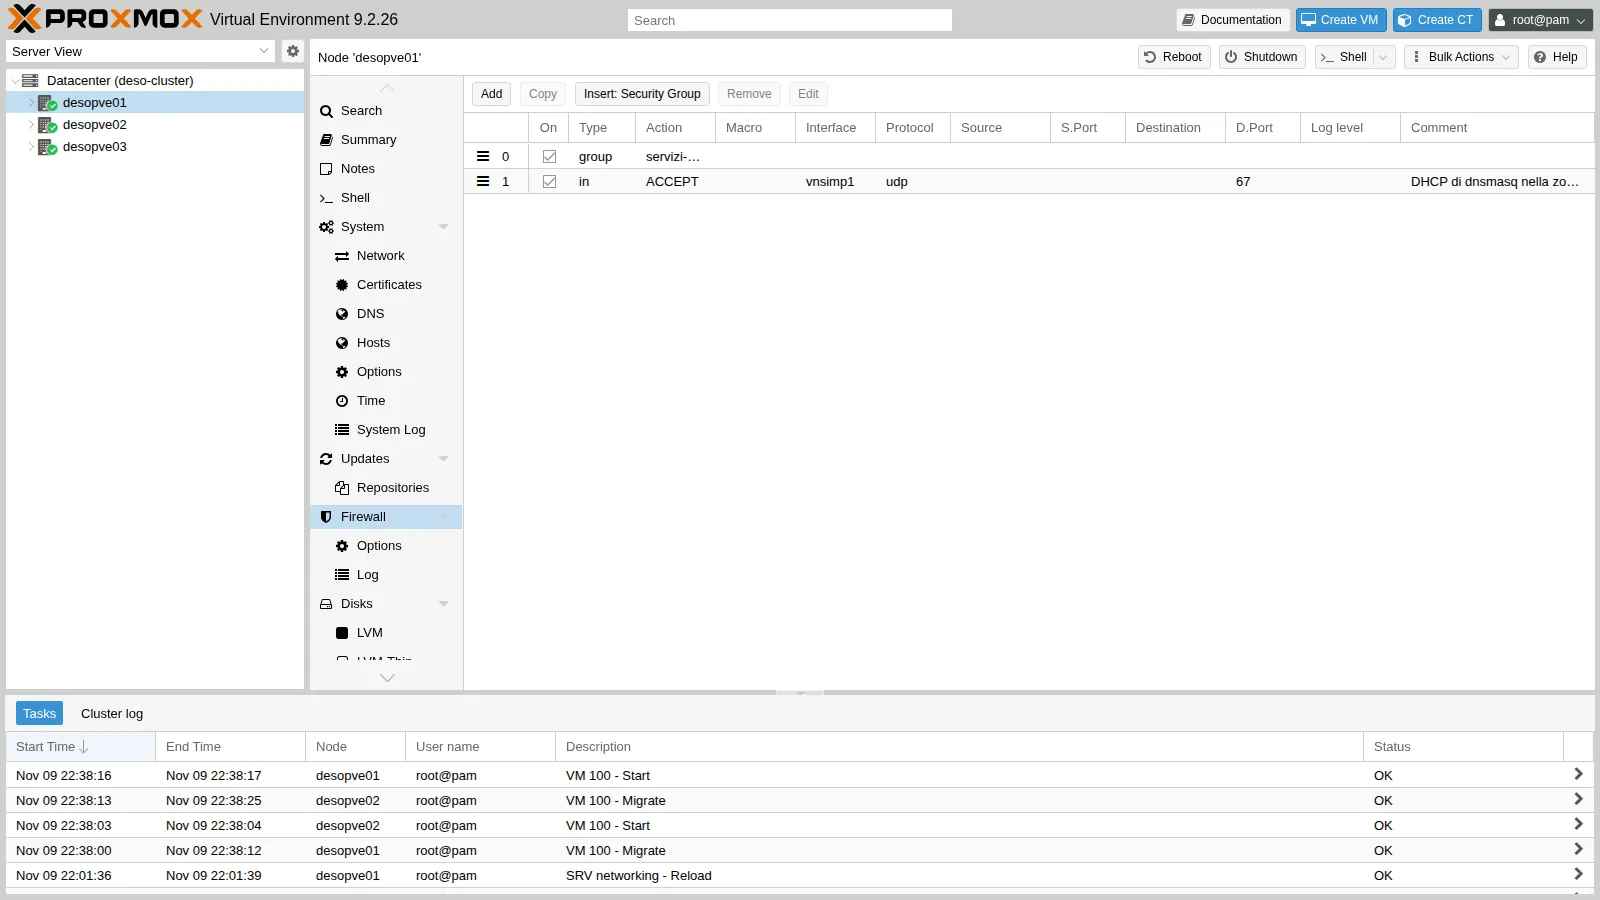
Fin qui nessuna regola è attiva: il firewall dei nodi è ancora spento.
2. Accendere nftables e il firewall, un nodo alla volta
Sezione intitolata “2. Accendere nftables e il firewall, un nodo alla volta”Il passaggio dalla GUI è in Nodo → Firewall → Options: doppio clic su nftables (tech preview) e poi su Firewall.
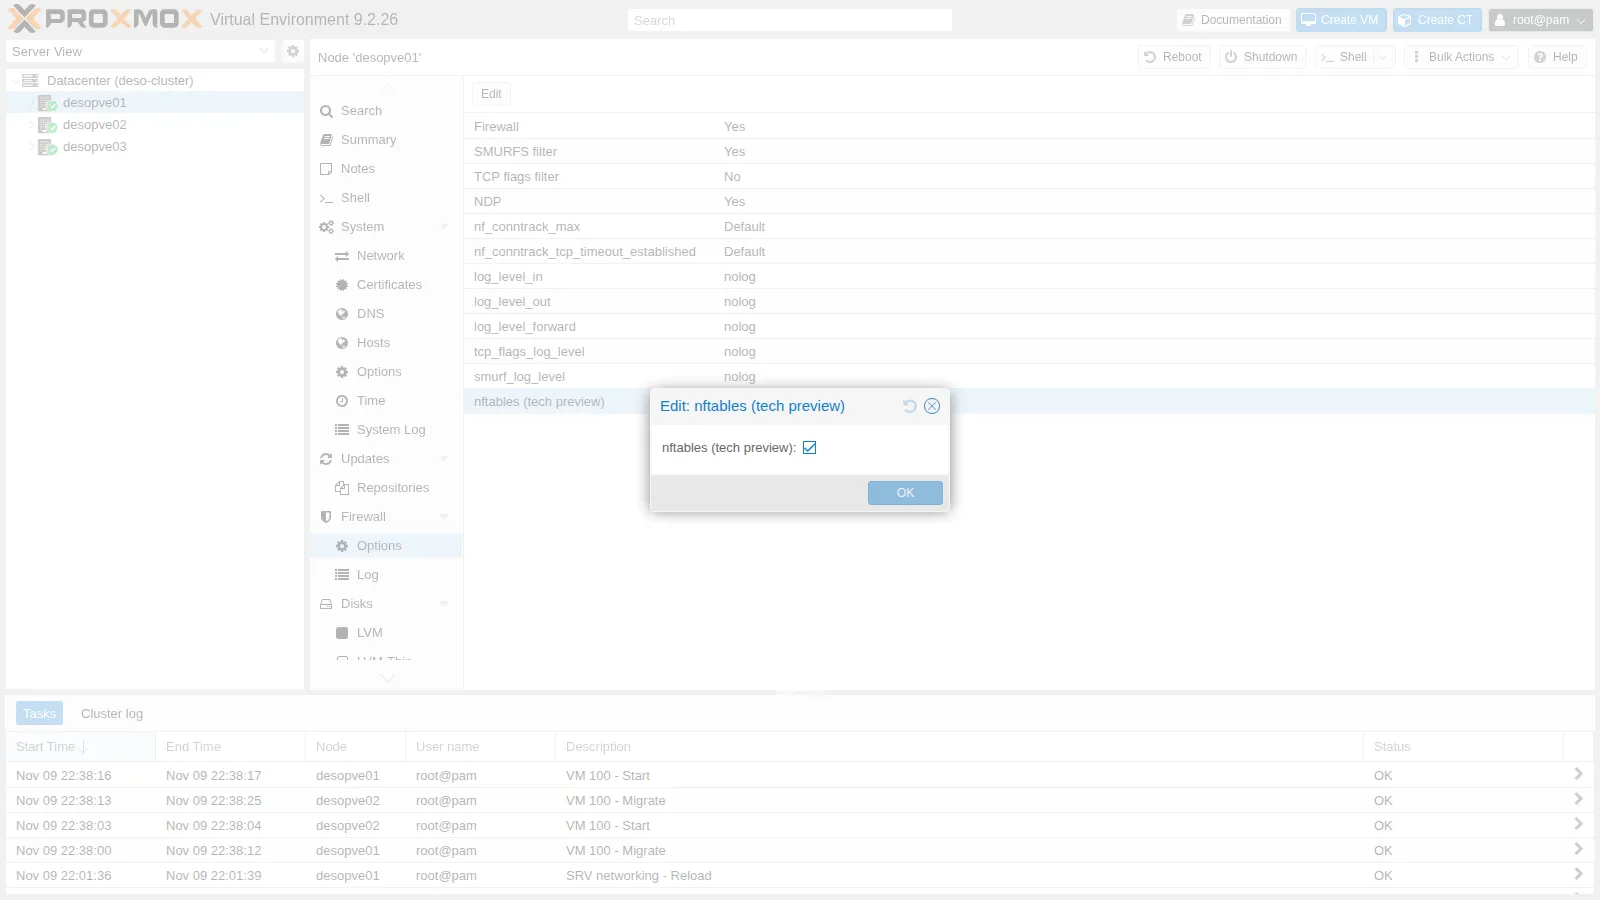
In questo lab il passaggio si fa da riga di comando, un nodo alla volta, con lo script fwenable.sh. Si copia sul nodo e si lancia come root, per esempio dal DC:
scp fwenable.sh root@desopve03.proxmox.community:ssh root@desopve03.proxmox.community ./fwenable.shLo script:
- programma il rientro automatico con
systemd-run: dopo 4 minuti fermaproxmox-firewall, cancella le sue tabelle e solo alla fine prova a disattivare il firewall nella configurazione; - attiva insieme firewall e nftables e avvia
proxmox-firewall; - dopo 25 secondi controlla tutti i servizi: firewall, quorum, Corosync, Ceph, BGP, fabric e multipath.
Il rientro lavora in locale per un motivo preciso. Se l’attivazione taglia Corosync e il nodo perde il quorum, /etc/pve diventa di sola lettura e pvesh set fallisce. Fermando prima il servizio e cancellando le tabelle, il nodo torna comunque raggiungibile, e proxmox-firewall fermo non ricrea le regole al ciclo successivo:
systemd-run --unit=fw-dms --on-active=240 /bin/sh -c "\ systemctl stop proxmox-firewall; \ nft delete table inet proxmox-firewall; \ nft delete table bridge proxmox-firewall-guests; \ pvesh set /nodes/$N/firewall/options --enable 0 --nftables 0 || true"Il rientro è stato provato su desopve03 con un ritardo di 15 secondi al posto di 240. Dopo lo scatto il nodo non ha più tabelle del firewall, il servizio è fermo e le opzioni sono tornate a No:
nft list tables | grep -c proxmoxsystemctl is-active proxmox-firewallpvesh get /nodes/desopve03/firewall/options --output-format json0inactive{"digest":"e6af7727c9dfe3d89839c54416cd1ca62764752f","enable":0,"nftables":0}Per riaccendere il firewall dopo un rientro servono entrambi i comandi:
pvesh set /nodes/desopve03/firewall/options --enable 1 --nftables 1systemctl start proxmox-firewallIl primo nodo è desopve03:
attivato: 22:34:24== desopve03: 22:34:50Status: enabled/running (pending changes)table inet proxmox-firewallQuorate: Yes4 health: HEALTH_OK osd: 7 osds: 7 up (since 4h), 7 in (since 4h)desopve01(10.61.10.21) FRRouting/10.6.1 3desopve02(10.61.10.22) FRRouting/10.6.1 322Corosync ha 4 collegamenti connected (2 per ogni altro nodo), Ceph è sano con tutti gli OSD, le due sessioni BGP sono su, i 2 vicini OpenFabric e i 2 percorsi iSCSI sono attivi. Le prove dei guest sulle zone che attraversano desopve03:
# CT 292 (vxz, su desopve03) → CT 291 (vxz, su desopve01)2 packets transmitted, 2 received, 0% packet loss, time 1001ms# CT 302 (evpnz) → il suo gateway anycast2 packets transmitted, 2 received, 0% packet loss, time 1051ms# CT 302 → CT 301 (altra VNet, altro nodo) e → DC tramite l'exit node5 packets transmitted, 5 received, 0% packet loss, time 4062ms3 packets transmitted, 3 received, 0% packet loss, time 2003msTutto in ordine, quindi si disinnesca il rientro automatico:
systemctl stop fw-dms.timerPoi tocca a desopve02, che ospita il CT 101, i CT della zona simple1 e il server DHCP di dnsmasq. Oltre ai servizi di cluster, che risultano tutti in ordine come su desopve03, si verificano il rinnovo DHCP del CT 271 e le regole del CT 101, che ora sono in nftables. Su desopve02:
nft list tablespct exec 271 -- dhclient -v eth0 2>&1 | grep -E "DHCPACK|bound"pct exec 271 -- ping -c2 10.60.60.1 | grep transmittede dal DC lo script del Lab 32, .\fwtest.ps1:
table inet proxmox-firewalltable bridge proxmox-firewall-guestsDHCPACK of 10.60.60.100 from 10.60.60.1bound to 10.60.60.100 -- renewal in 2147483648 seconds.2 packets transmitted, 2 received, 0% packet loss, time 1021msDC 172.27.199.20 (admin) HTTP ok SSH ok ping okCT 121 VLAN 10 (via router01, NAT) HTTP ok SSH BLOCCATO ping BLOCCATOCT 403 10.99.99.2 (rete instradata) HTTP BLOCCATO SSH BLOCCATO ping BLOCCATOLa matrice del CT 101 è identica a quella del Lab 32: cambiare motore non ha cambiato il comportamento. Ultimo nodo, desopve01, poi la migrazione a caldo della VM 100 avanti e indietro, che usa la VLAN 100: qm migrate 100 desopve02 --online su desopve01 e, per il ritorno, qm migrate 100 desopve01 --online su desopve02:
2026-11-09 22:38:01 use dedicated network address for sending migration traffic (10.100.10.22)2026-11-09 22:38:02 starting migration of VM 100 to node 'desopve02' (10.100.10.22)2026-11-09 22:38:08 migration status: completed2026-11-09 22:38:12 migration finished successfully (duration 00:00:11)2026-11-09 22:38:25 migration finished successfully (duration 00:00:11)E l’accesso di gestione dal DC in IPv6:
foreach ($h in 'fd27:199::21', 'fd27:199::22', 'fd27:199::23') { "$h ssh/22 -> " + (Test-NetConnection $h -Port 22 -InformationLevel Quiet)}'desopve02 (per nome) 8006 -> ' + (Test-NetConnection desopve02.proxmox.community -Port 8006 -InformationLevel Quiet)fd27:199::21 ssh/22 -> Truefd27:199::22 ssh/22 -> Truefd27:199::23 ssh/22 -> Truedesopve02 (per nome) 8006 -> True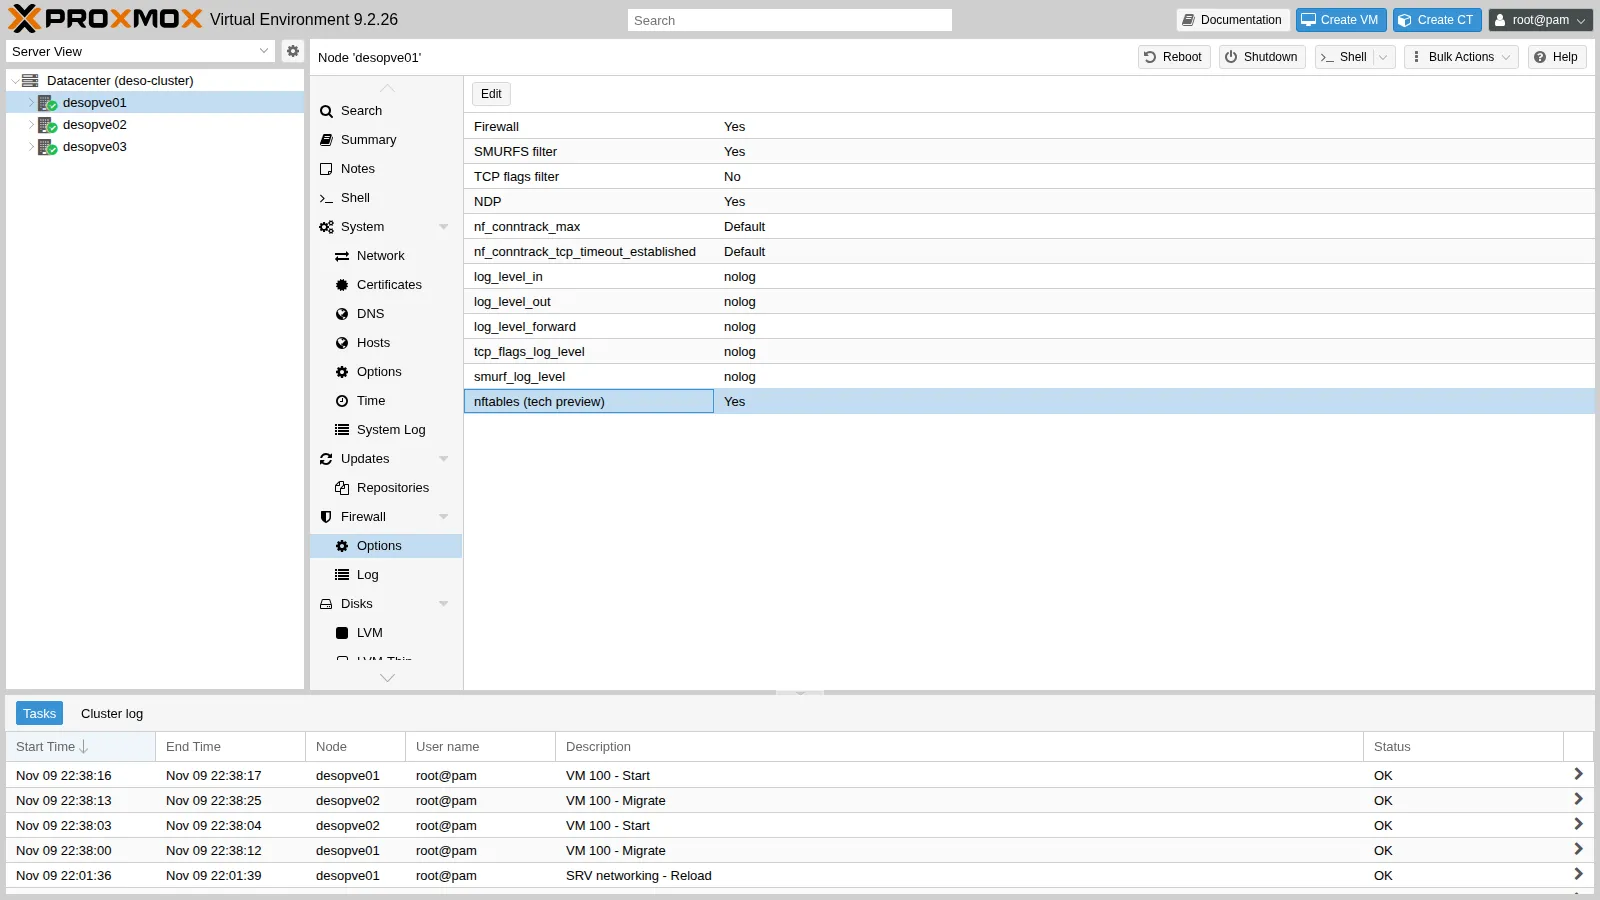
3. Cosa resta fuori
Sezione intitolata “3. Cosa resta fuori”Il firewall dell’host serve a bloccare qualcosa: un servizio nuovo che nessuna regola prevede. Per la prova si avvia un server web temporaneo sulla porta 8080 di desopve01 e si accende il log dell’host:
# su desopve01pvesh set /nodes/desopve01/firewall/options --log_level_in infopython3 -m http.server 8080 &Le prove arrivano da tre direzioni: da desopve02 sulla rete di gestione e sulla rete di migrazione, e dal CT 403 della rete instradata:
# su desopve02echo "== da desopve02 sulla rete di gestione verso 172.27.199.21:8080"nc -zw3 172.27.199.21 8080 && echo ok || echo BLOCCATOecho "== da desopve02 sulla rete di migrazione verso 10.100.10.21:8080"nc -zw3 10.100.10.21 8080 && echo ok || echo BLOCCATOnc -zw3 10.100.10.21 22 && echo "ssh sulla rete di migrazione: ok" || echo "ssh sulla rete di migrazione: BLOCCATO"# su desopve04echo "== dal CT 403 verso SSH di desopve01"pct exec 403 -- nc -zw3 172.27.199.21 22 && echo ok || echo BLOCCATO== da desopve02 sulla rete di gestione verso 172.27.199.21:8080BLOCCATO== da desopve02 sulla rete di migrazione verso 10.100.10.21:8080BLOCCATOssh sulla rete di migrazione: ok== dal CT 403 verso SSH di desopve01BLOCCATONel log dell’host (/var/log/pve-firewall.log di desopve01) c’è una riga per ogni tentativo. Qui una per sorgente, con il campo MAC abbreviato:
0 6 cluster-in 10/Nov/2026:11:24:30 +0100 DROP: IN=vmbr0 PHYSIN=nic0 MAC=… SRC=172.27.199.22 DST=172.27.199.21 LEN=60 TOS=0x00 PREC=0x00 TTL=64 ID=45701 DF PROTO=TCP SPT=46276 DPT=8080 SEQ=2350225254 ACK=0 WINDOW=64240 SYN0 6 cluster-in 10/Nov/2026:11:24:31 +0100 DROP: IN=vmbr1.100 MAC=… SRC=10.100.10.22 DST=10.100.10.21 LEN=60 TOS=0x00 PREC=0x00 TTL=64 ID=19649 DF PROTO=TCP SPT=35884 DPT=8080 SEQ=3357649525 ACK=0 WINDOW=64240 SYN0 6 cluster-in 10/Nov/2026:11:24:36 +0100 DROP: IN=vmbr0 PHYSIN=nic0 MAC=… SRC=10.99.99.2 DST=172.27.199.21 LEN=60 TOS=0x00 PREC=0x00 TTL=63 ID=10176 DF PROTO=TCP SPT=49136 DPT=22 SEQ=3228452114 ACK=0 WINDOW=64240 SYNSulla rete di migrazione passa solo ciò che serve alla migrazione (SSH); la porta 8080 no, nemmeno dalla gestione. Finita la prova si ferma il server e il log dell’host torna a nolog:
kill %1pvesh set /nodes/desopve01/firewall/options --delete log_level_in4. Il ruleset nftables
Sezione intitolata “4. Il ruleset nftables”Il security group diventa una catena della tabella inet proxmox-firewall:
nft list chain inet proxmox-firewall group-servizi-cluster-intable inet proxmox-firewall { chain group-servizi-cluster-in { udp dport 53 ip saddr @v4-dc/reti-sdn ip saddr != @v4-dc/reti-sdn-nomatch accept udp dport 53 ip6 saddr @v6-dc/reti-sdn ip6 saddr != @v6-dc/reti-sdn-nomatch accept tcp dport 53 ip saddr @v4-dc/reti-sdn ip saddr != @v4-dc/reti-sdn-nomatch accept tcp dport 53 ip6 saddr @v6-dc/reti-sdn ip6 saddr != @v6-dc/reti-sdn-nomatch accept icmp type echo-request ip saddr @v4-dc/reti-sdn ip saddr != @v4-dc/reti-sdn-nomatch accept icmpv6 type echo-request ip6 saddr @v6-dc/reti-sdn ip6 saddr != @v6-dc/reti-sdn-nomatch accept icmp type echo-request ip saddr @v4-dc/management ip saddr != @v4-dc/management-nomatch accept icmpv6 type echo-request ip6 saddr @v6-dc/management ip6 saddr != @v6-dc/management-nomatch accept tcp dport 60000-60050 ip saddr 10.100.10.0/24 accept tcp dport 22 ip saddr 10.100.10.0/24 accept udp dport 4789 ip saddr 10.80.80.0/24 accept udp dport 4789 ip saddr 10.61.10.0/24 accept udp dport 3784-3785 ip saddr 10.61.10.0/24 accept tcp dport 179 ip saddr 10.61.10.0/24 accept tcp dport 6789 ip saddr 10.51.10.0/24 accept tcp dport 3300 ip saddr 10.51.10.0/24 accept tcp dport 6800-7300 ip saddr 10.51.10.0/24 accept tcp dport 6789 ip saddr 10.50.10.0/24 accept tcp dport 3300 ip saddr 10.50.10.0/24 accept tcp dport 6800-7300 ip saddr 10.50.10.0/24 accept udp dport 5405-5412 ip saddr 10.40.10.0/24 accept }}Le macro si espandono nelle singole porte (Ceph diventa tre regole), gli alias diventano indirizzi e gli IPSet diventano set nftables (@v4-dc/management), con un set -nomatch per le eccezioni.
5. Anti-spoofing sul CT 101
Sezione intitolata “5. Anti-spoofing sul CT 101”CT 101 → Firewall → Options, doppio clic su IP filter, spunta e OK.
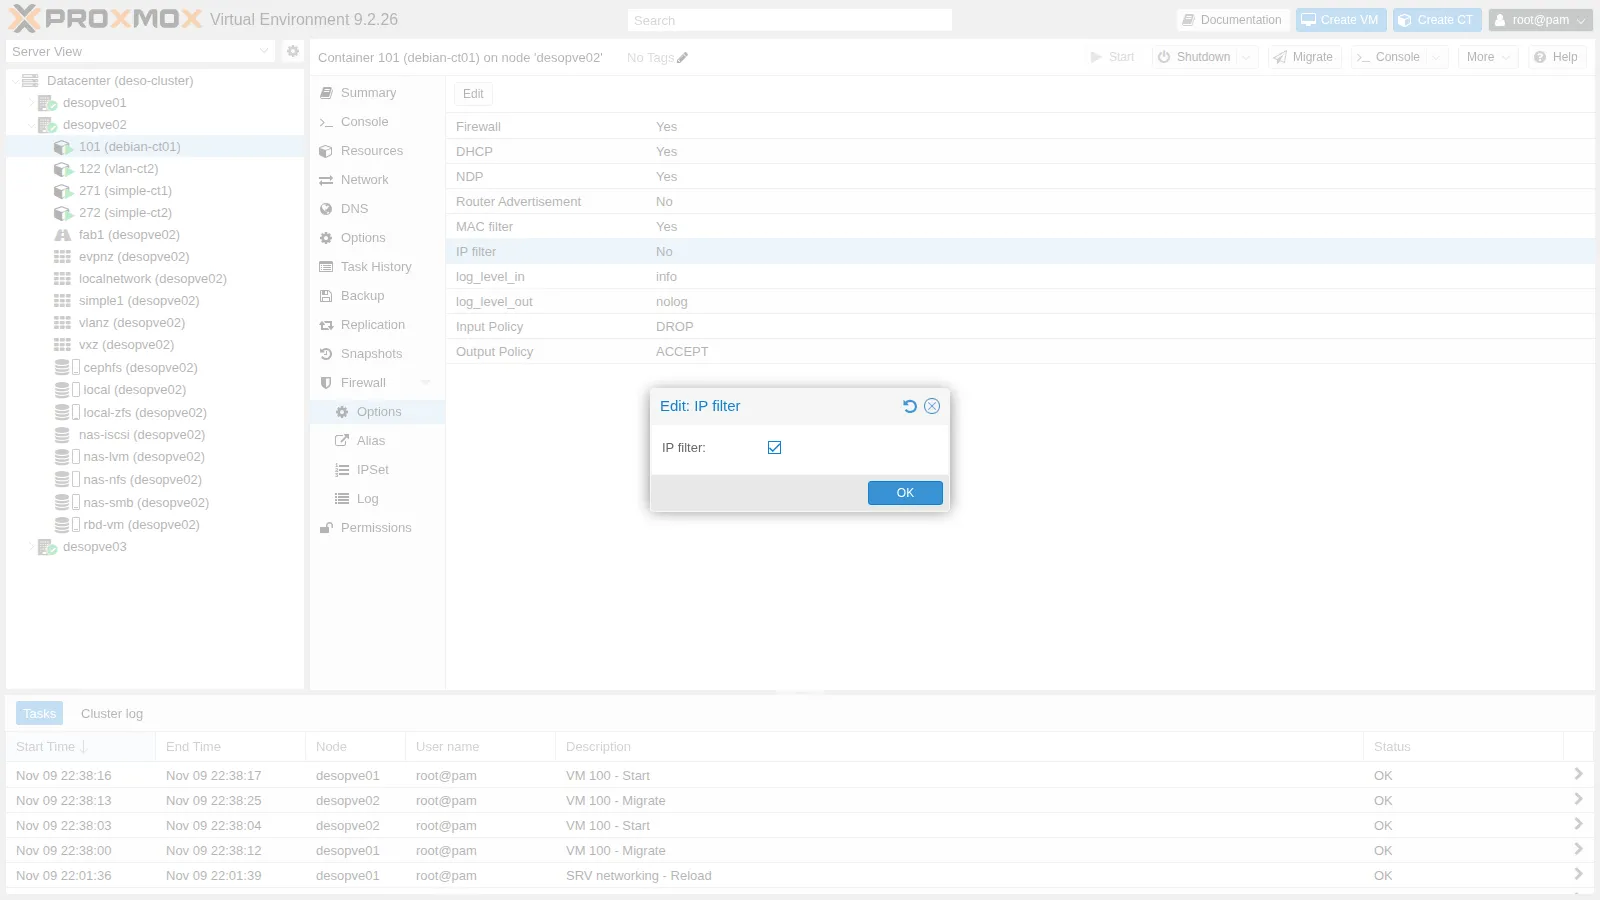
Il set ipfilter-net0 non è stato creato a mano, quindi Proxmox VE lo genera dalla configurazione della scheda:
  set v4-guest-101/ipfilter-net0 {    type ipv4_addr    flags interval    auto-merge    elements = { 172.27.199.101 }  }
  set v6-guest-101/ipfilter-net0 {    type ipv6_addr    flags interval    auto-merge    elements = { fe80::be24:11ff:fe0c:3184 }  }
E le regole in uscita del guest:
chain guest-101-out { jump pre-vm-out iifname "veth101i0" ip saddr != @v4-guest-101/ipfilter-net0 drop iifname "veth101i0" ip saddr @v4-guest-101/ipfilter-net0-nomatch drop iifname "veth101i0" ip6 saddr != @v6-guest-101/ipfilter-net0 drop iifname "veth101i0" ip6 saddr @v6-guest-101/ipfilter-net0-nomatch drop iifname "veth101i0" arp saddr ip != @v4-guest-101/ipfilter-net0 drop iifname . ether saddr != { "veth101i0" . bc:24:11:0c:31:84 } drop iifname . arp saddr ether != { "veth101i0" . bc:24:11:0c:31:84 } dropLe ultime due righe sono il filtro MAC, anche per le risposte ARP. Le prove, dall’interno del CT 101, dove l’utente root del container può cambiare indirizzi a piacere:
pct exec 101 -- bash -c ' ip addr add 172.27.199.199/24 dev eth0 ping -c2 -W2 172.27.199.20 # dal suo indirizzo .101 ping -c2 -W2 -I 172.27.199.199 172.27.199.20 # con un indirizzo non suo ip addr del 172.27.199.199/24 dev eth0'-- ping dal suo indirizzo (.101):2 packets transmitted, 2 received, 0% packet loss, time 1024ms-- ping con sorgente falsa (.199):2 packets transmitted, 0 received, 100% packet loss, time 1020mspct exec 101 -- bash -c ' M=$(cat /sys/class/net/eth0/address) ip link set eth0 address 02:11:22:33:44:55; ip neigh flush dev eth0 ping -c2 -W2 172.27.199.20 ip link set eth0 address $M; ip neigh flush dev eth0 ping -c2 -W2 172.27.199.20'-- MAC cambiato in 02:11:22:33:44:55:2 packets transmitted, 0 received, 100% packet loss, time 1028ms-- MAC originale bc:24:11:0c:31:84:2 packets transmitted, 2 received, 0% packet loss, time 1002ms6. Il firewall della VNet vnsimp1
Sezione intitolata “6. Il firewall della VNet vnsimp1”Datacenter → SDN → VNet Firewall, si sceglie vnsimp1. Nella scheda Options:
Firewall:Yes;Forward Policy:DROP;log_level_forward:info.
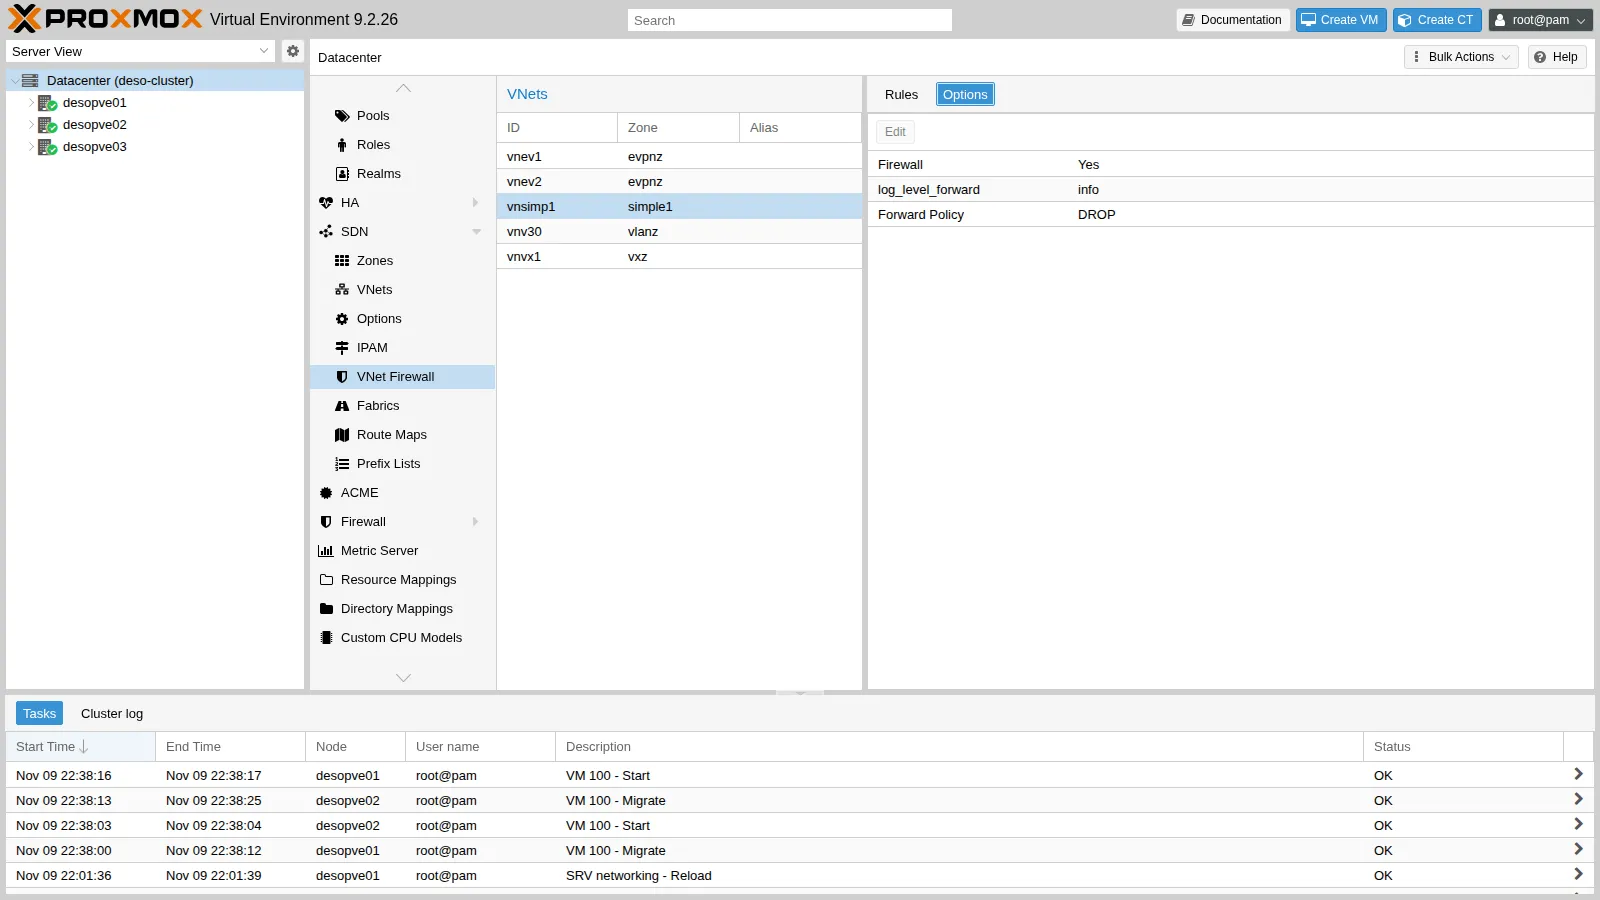
Con la sola regola “Ping tra i guest della VNet”, le prove dal CT 271 mostrano subito un effetto collaterale: il ping verso il gateway passa, ma DNS e DHCP del nodo no. Il log:
0 6 bridge-vnsimp1 09/Nov/2026:22:47:33 +0100 DROP: IN=vnsimp1 PHYSIN=veth271i0 MAC=… SRC=10.60.60.100 DST=10.60.60.1 LEN=76 TOS=0x00 PREC=0x00 TTL=64 ID=1033 DF PROTO=UDP SPT=56538 DPT=53 LEN=560 6 bridge-vnsimp1 09/Nov/2026:22:48:19 +0100 DROP: OUT=vnsimp1 SRC=10.60.60.1 DST=10.60.60.100 LEN=328 TOS=0x00 PREC=0xC0 TTL=64 ID=58206 PROTO=UDP SPT=67 DPT=68 LEN=308La policy DROP della VNet vale anche per il traffico tra i guest e il nodo, in entrambe le direzioni: la richiesta DNS verso 10.60.60.1 e la risposta DHCP del nodo (OUT=vnsimp1, porta 67 → 68). Servono tre regole in più. Per il DNS si usa il set +sdn/vnsimp1-gateway, che Proxmox VE genera da solo per ogni VNet.
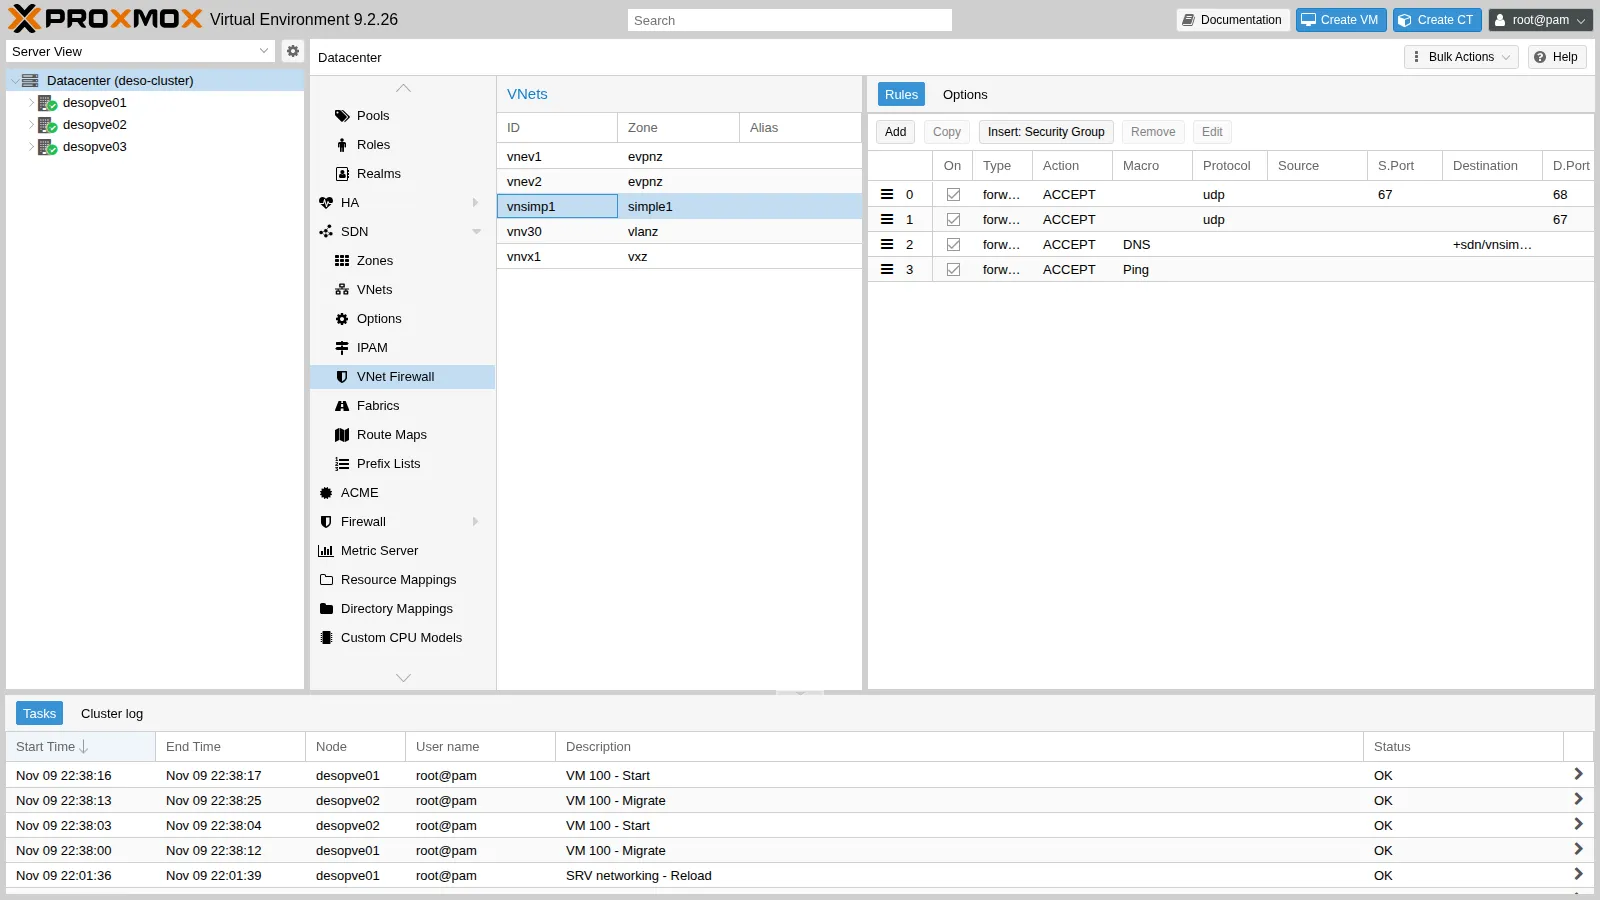
V=/cluster/sdn/vnets/vnsimp1/firewallpvesh create $V/rules --type forward --action ACCEPT --macro Ping --enable 1 \ --comment "Ping tra i guest della VNet"pvesh create $V/rules --type forward --action ACCEPT --macro DNS --dest +sdn/vnsimp1-gateway \ --enable 1 --comment "DNS verso il gateway (dnsmasq)"pvesh create $V/rules --type forward --action ACCEPT --proto udp --dport 67 --enable 1 \ --comment "DHCP verso dnsmasq"pvesh create $V/rules --type forward --action ACCEPT --proto udp --sport 67 --dport 68 --enable 1 \ --comment "Risposte DHCP di dnsmasq"pvesh set $V/options --enable 1 --policy_forward DROP --log_level_forward infocat /etc/pve/sdn/firewall/vnsimp1.fw[OPTIONS]
log_level_forward: infoenable: 1policy_forward: DROP
[RULES]
FORWARD ACCEPT -p udp -dport 68 -sport 67 # Risposte DHCP di dnsmasqFORWARD ACCEPT -p udp -dport 67 # DHCP verso dnsmasqFORWARD DNS(ACCEPT) -dest +sdn/vnsimp1-gateway # DNS verso il gateway (dnsmasq)FORWARD Ping(ACCEPT) # Ping tra i guest della VNetLe prove dal CT 271, con un servizio di prova in ascolto sulla porta 9000 del CT 272:
DHCPACK of 10.60.60.100 from 10.60.60.1bound to 10.60.60.100 -- renewal in 2147483648 seconds.2 packets transmitted, 2 received, 0% packet loss, time 1008mstcp9000-BLOCCATOfd27:199::20 desopve-dc01.proxmox.communityNell’ordine:
- il rinnovo DHCP funziona;
- il ping dal CT 271 al CT 272 passa;
- il TCP verso la porta 9000 del CT 272 è bloccato dalla policy;
- il DNS tramite il gateway risponde.
Il traffico instradato fuori dalla VNet, invece, non cambia:
-- instradato fuori dalla VNet:DC tcp/445: okIl motivo è nel ruleset. La mappa che collega la VNet alle sue regole viene usata solo in tre punti: ingresso e uscita del nodo (tabella inet) e inoltro dentro il bridge (tabella bridge), non nella catena forward del routing.
  chain host-bridge-input {    type filter hook input priority filter - 1; policy accept;    iifname vmap @bridge-map  }
  chain host-bridge-output {    type filter hook output priority filter + 1; policy accept;    oifname vmap @bridge-map  }...  chain forward {    type filter hook forward priority 0; policy accept;    meta ibrname . meta obrname vmap @bridge-map  }
L’ultima catena è della tabella bridge: la chiave meta ibrname . meta obrname vale "vnsimp1" . "vnsimp1" solo per il traffico che entra ed esce dallo stesso bridge, cioè tra i guest della VNet.
7. conntrack
Sezione intitolata “7. conntrack”Una connessione SSH dal DC al CT 101, vista sul nodo:
conntrack -L -d 172.27.199.101 | grep "dport=22 "sysctl net.netfilter.nf_conntrack_count net.netfilter.nf_conntrack_max \ net.netfilter.nf_conntrack_tcp_timeout_establishedtcp 6 431994 ESTABLISHED src=172.27.199.20 dst=172.27.199.101 sport=51596 dport=22 src=172.27.199.101 dst=172.27.199.20 sport=22 dport=51596 [ASSURED] mark=101 use=1net.netfilter.nf_conntrack_count = 235net.netfilter.nf_conntrack_max = 262144net.netfilter.nf_conntrack_tcp_timeout_established = 432000Come si legge:
- Stato:
ESTABLISHEDe[ASSURED](traffico visto in entrambe le direzioni). - Le due tuple: andata e ritorno della connessione.
mark=101: il firewall ha marcato la connessione con l’ID del guest.- Timeout: 431994 secondi rimanenti, perché per Proxmox VE una connessione TCP stabilita resta in tabella 5 giorni se inattiva.
nf_conntrack_max e nf_conntrack_tcp_timeout_established si regolano per nodo in Nodo → Firewall → Options: nello screenshot del passo 2 compaiono con il valore Default. Su un nodo con molti guest e molte connessioni brevi, la tabella piena fa scartare connessioni nuove (nf_conntrack: table full, dropping packet nel log del kernel).
Un caso reale: il traffico “a gomito” sullo stesso nodo. Il CT 271 (zona simple1, esce in SNAT con l’indirizzo del nodo 172.27.199.22) prova a raggiungere il web del CT 101, che sta sullo stesso nodo e ha il firewall attivo. HTTP dalla rete di gestione è permesso, eppure:
FW CT101 spento: HTTP okFW CT101 acceso: BLOCCATONel log del firewall non c’è nessun DROP, e con tcpdump sulla scheda del CT 101 non arriva nessun pacchetto. La tabella di conntrack mostra la traduzione fatta ma mai completata:
tcp 6 95 SYN_SENT src=10.60.60.100 dst=172.27.199.101 sport=55280 dport=80 [UNREPLIED] src=172.27.199.101 dst=172.27.199.22 sport=80 dport=55280 mark=0 use=1I contatori di conntrack crescono di 2 a ogni tentativo, cioè il SYN e la sua ritrasmissione:
prima: insert_failed=39 drop=39dopo 1 tentativo: insert_failed=41 drop=41Il pacchetto viene tracciato una prima volta quando il nodo lo instrada e applica la SNAT, e una seconda quando lo consegna al guest attraverso il firewall del bridge. Il secondo inserimento collide con il primo (insert_failed) e conntrack scarta il pacchetto (drop). In quel momento non lo ha cambiato nemmeno nf_conntrack_allow_invalid: 1 sul nodo; l’opzione è stata poi riportata al default.
La spiegazione più probabile sta nella regola che l’SDN aggiunge per la zona Simple (Lab 27). Con il motore iptables il traffico dei guest con firewall passa dai bridge fwbr… e questa regola lo traccia in una zona separata, quindi i due tracciamenti non collidono. Con nftables i bridge fwbr non esistono, la regola non si applica mai e i due tracciamenti finiscono nella stessa zona:
iptables -t raw -S | grep zone | sort -u-A PREROUTING -i fwbr+ -j CT --zone 1Il fenomeno però non è sistematico. Ripetendo la prova in un secondo momento, con la stessa configurazione e sempre con nftables, la connessione è riuscita:
pct exec 271 -- bash -c 'exec 3<>/dev/tcp/172.27.199.101/80; printf "GET / HTTP/1.0\r\n\r\n" >&3; head -1 <&3'HTTP/1.1 200 OKIn pratica:
- il traffico “a gomito” tra un guest in SNAT e un guest con firewall sullo stesso nodo è un caso delicato: può fallire senza lasciare traccia nel log del firewall;
- da un altro nodo, o senza SNAT, lo stesso servizio è raggiungibile, come mostrano le prove dei passi precedenti;
- quando qualcosa “sparisce” senza lasciare traccia nel log del firewall,
conntrack -Sè il primo posto da guardare.
Verifica e test
Sezione intitolata “Verifica e test”| Prova | Atteso | Risultato |
|---|---|---|
Firewall e nftables attivi su desopve01-03 |
tabelle inet proxmox-firewall (+ bridge dove ci sono guest con firewall) |
ok |
Quorum, Corosync su 2 link, Ceph HEALTH_OK, 7 OSD |
invariati dopo ogni nodo | ok |
| BGP, vicini OpenFabric, percorsi iSCSI | invariati | ok |
VXLAN vxz, EVPN tra VNet e verso l’esterno |
ping senza perdite | ok |
DHCP e DNS di dnsmasq nella zona simple1 |
DHCPACK |
ok |
| Migrazione a caldo sulla VLAN 100 | completata, andata e ritorno | ok |
| Gestione via IPv6 dal DC | SSH e GUI raggiungibili | ok |
| Porta 8080 non prevista, SSH da rete non di gestione | bloccate e registrate | ok |
| IP falso e MAC falso dal CT 101 | 100% di perdita; con i valori giusti 0% | ok |
VNet vnsimp1: ping e DHCP/DNS sì, TCP tra guest no |
come atteso dopo le regole | ok |
| Traffico instradato fuori dalla VNet | non filtrato dalle regole della VNet | verificato |
| SNAT verso un guest con firewall sullo stesso nodo | scartato da conntrack (insert_failed) durante le prove, riuscito ripetendo la prova |
verificato |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Nodi
desopve01,desopve02,desopve03:- firewall attivo con nftables;
- regole:
GROUP servizi-clustereIN ACCEPT -i vnsimp1 -p udp -dport 67; - log dell’host
nolog; nessun timer di rientro attivo.
- Datacenter:
- alias
rete-corosync-2,ceph-public,ceph-cluster,underlay-evpn,fabric,rete-migrazione,rete-gestione-v6; - IPSet
management(IPv4 + IPv6) ereti-sdn; - security group
servizi-cluster; - restano alias, IPSet e gruppi del Lab 32.
- alias
- CT 101: come nel Lab 32, più
IP filter: Yes; il suo indirizzo IPv6 preso con SLAAC resta bloccato dall’IP filter. - VNet
vnsimp1: firewall attivo,policy_forward: DROP, loginfo, quattro regole (DHCP ×2, DNS verso il gateway, Ping). desopve04: invariato dal Lab 32, con il motore iptables.- Script:
fwenable.shper l’attivazione con rientro automatico.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Le regole sono le stesse con iptables e con nftables; con nftables il firewall dei guest non usa bridge aggiuntivi ed è disponibile il firewall delle VNet.
- In un cluster vero le regole automatiche dell’host non bastano: ogni rete dedicata (Ceph, Corosync, underlay SDN, migrazione) va prevista prima di accendere il firewall, anche in IPv6.
- Un rientro automatico programmato rende sicura una modifica che potrebbe tagliare fuori l’operatore.
IP filtereMAC filterimpediscono a un guest di presentarsi con indirizzi altrui.- Il firewall di una VNet filtra il traffico tra i guest e verso il nodo, compresi DHCP e DNS del gateway, ma non quello instradato verso altre reti.
- Quando un pacchetto sparisce senza log,
conntrack -Leconntrack -Smostrano se è stato conntrack a scartarlo.