

Lab 49 – Alta disponibilità: risorse HA, affinity rules, CRS dinamico, manutenzione, arm/disarm e failover reale
Dipendenze
Sezione intitolata “Dipendenze”-
Lab precedenti:
- Lab 06: il cluster
deso-clustera 3 nodi con Corosync su due link; - Lab 17: lo storage condiviso
rbd-vm, su cui stanno tutti i dischi delle risorse HA; - Lab 20: il CT 122
vlan-ct2sulla VLAN 10; - Lab 22: la rete di migrazione VLAN 100;
- Lab 40: le VM
web01-web03(104-106) con nginx; - Lab 48: la live migration, che l’HA usa per spostare le risorse.
- Lab 06: il cluster
-
Sistemi:
- nodi
desopve01,desopve02,desopve03; - VM 104
web01, 105web02, 106web03(172.27.199.104-106, nginx sulla porta 80), tutte surbd-vm; - CT 122
vlan-ct2(10.10.10.122 sulla VLAN 10), surbd-vm.
- nodi
-
Misure: dalla rete di gestione, una richiesta HTTP al secondo verso
web03(con un timeout di 1 secondo) e lo stato diha-managerogni 5 s, con due cicli da lasciare aperti in due terminali:Finestra del terminale while :; do printf '%s ' "$(date +%T)"; curl -s -m 1 -o /dev/null -w '%{http_code}\n' http://172.27.199.106/; sleep 1; donewatch -n5 ha-manager statusNegli output del lab le righe
+N sindicano i secondi trascorsi dall’inizio dell’operazione. -
Credenziali:
root@pam→ Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- VM 104-106 e CT 122 sotto HA, con
ha-manager statusche mostra il fencingarmede il watchdog attivo su tutti e tre i nodi. - Le affinity rules di PVE 9 in funzione: una node affinity per
web01, una resource affinity negativa per i web server e una positiva perweb02e il CT 122, sapendo perché la prima combinazione provata viene rifiutata. - Il CRS dinamico con il ribilanciamento automatico attivo, e una migrazione di ribilanciamento ritrovata nel log del CRM.
- Un nodo svuotato con la modalità manutenzione e ripopolato alla fine, dopo aver ridotto la regola che bloccava l’evacuazione.
- L’HA disarmata e riarmata per i lavori sull’intero cluster, con i watchdog rilasciati e poi di nuovo attivi.
- Il guasto di un nodo gestito senza interventi manuali:
web03riavviata su un altro nodo, con i tempi di fencing e recovery letti nel log del master e tenuti separati dall’interruzione del servizio misurata dalla rete.
Come funziona
Sezione intitolata “Come funziona”Due demoni. Su ogni nodo gira il Local Resource Manager (pve-ha-lrm), che avvia, ferma e migra le risorse del proprio nodo. Il Cluster Resource Manager (pve-ha-crm) gira anch’esso su ogni nodo, ma uno solo è il master: decide dove deve stare ogni risorsa. Lo stato condiviso sta in /etc/pve/ha/ (resources.cfg, rules.cfg, manager_status), quindi vale solo finché il cluster ha il quorum.
Self-fencing con il watchdog. Un nodo che ospita risorse HA tiene armato un watchdog: watchdog-mux lo apre e il LRM lo rinnova a ogni ciclo. Se il nodo perde il quorum non può più rinnovarlo, e dopo 60 s il watchdog lo riavvia: si “recinta” da solo. Gli altri nodi aspettano che il suo lock nel filesystem del cluster scada; a quel punto sono sicuri che il nodo non sta più scrivendo sui dischi condivisi, e riavviano altrove le sue risorse (recovery). La documentazione indica in circa 2 minuti il tempo tipico di rilevamento del guasto e di failover. Il watchdog di default è softdog, un watchdog software del kernel; con un watchdog hardware (per esempio ipmi_watchdog) si sceglie il modulo in /etc/default/pve-ha-manager.
Requisiti: almeno 3 voti nel cluster (con un numero pari di nodi si aggiunge un QDevice, pvecm qdevice setup <ip>, che dà un voto in più a uno dei due lati), storage condiviso per le risorse, e reti affidabili per Corosync.
Risorse HA. Ogni VM o CT sotto HA ha uno stato richiesto (started, stopped, disabled, ignored), il numero di tentativi di riavvio sul posto (max_restart) e di spostamento (max_relocate), failback e, novità 9.2, auto-rebalance.
Affinity rules (PVE 9). I vecchi gruppi HA sono stati sostituiti da regole, e all’aggiornamento vengono convertiti automaticamente in regole di node affinity:
- node affinity: le risorse preferiscono (o evitano) certi nodi, con priorità;
strictimpedisce di usarne altri; - resource affinity: le risorse stanno insieme (positive) o separate (negative).
CRS (Cluster Resource Scheduling). Sceglie il nodo per l’avvio e il recovery:
basic: conta solo il numero di risorse per nodo;static: usa CPU e RAM configurate delle risorse;dynamic(novità 9.2): usa anche il consumo reale di CPU e RAM dei nodi.
Con Automatic Rebalance il CRS sposta da solo le risorse quando lo squilibrio tra i nodi supera una soglia (default 30%) per un certo numero di cicli HA (default 3) e lo spostamento lo riduce almeno di un margine (default 10%). Ogni ciclo HA dura circa 10 secondi.
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”I tempi e gli output di questo lab vengono da una prova eseguita il 10 novembre 2026 (ultima verifica: novembre 2026), in questa configurazione:
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04), sui tre nodi del cluster |
| Cluster | deso-cluster, tre nodi con un voto ciascuno; Corosync con il link 0 sulla rete di gestione e il link 1 sulla VLAN 40 (Lab 06, Lab 22) |
| Watchdog | softdog, quello predefinito (passo 1) |
| Storage condiviso | rbd-vm: Ceph 20.2.5 (tentacle), pool replicato size 3 / min_size 2, OSD su tutti e tre i nodi (Lab 17, Lab 18) |
| Migrazioni | rete sulla VLAN 100, tipo secure (Lab 22) |
| Risorse HA | VM 104-106: Debian 13 dal template 9000, 2 GiB di RAM, nginx (Lab 40); CT 122 (Lab 20) |
| CRS | dynamic, con ribilanciamento all’avvio e automatico alle soglie predefinite (passo 4) |
Cosa misura e cosa non misura. I tempi degli eventi HA vengono dal log del master del CRM: l’HA manager lavora a cicli di circa 10 secondi, quindi la loro risoluzione è di quell’ordine. Le righe +N s vengono da un ha-manager status letto ogni 5 secondi. Il controllo del servizio è una richiesta HTTP al secondo, con un timeout di 1 secondo, dalla rete di gestione: dice quando nginx risponde di nuovo, non quando la VM ha finito di avviarsi. Il guasto è stato simulato una sola volta, spegnendo un nodo. La prova quindi non copre il caso di un nodo che resta acceso ma perde la rete, quello in cui interviene il self-fencing con il watchdog, e con una sola ripetizione non mostra quanto variano i tempi.
Procedura
Sezione intitolata “Procedura”1. Watchdog e stato iniziale
Sezione intitolata “1. Watchdog e stato iniziale”Prima di creare risorse HA, il watchdog è caricato ma non armato:
lsmod | grep softdogsystemctl status watchdog-mux --no-pager | head -3grep -i watchdog /etc/default/pve-ha-managerha-manager statussoftdog 12288 2● watchdog-mux.service - Proxmox VE watchdog multiplexer Loaded: loaded (/usr/lib/systemd/system/watchdog-mux.service; static) Active: active (running) since Mon 2026-11-09 14:31:33 CET; 16h ago#WATCHDOG_MODULE=ipmi_watchdogquorum OKfencing standby (CRM watchdog standby)2. Mettere sotto HA VM e container
Sezione intitolata “2. Mettere sotto HA VM e container”-
Datacenter → HA → Resources → Add. Si sceglie la VM 104 e si lasciano i default: un tentativo di riavvio sul posto, uno di spostamento,
FailbackeAuto-Rebalanceattivi, stato richiestostarted.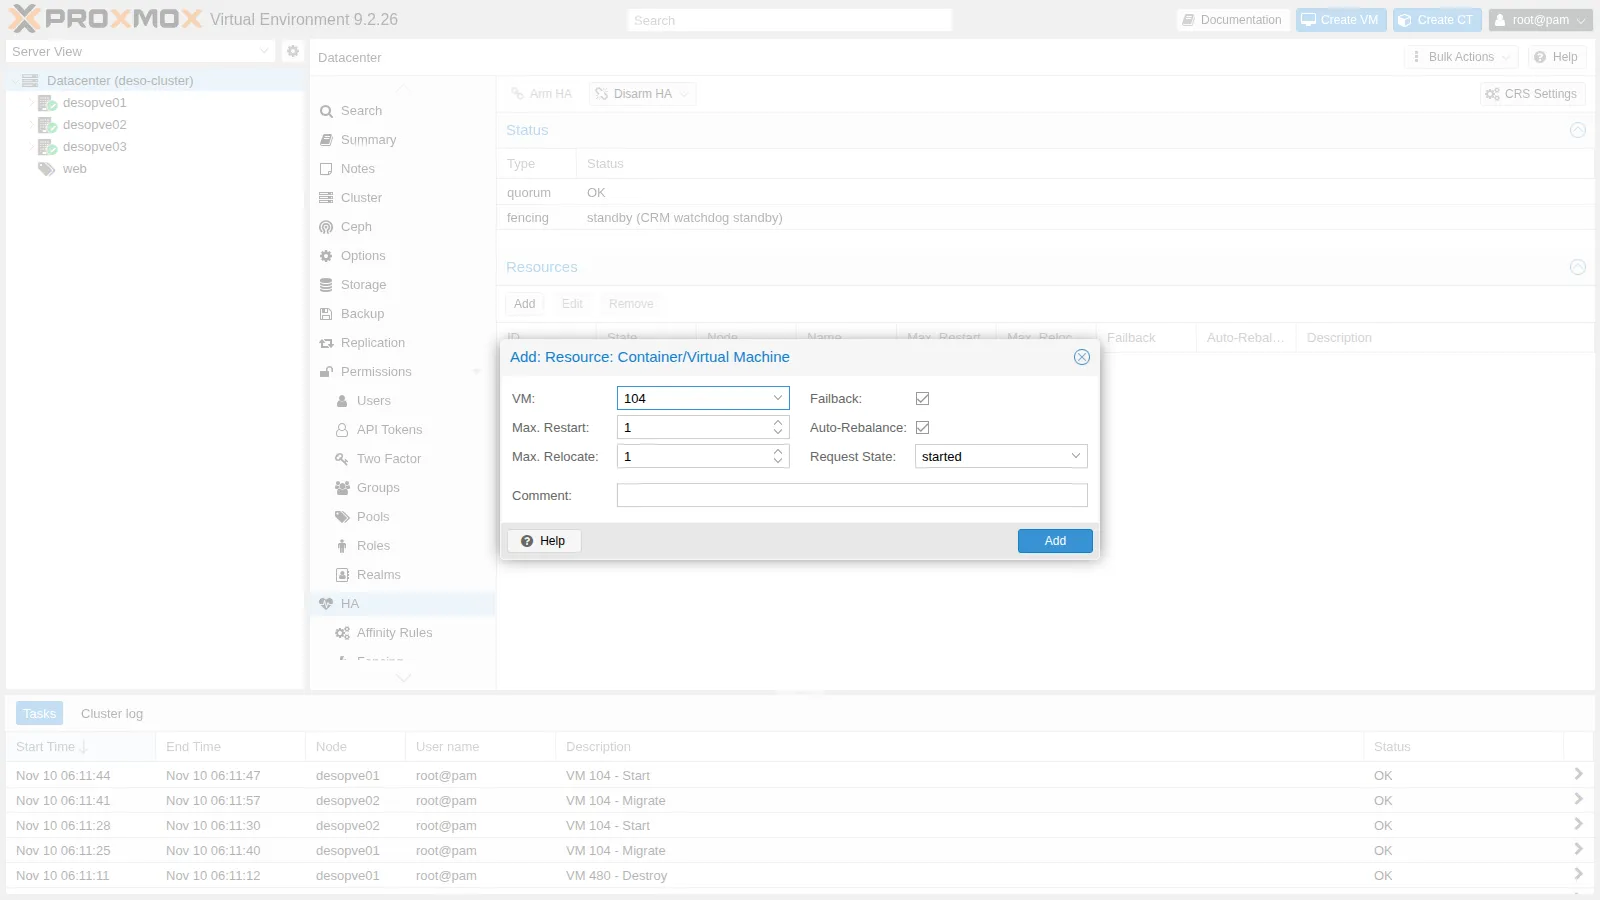
-
Le altre risorse dalla CLI:
Finestra del terminale ha-manager set vm:104 --comment "web01"ha-manager add vm:105 --comment "web02"ha-manager add vm:106 --comment "web03"ha-manager add ct:122 --comment "vlan-ct2, server iperf3" --max_restart 2ha-manager statusOutput quorum OKmaster desopve01 (active, Tue Nov 10 06:18:26 2026)fencing armed (CRM watchdog active)lrm desopve01 (active, watchdog active, Tue Nov 10 06:18:21 2026)lrm desopve02 (active, watchdog active, Tue Nov 10 06:18:29 2026)lrm desopve03 (active, watchdog active, Tue Nov 10 06:18:20 2026)service ct:122 (desopve02, started)service vm:104 (desopve01, started)service vm:105 (desopve02, started)service vm:106 (desopve03, started)Da questo momento il watchdog è armato su tutti e tre i nodi: un nodo che perde il quorum si riavvia da solo.
3. Affinity rules
Sezione intitolata “3. Affinity rules”I gruppi non si possono più creare:
ha-manager groupadd prova --nodes desopve01cannot create group: ha groups have been migrated to rules-
Datacenter → HA → Affinity Rules → HA Node Affinity Rules → Add:
web01preferiscedesopve01(priorità 2) e poidesopve02(priorità 1), regola non strict.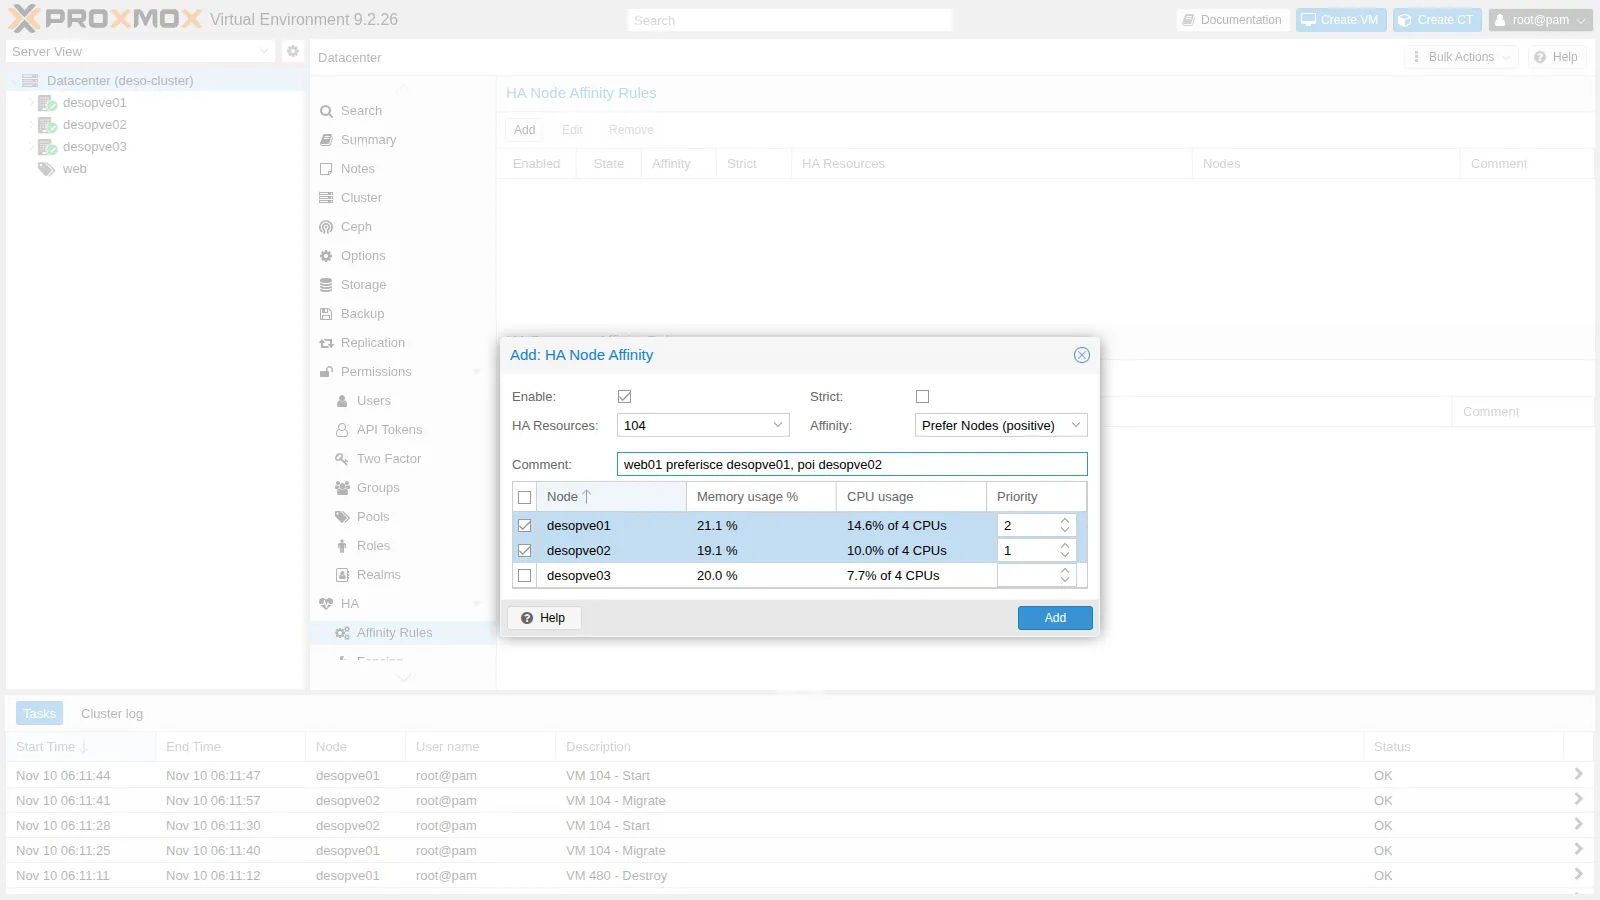
-
HA Resource Affinity Rules → Add: i tre web server devono stare su nodi diversi (Keep Separate).
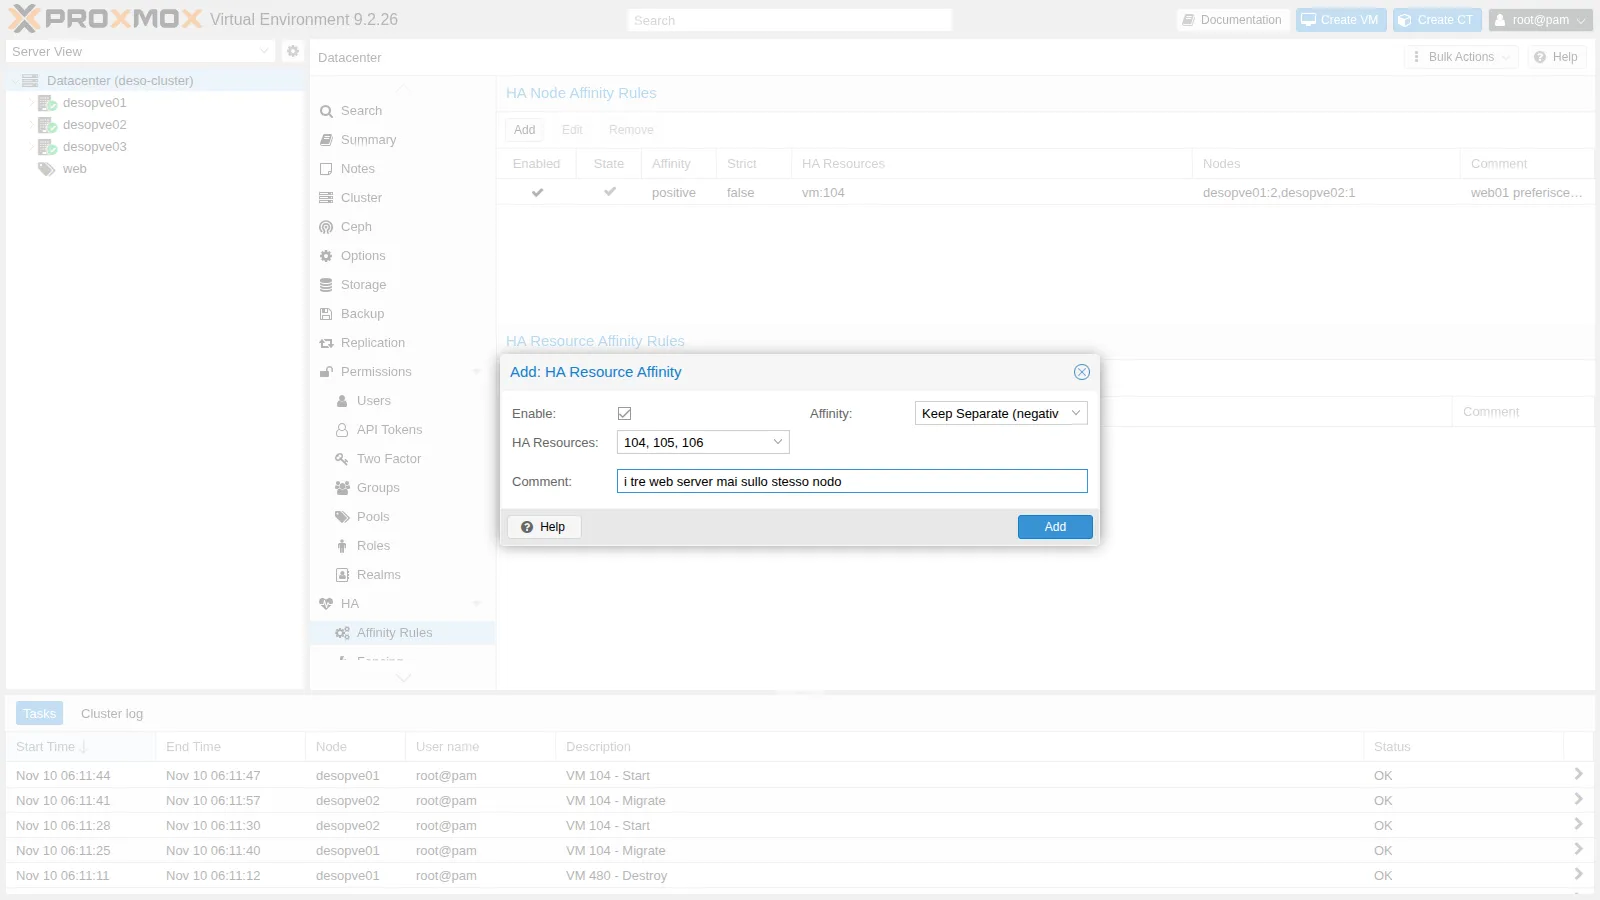
Errore osservato. Il salvataggio fallisce. La stessa regola dalla CLI mostra il motivo:
Finestra del terminale ha-manager rules add resource-affinity web-separati --resources vm:104,vm:105,vm:106 --affinity negativeOutput create ha rule failed: 400 Rule 'web-separati' is invalid.resources: resources are in node affinity rules with multiple prioritiesUna risorsa che sta in una regola di node affinity con più priorità non può stare anche in una regola di resource affinity: è uno dei controlli di fattibilità delle regole HA elencati nella documentazione.
Decisione. Si semplifica la node affinity a un solo livello di priorità e si aggiungono le due regole di resource affinity:
Finestra del terminale # l'ID della regola creata dalla GUI è generato: leggi il tuo con 'ha-manager rules config'ha-manager rules set node-affinity ha-rule-076b9e15-d28b --nodes desopve01 --comment "web01 preferisce desopve01"ha-manager rules add resource-affinity web-separati --resources vm:104,vm:105,vm:106 --affinity negative --comment "i tre web server mai sullo stesso nodo"ha-manager rules add resource-affinity web02-con-ct122 --resources vm:105,ct:122 --affinity positive --comment "web02 e il suo backend sempre insieme"ha-manager rules configOutput ┌─────────┬────────┬───────────────────────┬───────────────────┬──────────────────────┬────────────────────────────────────────┐│ enabled │ state │ rule │ type │ resources │ comment │╞═════════╪════════╪═══════════════════════╪═══════════════════╪══════════════════════╪════════════════════════════════════════╡│ 1 │ in use │ ha-rule-076b9e15-d28b │ node-affinity │ vm:104 │ web01 preferisce desopve01 │├─────────┼────────┼───────────────────────┼───────────────────┼──────────────────────┼────────────────────────────────────────┤│ 1 │ in use │ web02-con-ct122 │ resource-affinity │ ct:122,vm:105 │ web02 e il suo backend sempre insieme │├─────────┼────────┼───────────────────────┼───────────────────┼──────────────────────┼────────────────────────────────────────┤│ 1 │ in use │ web-separati │ resource-affinity │ vm:104,vm:105,vm:106 │ i tre web server mai sullo stesso nodo │└─────────┴────────┴───────────────────────┴───────────────────┴──────────────────────┴────────────────────────────────────────┘Risultato. Le tre regole sono accettate e
in use.
4. CRS dinamico
Sezione intitolata “4. CRS dinamico”Datacenter → HA → CRS Settings: Scheduling Mode Dynamic Load, Rebalance on Start e Automatic Rebalance attivi, soglie di default.
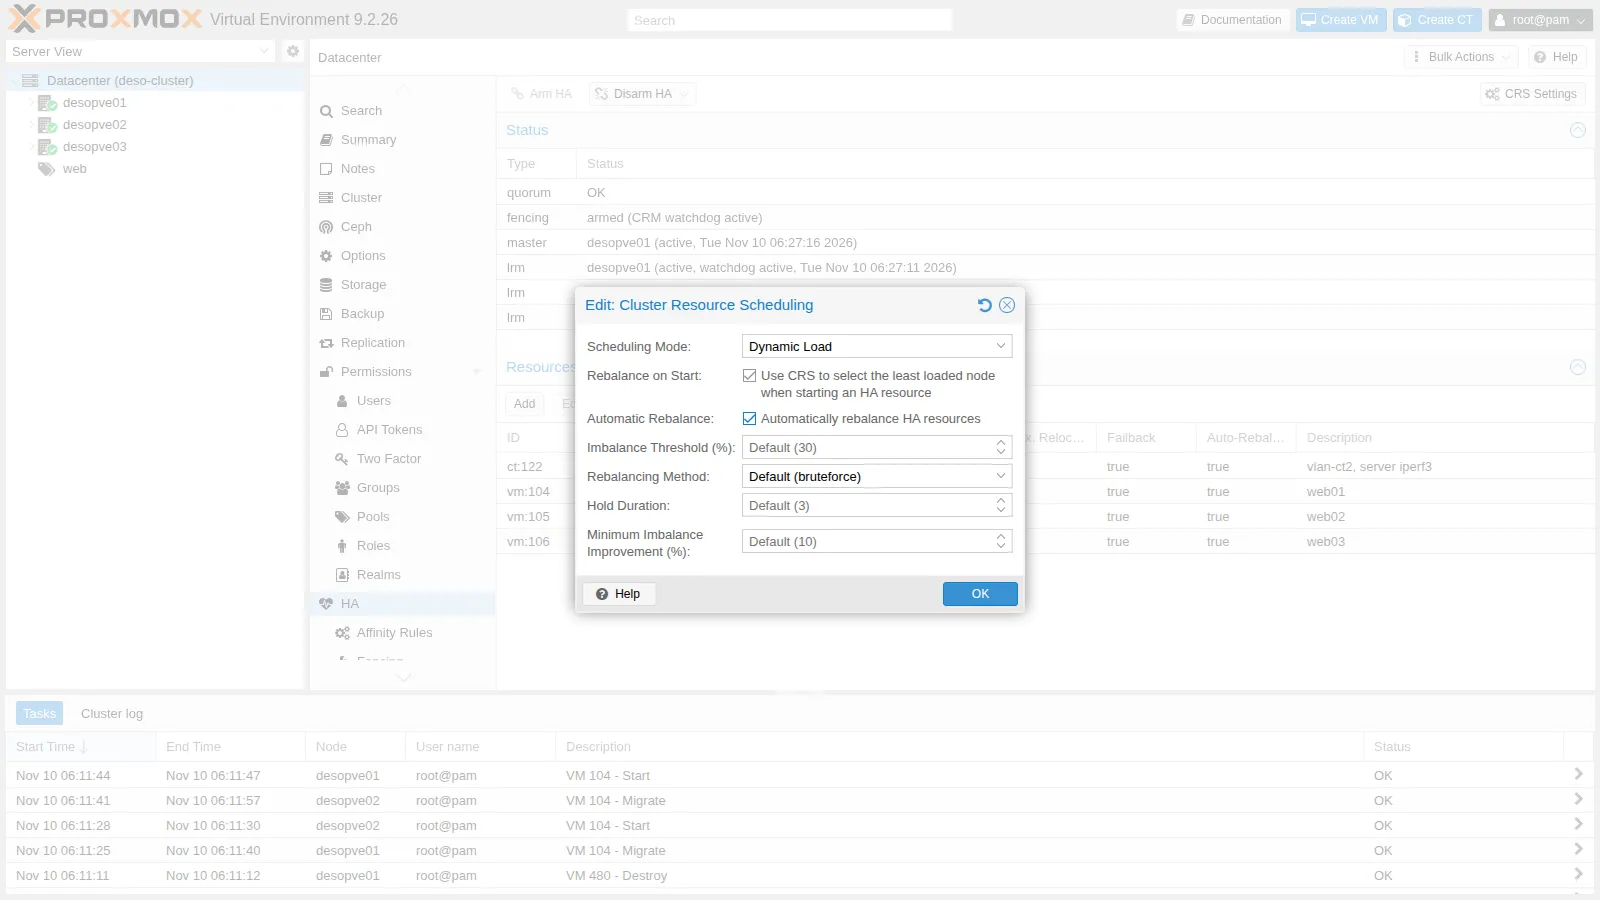
In /etc/pve/datacenter.cfg diventa:
crs: ha-auto-rebalance=1,ha-rebalance-on-start=1,ha=dynamice il master lo annuncia nel log:
pve-ha-crm[1679]: switching scheduler mode from 'basic' to 'dynamic'5. Manutenzione di un nodo (e la trappola dell’anti-affinità)
Sezione intitolata “5. Manutenzione di un nodo (e la trappola dell’anti-affinità)”-
Con la regola
web-separatiancora sui tre web server, si mette in manutenzionedesopve03:Finestra del terminale ha-manager crm-command node-maintenance enable desopve03Output --- +11 slrm desopve03 (maintenance mode, watchdog active, Tue Nov 10 06:27:45 2026)service vm:106 (desopve03, started)...--- +100 slrm desopve03 (maintenance mode, watchdog active, Tue Nov 10 06:29:10 2026)service vm:106 (desopve03, started)Comportamento osservato.
web03non si sposta: dopo 100 secondi è ancorastartedsudesopve03.desopve01ospitaweb01,desopve02ospitaweb02, e la regola vieta di metterla accanto a loro. Il nodo è in manutenzione, ma non si può ancora spegnere.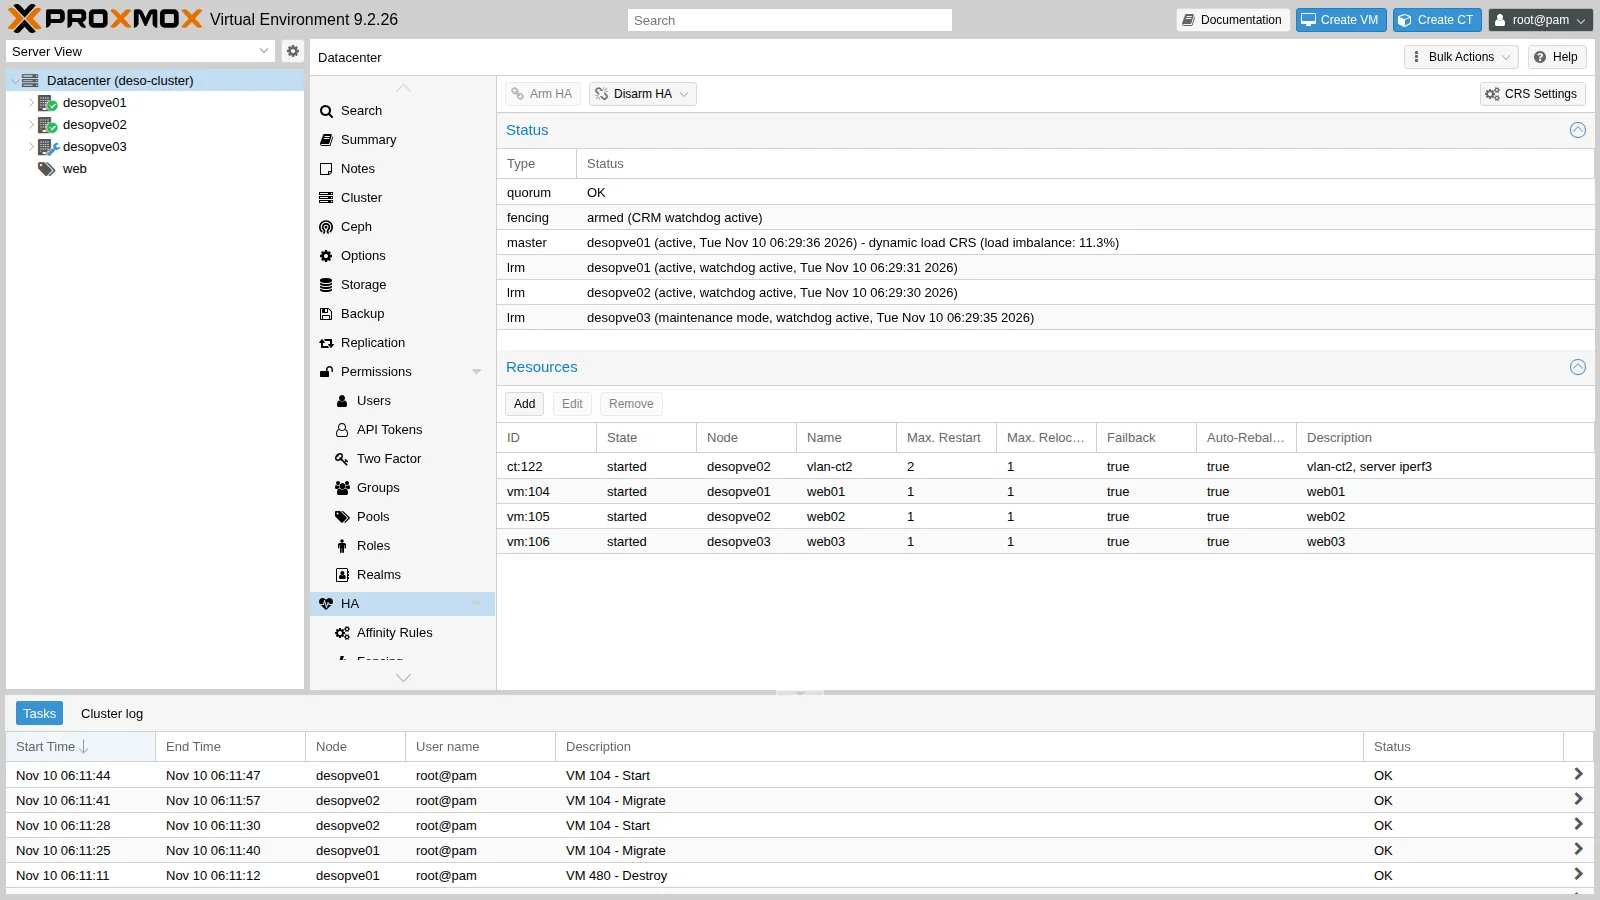
-
Decisione. Si riduce la regola a due VM:
Finestra del terminale ha-manager rules set resource-affinity web-separati --resources vm:104,vm:105Output 06:29:46 pve-ha-crm[1679]: migrate service 'vm:106' to node 'desopve02' (running)06:30:06 pve-ha-crm[1679]: service 'vm:106': state changed from 'migrate' to 'started' (node = desopve02)Risultato.
web03viene evacuata subito: nel log del CRM passano 20 secondi tra l’ordine di migrazione e lo statostartedsudesopve02. È bastato cambiare la regola per sbloccare l’evacuazione. -
Fine della manutenzione: le risorse tornano da sole sul nodo da cui erano partite, qui in 20 secondi secondo il log del CRM.
Finestra del terminale ha-manager crm-command node-maintenance disable desopve03Output 06:30:46 pve-ha-crm[1679]: node 'desopve03': state changed from 'maintenance' => 'online'06:30:46 pve-ha-crm[1679]: moving service 'vm:106' back to 'desopve03', node came back from maintenance.06:31:06 pve-ha-crm[1679]: service 'vm:106': state changed from 'migrate' to 'started' (node = desopve03)
6. Ribilanciamento automatico
Sezione intitolata “6. Ribilanciamento automatico”-
Si crea uno squilibrio. La regola
web-separatiora copre soloweb01eweb02, quindiweb03è libera di muoversi: la si sposta sudesopve01, dove c’è giàweb01, e si caricano le CPU delle due VM:Finestra del terminale ha-manager crm-command migrate vm:106 desopve01for v in 104 106; doqm guest exec $v --timeout 1 -- sh -c 'for i in 1 2; do (timeout 900 sh -c "while :; do :; done") & done; wait'done -
Lo squilibrio misurato dal CRS (
ha-manager status, rigamaster) e la reazione:+13 s imbalance: 30.1% | service vm:106 (desopve01, started)+25 s imbalance: 54.8% | service vm:106 (desopve01, migrate)+50 s imbalance: 36.0% | service vm:106 (desopve03, starting)06:32:47 pve-ha-crm[1679]: auto rebalance - migrate vm:106 to desopve03 (expected change for imbalance from 54.8% to 27.3%)06:32:47 pve-ha-crm[1679]: migrate service 'vm:106' to node 'desopve03'06:33:07 pve-ha-crm[1679]: service 'vm:106': state changed from 'migrate' to 'started' (node = desopve03)Lo squilibrio è rimasto sopra la soglia per alcuni cicli HA (
ha-auto-rebalance-hold-duration, default 3); poi il CRS ha scelto da solo la VM da spostare e il nodo di destinazione. Nel log del CRM la live migration dura 20 secondi.web01è rimasta sudesopve01, il nodo preferito dalla sua regola di affinity.
7. Arm e disarm dell’HA
Sezione intitolata “7. Arm e disarm dell’HA”La manutenzione riguarda un nodo. Per lavori sull’intero cluster (rete di Corosync, aggiornamenti che riavviano i servizi del cluster) si disarma l’HA: i watchdog vengono rilasciati ovunque e nessun nodo si recinta, nemmeno senza quorum.
ha-manager crm-command disarm-ha freezeha-manager statusquorum OKmaster desopve01 (active, Tue Nov 10 06:33:47 2026) - disarmed, resource mode: freeze - dynamic load CRS (load imbalance: 35.9%)fencing disarmed, resource mode: freeze (CRM watchdog released)lrm desopve01 (disarm mode, watchdog released, Tue Nov 10 06:33:46 2026)lrm desopve02 (disarm mode, watchdog released, Tue Nov 10 06:33:50 2026)lrm desopve03 (disarm mode, watchdog released, Tue Nov 10 06:33:49 2026)service ct:122 (desopve02, freeze)service vm:104 (desopve01, freeze)service vm:105 (desopve02, freeze)service vm:106 (desopve03, freeze)pve-ha-lrm[3086]: HA disarm requested, releasing agent lock and watchdogpve-ha-lrm[3086]: watchdog closed (disabled)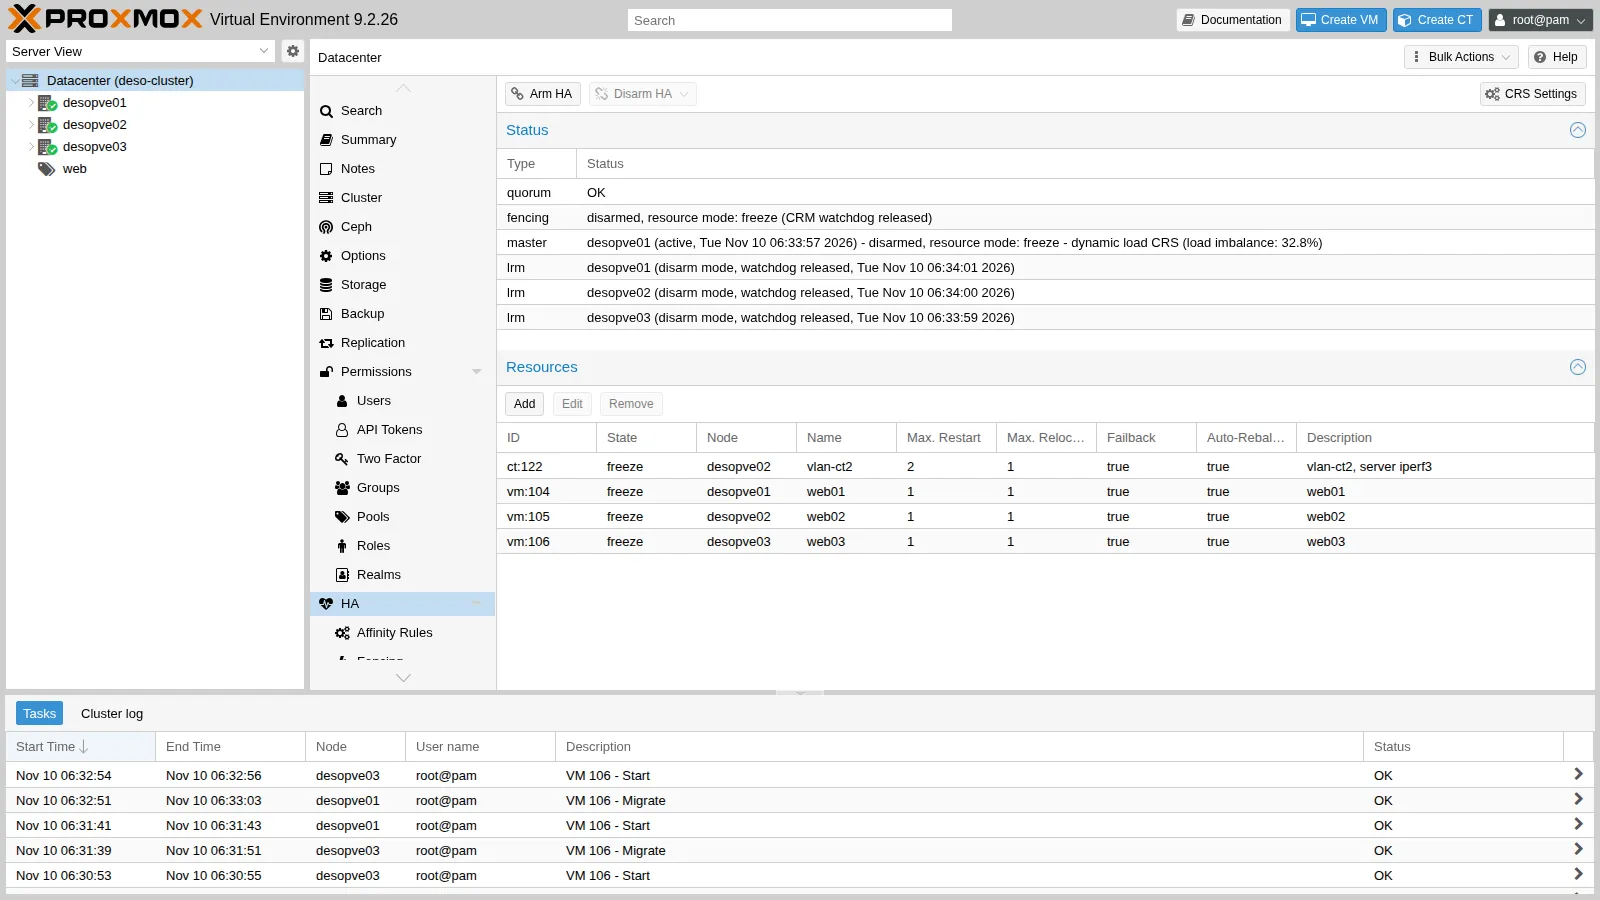
freeze: le risorse restano sotto HA, ma comandi e cambi di stato non vengono applicati fino al riarmo;ignore: le risorse escono dal controllo dell’HA e si gestiscono come VM normali.
Si riarma con un comando (o il pulsante Arm HA):
ha-manager crm-command arm-hafencing armed (CRM watchdog active)lrm desopve01 (active, watchdog active, Tue Nov 10 06:34:51 2026)8. Failover reale: un nodo spento di colpo
Sezione intitolata “8. Failover reale: un nodo spento di colpo”-
web03gira sudesopve03. Dalla rete di gestione parte una richiesta HTTP al secondo verso 172.27.199.106, e sul master si registraha-manager statusogni 5 s. -
Si spegne
desopve03di colpo, come per un guasto di alimentazione:Finestra del terminale echo 1 > /proc/sys/kernel/sysrqecho o > /proc/sysrq-trigger -
Il log del master:
06:35:54 pve-ha-crm[1679]: node 'desopve03': state changed from 'online' => 'unknown'06:36:44 pve-ha-crm[1679]: service 'vm:106': state changed from 'started' to 'fence'06:36:44 pve-ha-crm[1679]: node 'desopve03': state changed from 'unknown' => 'fence'06:36:44 perl[1679]: notified via target `mail-to-root`06:37:44 pve-ha-crm[1679]: successfully acquired lock 'ha_agent_desopve03_lock'06:37:44 pve-ha-crm[1679]: fencing: acknowledged - got agent lock for node 'desopve03'06:37:44 pve-ha-crm[1679]: service 'vm:106': state changed from 'fence' to 'recovery'06:37:44 pve-ha-crm[1679]: recover service 'vm:106' from fenced node 'desopve03' to node 'desopve02'06:37:44 pve-ha-crm[1679]: service 'vm:106': state changed from 'recovery' to 'started' (node = desopve02) -
La sequenza misurata, con la fonte di ogni orario:
Ora Evento Dallo spegnimento Fonte 06:35:36 desopve03spento0 s inizio della prova 06:35:38 prima richiesta HTTP fallita 2 s ciclo HTTP 06:35:54 il master vede il nodo unknown18 s log del CRM 06:36:44 nodo e risorsa in fence, notifica inviata68 s log del CRM 06:37:44 lock del nodo acquisito: fencing confermato, recovery su desopve02128 s log del CRM 06:38:46 nginx di web03risponde di nuovo190 s ciclo HTTP 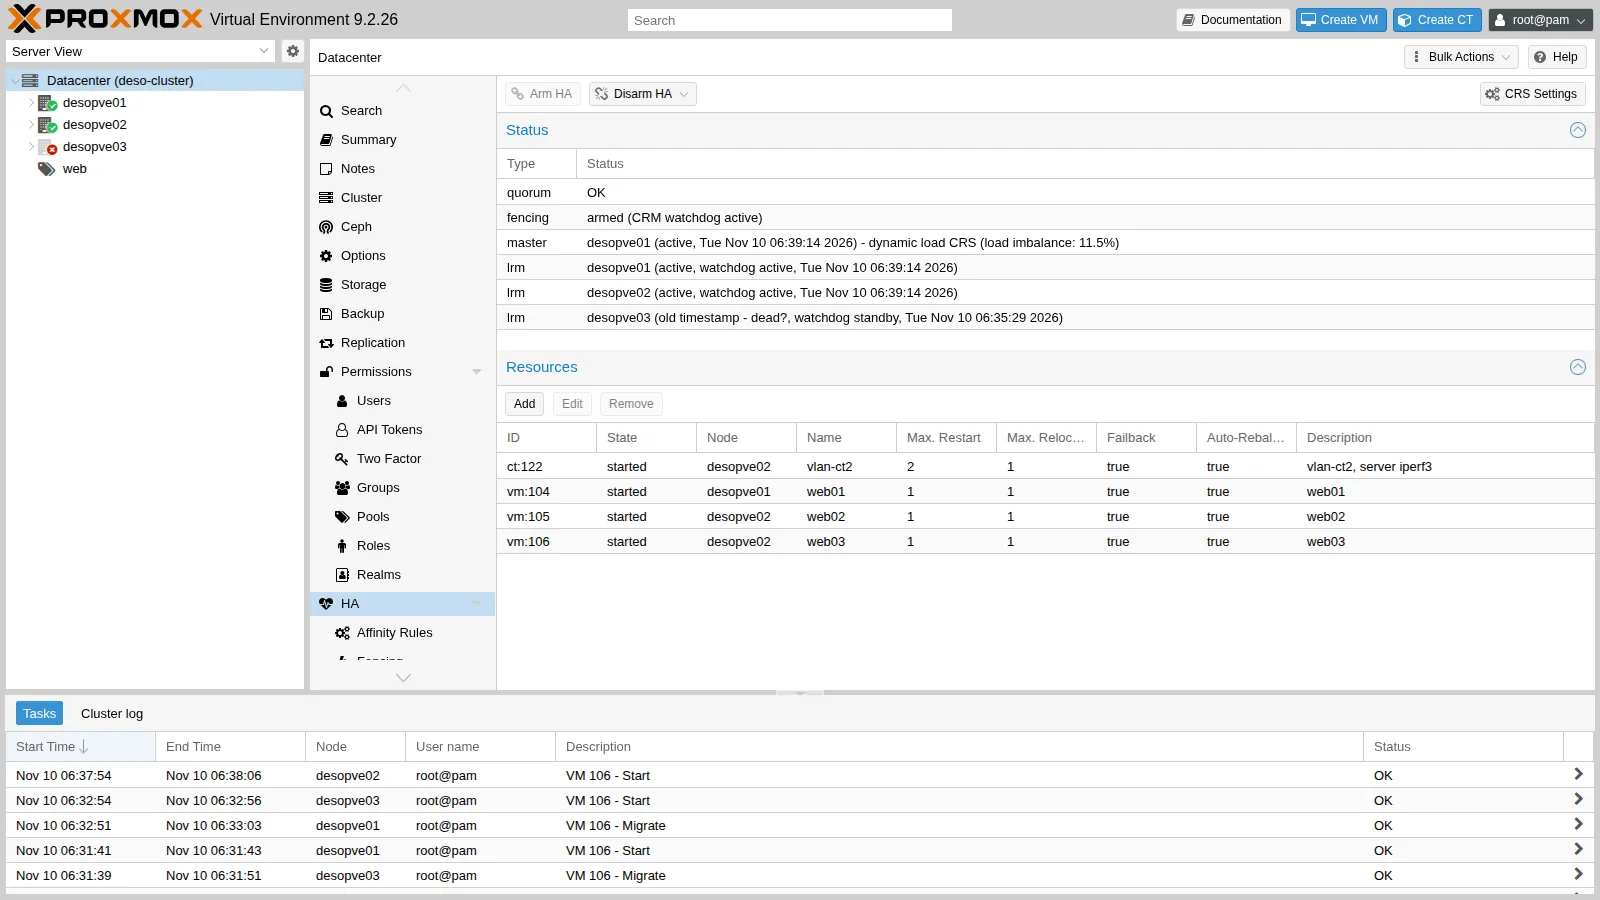
Nella tabella ci sono tre osservazioni diverse, da leggere separatamente:
- Fencing confermato dopo 128 secondi (log del CRM). Questa parte non dipende dalla VM: il CRM può riavviare le risorse del nodo perso solo quando ne acquisisce il lock, e può farlo solo dopo che il lock è scaduto. Il valore è compatibile con i circa 2 minuti di rilevamento e failover che la documentazione indica come tipici. Con una sola prova non si vede quanto vari, e il log ha la risoluzione di un ciclo HA (circa 10 secondi). Per verificarlo ripeti la prova qualche volta e confronta l’ora dello spegnimento con il log del CRM sul master (
journalctl -u pve-ha-crm). - Altri 62 secondi prima che nginx risponda (ciclo HTTP). Sono compatibili con l’avvio della VM su
desopve02e con il boot di Debian fino a nginx, ma la prova non li scompone. Per verificarlo leggi l’ora di avvio della VM nell’elenco dei task didesopve02, guarda l’avvio del guest (systemd-analyze,journalctl -b -u nginx) e affianca al ciclo HTTP unpingverso la VM, per distinguere il momento in cui la rete del guest torna attiva da quello in cui risponde nginx. - Servizio irraggiungibile per circa tre minuti, dalla prima richiesta fallita (06:35:38) alla prima riuscita (06:38:46), con la risoluzione di 1-2 secondi del ciclo HTTP. È quello che vede un client.
L’attesa del lock è il prezzo della sicurezza dei dati: la VM non può mai girare su due nodi nello stesso momento (niente split brain).
- Fencing confermato dopo 128 secondi (log del CRM). Questa parte non dipende dalla VM: il CRM può riavviare le risorse del nodo perso solo quando ne acquisisce il lock, e può farlo solo dopo che il lock è scaduto. Il valore è compatibile con i circa 2 minuti di rilevamento e failover che la documentazione indica come tipici. Con una sola prova non si vede quanto vari, e il log ha la risoluzione di un ciclo HA (circa 10 secondi). Per verificarlo ripeti la prova qualche volta e confronta l’ora dello spegnimento con il log del CRM sul master (
-
Il resto del cluster durante il guasto:
Quorate: YesTotal votes: 2health: HEALTH_WARNDegraded data redundancy: 11601/34803 objects degraded (33.333%), 79 pgs degraded, 97 pgs undersizedosd: 7 osds: 4 up (since 3m), 7 in (since 12h)Quorum con 2 voti su 3 e Ceph degradato ma funzionante (
min_size 2): le VM degli altri nodi hanno continuato a girare, senza essere riavviate. Questa prova non ha misurato il loro I/O su disco: nel Lab 18 uno spegnimento simile di un nodo Ceph ha tenuto in attesa le scritture di una VM per 26,8 secondi. I guest non in HA didesopve03(CT 123, 292, 302) invece sono rimasti spenti: l’HA protegge solo ciò che le si affida.
9. Rientro del nodo e ripristino della distribuzione
Sezione intitolata “9. Rientro del nodo e ripristino della distribuzione”-
Riaccendi
desopve03dal pulsante di accensione o dalla console di gestione remota (IPMI/iDRAC/iLO). Nel lab è stato riacceso alle 06:42:34, e il master lo ha registratoonline30 secondi dopo:06:43:04 pve-ha-crm[1679]: node 'desopve03': state changed from 'unknown' => 'online'06:43:04 pve-ha-crm[1679]: fallback to 'basic' scheduler mode, init for 'dynamic' failed - did not get dynamic node usage information for 'desopve03'Come dice la seconda riga, il CRS ripiega sul modo
basicperché non ha ancora i dati di carico del nodo appena tornato. -
web03resta sudesopve02. È coerente con la configurazione: non ha node affinity che la richiami, e lo squilibrio (13,5%) è sotto la soglia del 30% per il ribilanciamento. I CT non in HA vanno riavviati a mano (non hannoonboot):Finestra del terminale for c in 123 292 302; do pct start $c; doneha-manager crm-command migrate vm:106 desopve03Output +7 s service vm:106 (desopve02, migrate)+38 s service vm:106 (desopve03, starting)+50 s service vm:106 (desopve03, started)Ceph ricostruisce le copie mancanti e torna
HEALTH_OK.
Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se ha-manager status mostra le quattro risorse started con il fencing armed, se le tre regole sono in use e se, dopo lo spegnimento di un nodo, web03 torna a rispondere da un altro nodo senza che nessuno intervenga.
| Prova | Criterio di successo | Risultato nel lab |
|---|---|---|
| Gruppi HA in PVE 9 | creazione rifiutata | ha groups have been migrated to rules |
| Resource affinity su una risorsa con node affinity a più priorità | regola rifiutata, con il motivo | resources are in node affinity rules with multiple priorities |
| Ribilanciamento automatico (CRS dinamico) | una migrazione di ribilanciamento nel log del CRM | squilibrio 54,8% → migrazione di web03, squilibrio previsto 27,3% |
| Manutenzione con Keep Separate su 3 risorse e 3 nodi | la trappola si vede: la risorsa non si può evacuare | web03 ancora sul nodo dopo 100 s |
| Manutenzione con la regola ridotta | evacuazione e rientro automatico | 20 s per ciascuno, nel log del CRM |
Disarm freeze |
watchdog rilasciati su tutti i nodi | watchdog released sui tre LRM, risorse in freeze |
| Nodo spento di colpo | web03 riavviata da sola su un altro nodo |
fencing confermato dopo 128 s (log del CRM); nginx di nuovo raggiungibile dopo 190 s (ciclo HTTP) |
| Guest non in HA sul nodo guasto | non riavviati dall’HA | spenti fino al riavvio manuale |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Risorse HA, tutte
started, HA armata:vm:104sudesopve01,vm:105ect:122sudesopve02,vm:106sudesopve03.
- Regole:
ha-rule-076b9e15-d28b(node affinity):vm:104preferiscedesopve01;web-separati(resource affinity negativa):vm:104,vm:105;web02-con-ct122(resource affinity positiva):vm:105,ct:122.
- Datacenter:
crs: ha-auto-rebalance=1,ha-rebalance-on-start=1,ha=dynamic. - Cluster con quorum 3/3, Ceph
HEALTH_OK, CT 123, 292 e 302 riavviati, guest nelle posizioni iniziali. - Con l’HA attiva un nodo che perde il quorum si riavvia da solo: prima di lavori sulla rete di Corosync si usa
disarm-ha.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Cosa mettere sotto HA, e quanto costa un failover. L’HA riavvia solo le risorse che le affidi, e solo quando il nodo perso è sicuramente recintato: in questo lab il fencing è stato confermato dopo 128 secondi e il servizio ha risposto di nuovo dopo 190. Un servizio che non sopporta minuti di interruzione ha bisogno di ridondanza anche nell’applicazione, non solo dell’HA.
- Come scrivere le regole di posizionamento, che in PVE 9 sostituiscono i gruppi HA. Node affinity per i nodi preferiti, con un solo livello di priorità se la risorsa sta anche in una regola di resource affinity; resource affinity per tenere risorse insieme o separate. Con N nodi, al massimo N-1 risorse separate, altrimenti la manutenzione non riesce a evacuare un nodo.
- Quale strumento per quale manutenzione. La modalità manutenzione per un singolo nodo, che viene svuotato e poi ripopolato;
disarm-haper i lavori sull’intero cluster o sulla rete di Corosync, dove una perdita di quorum farebbe altrimenti recintare i nodi. - Quando lasciare ribilanciare il CRS. Il CRS dinamico con il ribilanciamento automatico sposta le risorse HA in base al carico reale, nel rispetto delle affinity rules, quando lo squilibrio resta sopra la soglia per alcuni cicli.
- Come leggere i tempi di un failover. Tieni separati i tempi del log del CRM (fencing, recovery) da quello che vedono i client (servizio di nuovo raggiungibile), e attribuisci la differenza all’avvio della VM solo dopo averlo verificato.
Riferimenti
Sezione intitolata “Riferimenti”- Proxmox VE – High Availability
- Proxmox VE – HA: fencing e recovery delle risorse del nodo recintato
- Proxmox VE – Regole HA: node affinity, resource affinity e conflitti
- Proxmox VE – HA: manutenzione di un nodo
- Proxmox VE – HA: disarm per la manutenzione del cluster
- Proxmox VE – HA: Cluster Resource Scheduling e bilanciamento del carico
- Proxmox VE – ha-manager(1)
- Proxmox VE – datacenter.cfg, opzione crs
- Proxmox VE – Corosync External Vote Support (QDevice)