

Lab 22 – Reti dedicate: Corosync, migrazione e storage
Dipendenze
Sezione intitolata “Dipendenze”- Lab precedenti:
- VM: la VM 100
debian01con il disco surbd-vm, accesa sudesopve01: serve per misurare la migrazione. - Rete: lo switch del laboratorio trasporta le VLAN sulle porte dei nodi (trunk). Le nuove VLAN 40 e 100 non hanno un router.
- Credenziali:
root/<password-lab>sui nodi → Appendice B.
Obiettivi
Sezione intitolata “Obiettivi”- Il link 1 di Corosync spostato sulla VLAN 40 (10.40.10.0/24, senza router) su tutti e tre i nodi, con il cluster in quorum dopo ogni passo:
corosync-cfgtool -nmostra il link 1 sui nuovi indirizzi. - Le migrazioni a caldo fatte passare dalla VLAN 100 (10.100.10.0/24), con la prova dei contatori di byte delle interfacce.
- Sapere quale link di Corosync porta il traffico del cluster, e cosa continua a funzionare quando cade il link sulla VLAN 40.
- Una tabella delle reti del laboratorio (VLAN, subnet, interfaccia, gateway, uso) per preparare i lab successivi.
Come funziona
Sezione intitolata “Come funziona”Tipi di traffico, esigenze diverse
Sezione intitolata “Tipi di traffico, esigenze diverse”| Traffico | Cosa conta | Cosa succede se soffre |
|---|---|---|
| Corosync (cluster) | latenza bassa e costante, poca banda | se i pacchetti arrivano in ritardo il nodo perde il quorum; con l’alta disponibilità attiva viene isolato e riavviato (fencing) |
| Storage (NFS, iSCSI) | banda e latenza | VM lente, I/O in attesa |
| Ceph public e cluster | banda e latenza; la cluster network porta la replica tra gli OSD | scritture lente, slow ops |
| Migrazione | molta banda, a raffiche | migrazioni lente; se condivide il link con Corosync, può disturbarlo |
| VM | dipende dai servizi | |
| Gestione | poca banda | GUI e SSH irraggiungibili |
Il rischio tipico è una migrazione o un backup che satura il link condiviso con Corosync: i pacchetti del cluster arrivano in ritardo e un nodo sano viene escluso. Per questo la documentazione di Proxmox VE chiede per il cluster una rete con latenze sotto i 5 ms, poco usata da altro traffico, idealmente separata fisicamente, e sconsiglia in particolare di condividerla con lo storage, salvo come link di riserva a bassa priorità.
Corosync con due link
Sezione intitolata “Corosync con due link”Corosync (trasporto knet) tiene sotto controllo tutti i link, ma in modalità passive fa passare il traffico del cluster su uno solo: quello funzionante con la priorità più alta. In questo cluster non è impostata alcuna priorità (nel Lab 06 il log mostra pri: 1 per entrambi i link), quindi vince il link con il numero più basso, il link 0. Nel laboratorio:
- link 0: rete di gestione (
vmbr0), il link che porta il traffico di Corosync; - link 1: finora sulla
172.32.199.0/24dinic1, la stessa rete del secondo percorso iSCSI e instradata dartr-core. In questo lab va su una VLAN dedicata, la 40, senza gateway. Resta il link di riserva, usato solo se cade il link 0.
Per rendere la VLAN 40 il link preferito bisognerebbe darle un knet_link_priority più alto di quello del link 0; questo lab lascia le priorità predefinite. La VLAN 40, inoltre, è dedicata solo a livello di indirizzi: condivide la porta fisica nic1 con il secondo percorso iSCSI.
Interfacce VLAN su una scheda e su un bridge
Sezione intitolata “Interfacce VLAN su una scheda e su un bridge”| Interfaccia | Cosa è | Uso nel lab |
|---|---|---|
nic1.40 |
VLAN 40 sopra la scheda nic1: frame con tag 40 sullo stesso cavo del traffico senza tag |
link 1 di Corosync |
vmbr1.100 |
indirizzo del nodo nella VLAN 100 del bridge VLAN-aware vmbr1 (sopra il bond) |
rete di migrazione |
Le due reti non hanno router: il traffico non può passare da rtr-core e restare “in piedi” per vie traverse quando il link dedicato cade. E non si ripete il problema ARP del lab 15, perché ogni VLAN è un dominio di broadcast separato.
La rete di migrazione
Sezione intitolata “La rete di migrazione”Se non si indica altro, Proxmox VE fa passare le migrazioni sulla rete usata per la comunicazione del cluster: qui la rete di gestione, che porta anche il link 0 di Corosync. In Datacenter → Options → Migration Settings si sceglie:
- Network: la rete (CIDR) su cui i nodi si scambiano la memoria e i dischi durante le migrazioni;
- Type:
secure(predefinito: il traffico passa in un tunnel SSH cifrato) oppureinsecure(TCP in chiaro, più veloce, accettabile solo su una rete dedicata e isolata).
Ambiente e versioni della prova
Sezione intitolata “Ambiente e versioni della prova”Gli output e le misure di questo lab vengono da prove eseguite a novembre 2026 in questa configurazione:
| Componente | Configurazione della prova |
|---|---|
| Proxmox VE | 9.2.26, kernel 7.0.14-28-pve (Lab 04); Corosync e knet nelle versioni di quella release (non registrate: le elenca pveversion -v) |
| Corosync | trasporto knet, modalità dei link passive, nessuna priorità sui link (Lab 06) |
| Rete | porte 10 GbE (Lab 01); vmbr0 su nic0; nic1 condivisa da rete dello storage e VLAN 40; vmbr1 e VLAN 100 su bond0 (nic3 + nic4, active-backup, Lab 21); MTU 1500 ovunque |
| Migrazione | type=secure (tunnel SSH); VM 100 con 2 GiB di RAM e disco su rbd-vm (Ceph 20.2, Lab 17), quindi si copia solo la memoria |
Cosa misurano le prove e cosa no. C’è una migrazione per direzione, senza altro carico sulle reti: le prove mostrano da dove passa il traffico, non quale rete sia più veloce. La caduta del link 1 è simulata con ip link set nic1.40 down su un nodo: la porta nic1 resta attiva, quindi non è né un cavo staccato né un guasto dello switch, e toglie il link di riserva, non quello in uso.
Procedura
Sezione intitolata “Procedura”1. Le interfacce VLAN dalla GUI (desopve01)
Sezione intitolata “1. Le interfacce VLAN dalla GUI (desopve01)”-
Nodo desopve01 → System → Network → Create → Linux VLAN. Name
nic1.40(la GUI ricava da sé scheda e VLAN dal nome), IPv4/CIDR10.40.10.21/24, nessun gateway, Autostart attivo, commentoCorosync link 1.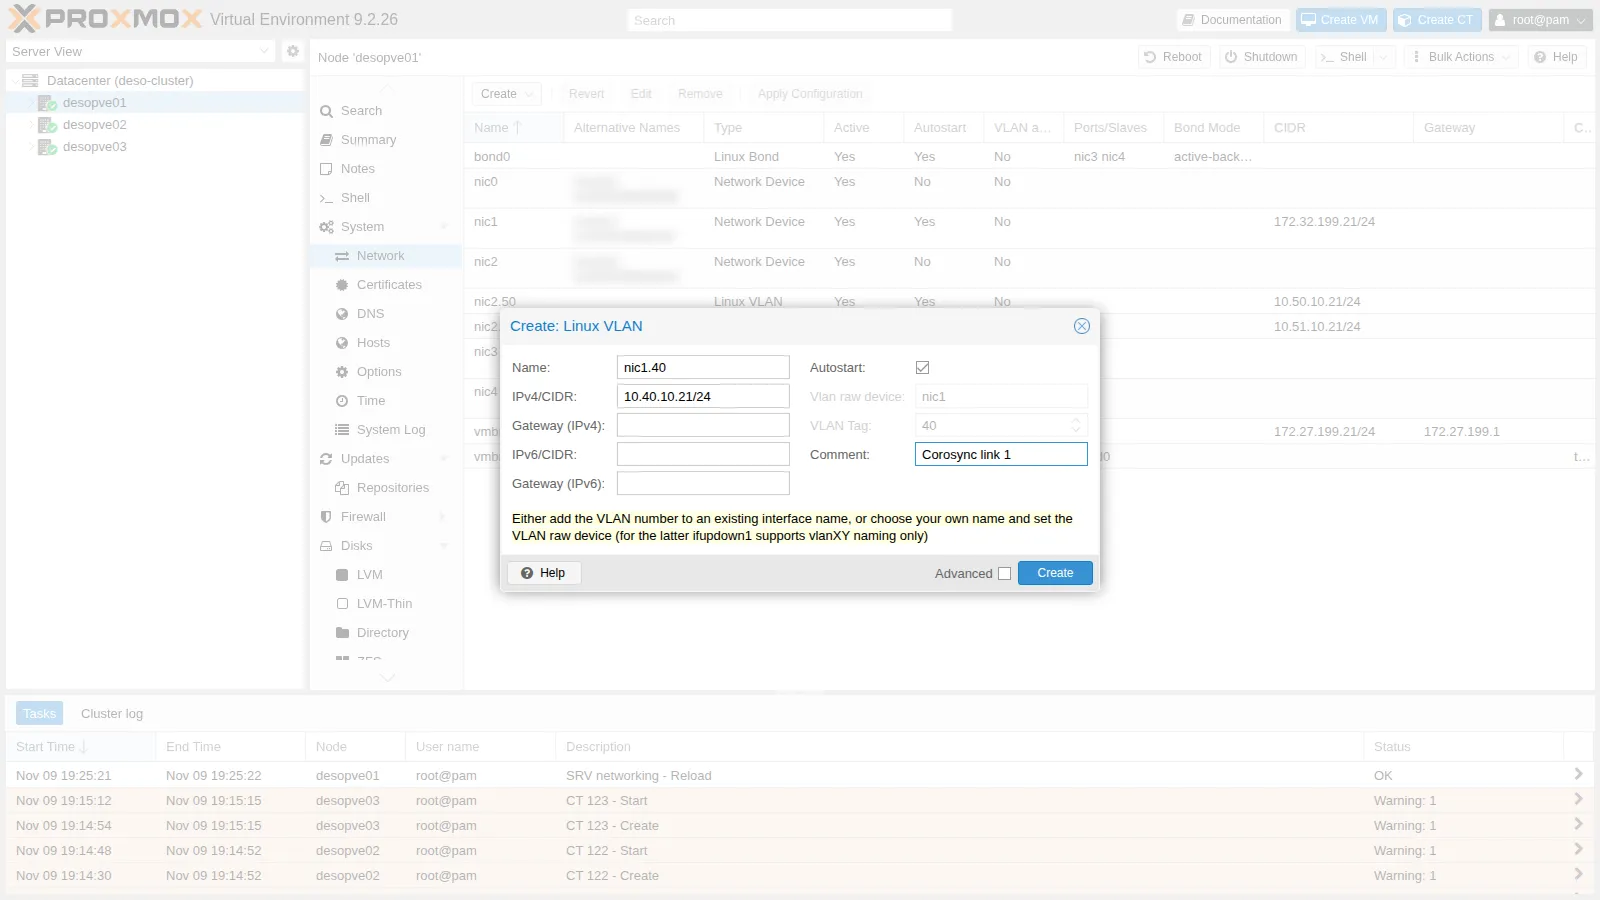
-
Create → Linux VLAN. Name
vmbr1.100, IPv4/CIDR10.100.10.21/24, commentomigrazione.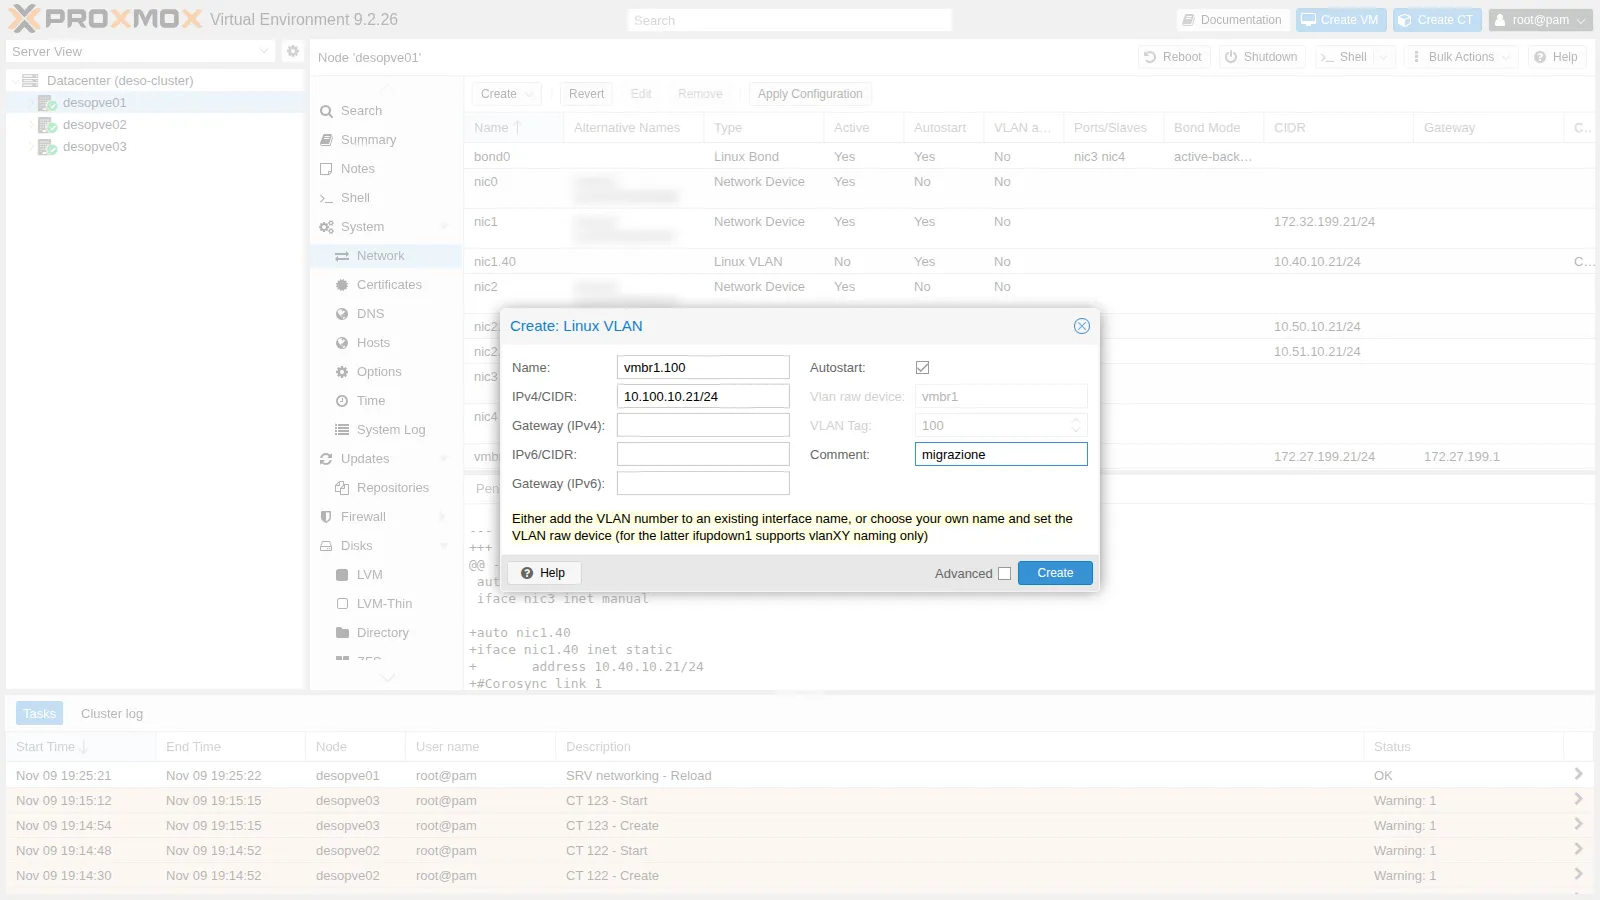
-
Controlla le modifiche in attesa e applicale con Apply Configuration.
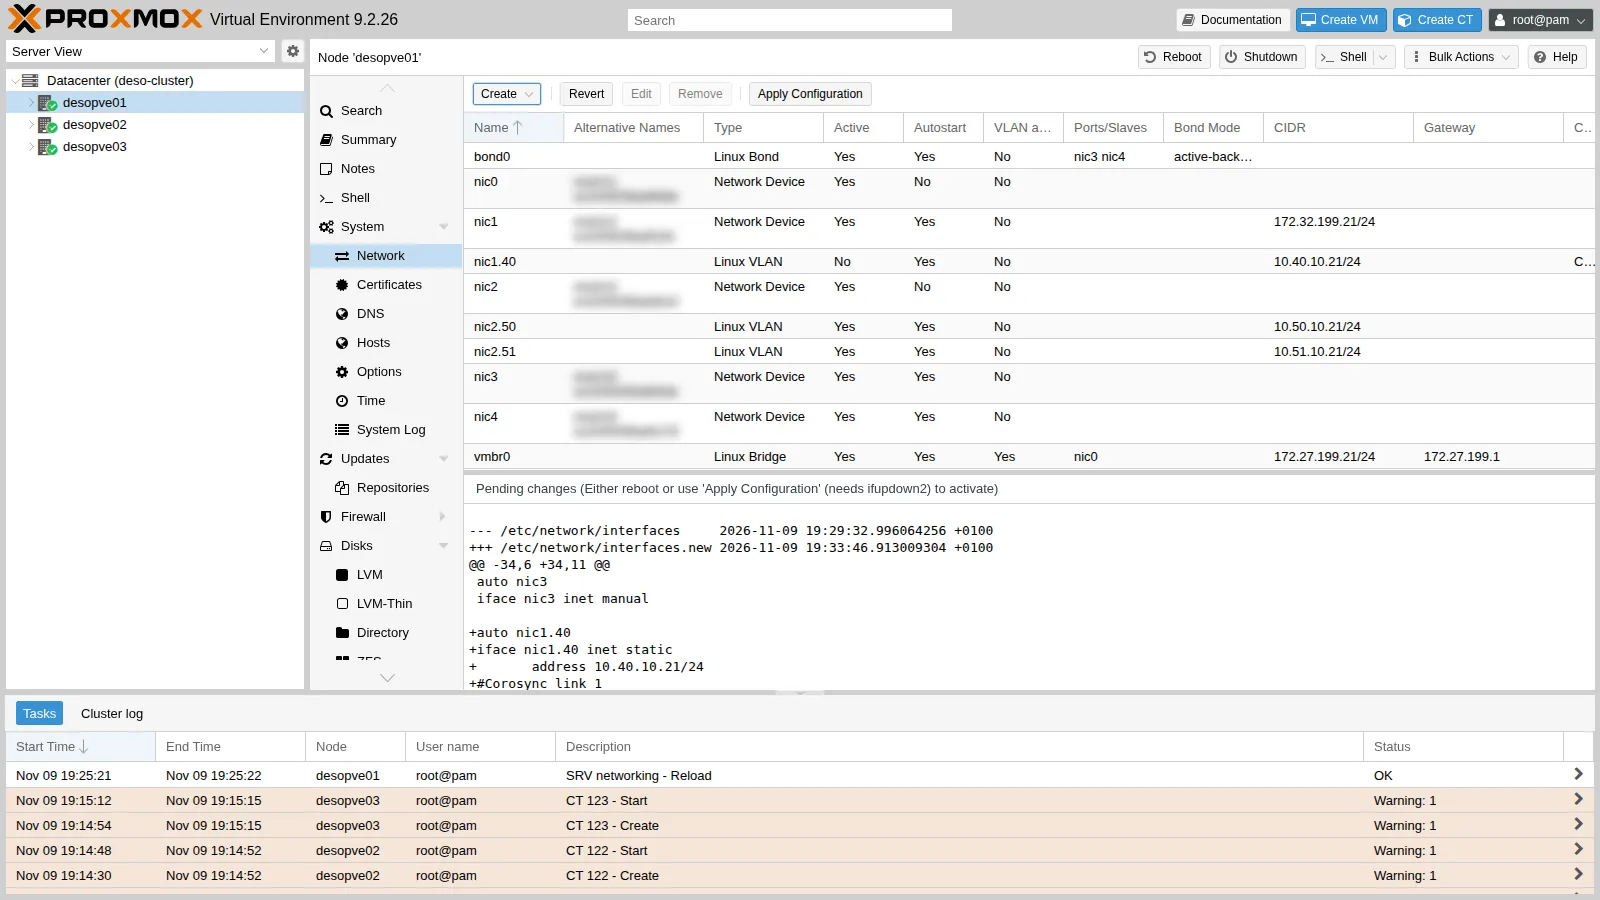
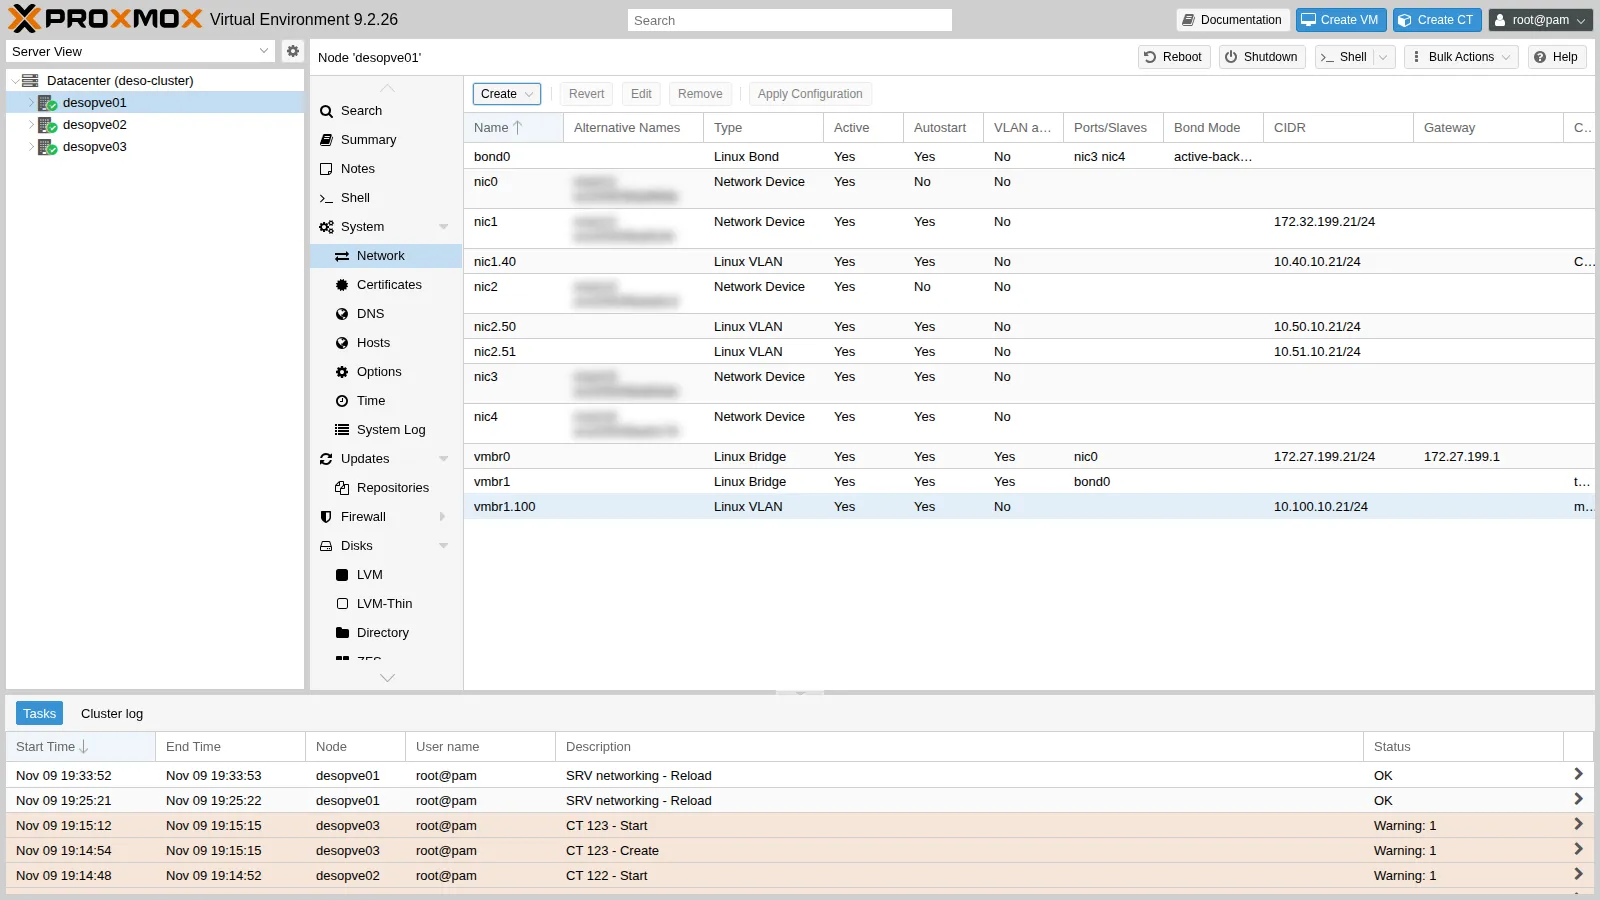 auto nic1.40iface nic1.40 inet staticaddress 10.40.10.21/24#Corosync link 1auto vmbr1.100iface vmbr1.100 inet staticaddress 10.100.10.21/24#migrazione
2. Le stesse interfacce sugli altri nodi (CLI)
Sezione intitolata “2. Le stesse interfacce sugli altri nodi (CLI)”Su desopve02 e desopve03 aggiungi gli stessi due blocchi (con .22 e .23) prima della riga source, dopo una copia del file (/root/interfaces.bak-lab22), poi ifreload -a. Verifica da desopve01:
for ip in 10.40.10.22 10.40.10.23 10.100.10.22 10.100.10.23; do printf "%s " $ip; ping -c2 -W1 $ip >/dev/null && echo ok || echo NO; done10.40.10.22 ok10.40.10.23 ok10.100.10.22 ok10.100.10.23 okip route get 10.40.10.2210.40.10.22 dev nic1.40 src 10.40.10.21 uid 0 cacheping -c1 -W1 10.40.10.1 >/dev/null 2>&1 || echo "nessun router su 10.40.10.0/24"nessun router su 10.40.10.0/243. Spostare il link 1 di Corosync sulla VLAN 40
Sezione intitolata “3. Spostare il link 1 di Corosync sulla VLAN 40”-
La situazione di partenza:
root@desopve01 corosync-cfgtool -nOutput Local node ID 1, transport knetnodeid: 2 reachableLINK: 0 udp (172.27.199.21->172.27.199.22) enabled connected mtu: 1397LINK: 1 udp (172.32.199.21->172.32.199.22) enabled connected mtu: 1397nodeid: 3 reachableLINK: 0 udp (172.27.199.21->172.27.199.23) enabled connected mtu: 1397LINK: 1 udp (172.32.199.21->172.32.199.23) enabled connected mtu: 1397 -
Si modifica sempre una copia di
/etc/pve/corosync.conf, la si controlla e poi la si mette al suo posto con un solomv. Un file a metà o sbagliato verrebbe distribuito subito a tutti i nodi. Oltre agli indirizzi va incrementatoconfig_version, altrimenti i nodi ignorano la modifica. Il valore dipende dalla storia del cluster (qui è 5, dopo l’ingresso e l’uscita didesopve04nel lab 18): il comandoperllo legge e lo aumenta di uno, qualunque sia.root@desopve01 cp /etc/pve/corosync.conf /root/corosync.conf.bak-lab22cp /etc/pve/corosync.conf /etc/pve/corosync.conf.newgrep config_version /etc/pve/corosync.conf.newOutput config_version: 5root@desopve01 sed -i "s/ring1_addr: 172.32.199.2/ring1_addr: 10.40.10.2/" /etc/pve/corosync.conf.newperl -pi -e 's/(config_version: )(\d+)/$1.($2+1)/e' /etc/pve/corosync.conf.newdiff -u /etc/pve/corosync.conf /etc/pve/corosync.conf.newOutput @@ -9,21 +9,21 @@nodeid: 1quorum_votes: 1ring0_addr: 172.27.199.21- ring1_addr: 172.32.199.21+ ring1_addr: 10.40.10.21}...- ring1_addr: 172.32.199.23+ ring1_addr: 10.40.10.23}}@@ -33,7 +33,7 @@totem {cluster_name: deso-cluster- config_version: 5+ config_version: 6interface {linknumber: 0}root@desopve01 mv /etc/pve/corosync.conf.new /etc/pve/corosync.conf -
Corosync rilegge il file ma, in questa versione, non cambia l’indirizzo di un link già attivo, e il log lo dice:
root@desopve01 journalctl -u corosync --since "-1min" --no-pagerOutput ... [CFG ] Config reload requested by node 1... [TOTEM ] new config has different address for link 1 (addr changed from 172.32.199.21 to 10.40.10.21). Internal value was NOT changed....... [CFG ] Cannot configure new interface definitions: To reconfigure an interface it must be deleted and recreated. A working interface needs to be available to corosync at all timesDecisione. La documentazione di Proxmox VE prevede questo caso: una modifica che non si può applicare con Corosync in funzione richiede il riavvio del servizio. Si riavvia Corosync un nodo alla volta: mentre un nodo si riavvia, gli altri due restano collegati sul link 0 e mantengono 2 voti su 3. Ogni comando legge il quorum 6 secondi dopo il riavvio:
root@desopve03 systemctl restart corosync; sleep 6; pvecm status | grep ^QuorateOutput Quorate: Yesroot@desopve02 systemctl restart corosync; sleep 6; pvecm status | grep ^QuorateOutput Quorate: Yesroot@desopve01 systemctl restart corosync; sleep 6; pvecm status | grep ^QuorateOutput Quorate: Yes -
Risultato: ora il link 1 usa la VLAN 40:
root@desopve01 corosync-cfgtool -nOutput Local node ID 1, transport knetnodeid: 2 reachableLINK: 0 udp (172.27.199.21->172.27.199.22) enabled connected mtu: 1397LINK: 1 udp (10.40.10.21->10.40.10.22) enabled connected mtu: 1397nodeid: 3 reachableLINK: 0 udp (172.27.199.21->172.27.199.23) enabled connected mtu: 1397LINK: 1 udp (10.40.10.21->10.40.10.23) enabled connected mtu: 1397Anche la GUI lo mostra in Datacenter → Cluster, con Config Version
6: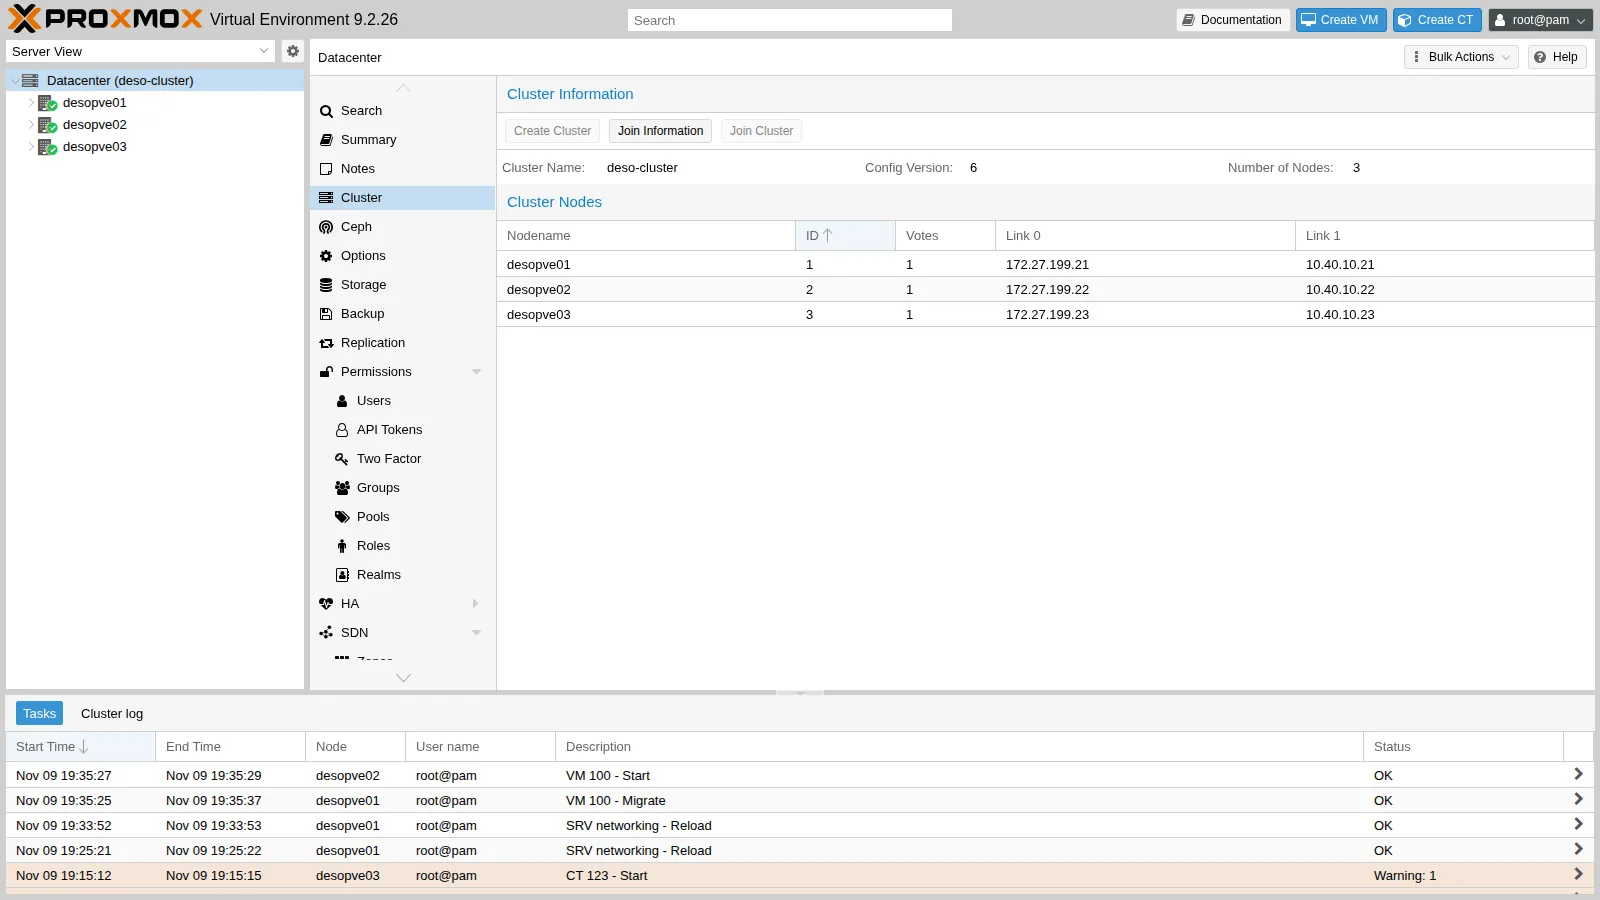
4. La rete di migrazione
Sezione intitolata “4. La rete di migrazione”-
Prima: la VM 100 (disco su Ceph, 2 GiB di RAM) migra da
desopve01adesopve02con le impostazioni predefinite, quindi sulla rete di gestione:root@desopve01 qm migrate 100 desopve02 --onlineOutput ...2026-11-09 19:35:29 start remote tunnel2026-11-09 19:35:30 ssh tunnel ver 12026-11-09 19:35:30 migration downtime limit: 100 ms2026-11-09 19:35:30 start migrate command to unix:/run/qemu-server/100.migrate2026-11-09 19:35:31 migration active, transferred 221.0 MiB of 2.0 GiB VM-state, 9.8 GiB/s2026-11-09 19:35:32 average migration speed: 1.0 GiB/s - downtime 53 ms2026-11-09 19:35:32 migration completed, transferred 289.1 MiB VM-state2026-11-09 19:35:37 migration finished successfully (duration 00:00:12) -
Datacenter → Options → Migration Settings → Edit. Il campo Network propone gli indirizzi del nodo: scegli quello di
vmbr1.100. Type restasecure.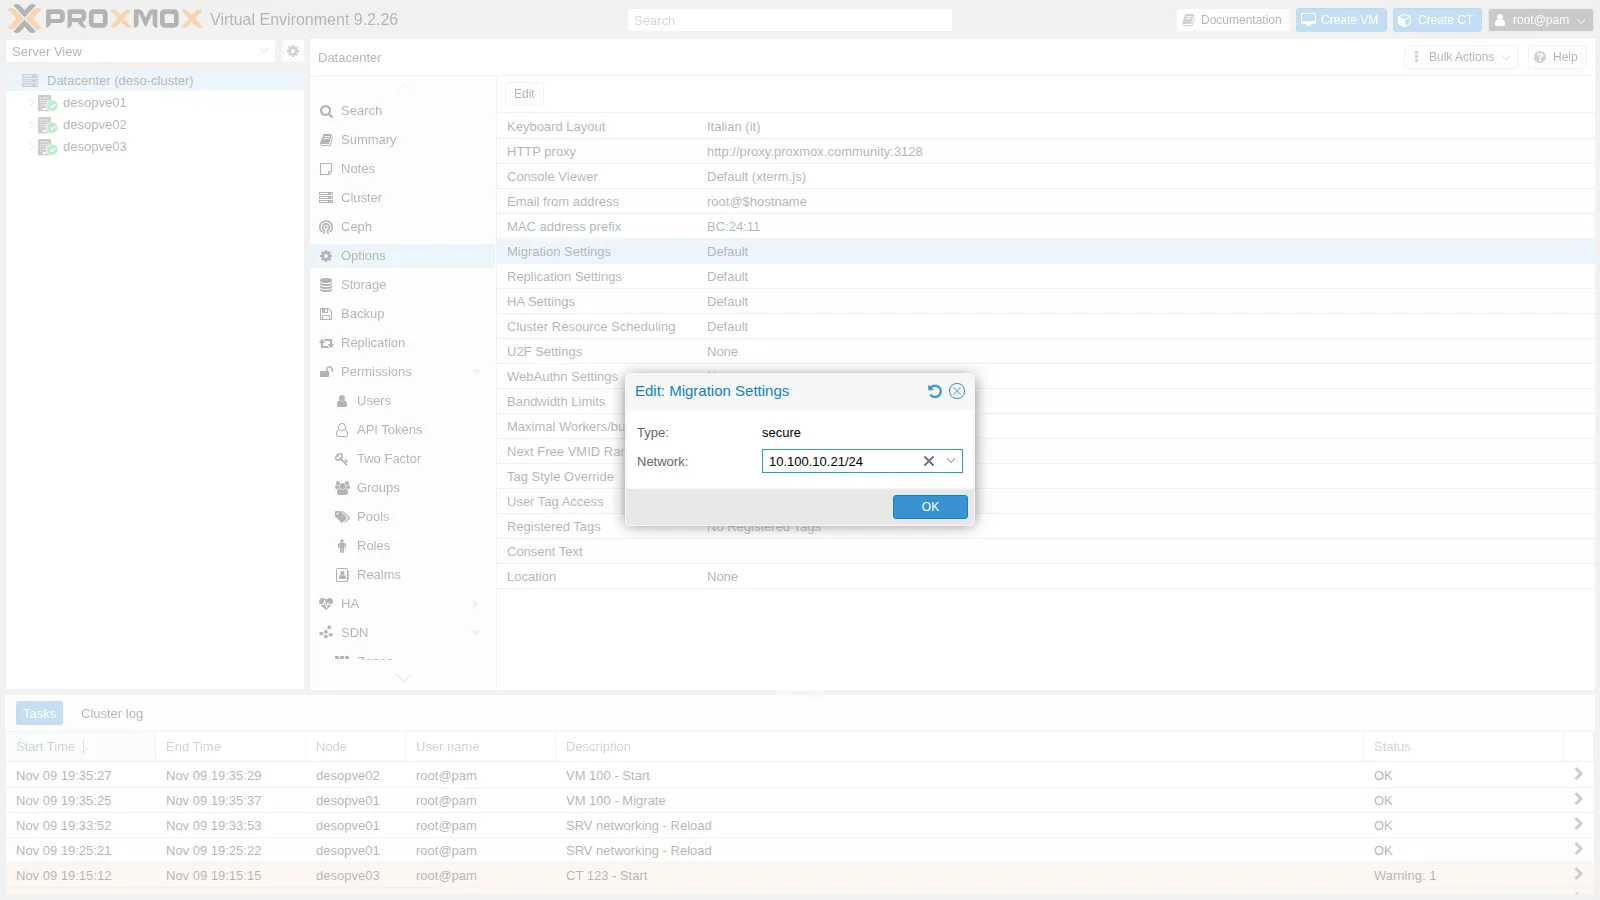
La GUI salva l’indirizzo del nodo (
10.100.10.21/24): funziona, perché vale per tutta la rete che lo contiene. Per chiarezza conviene scrivere l’indirizzo della rete:root@desopve01 pvesh set /cluster/options --migration network=10.100.10.0/24,type=securegrep migration /etc/pve/datacenter.cfgOutput migration: network=10.100.10.0/24,type=secure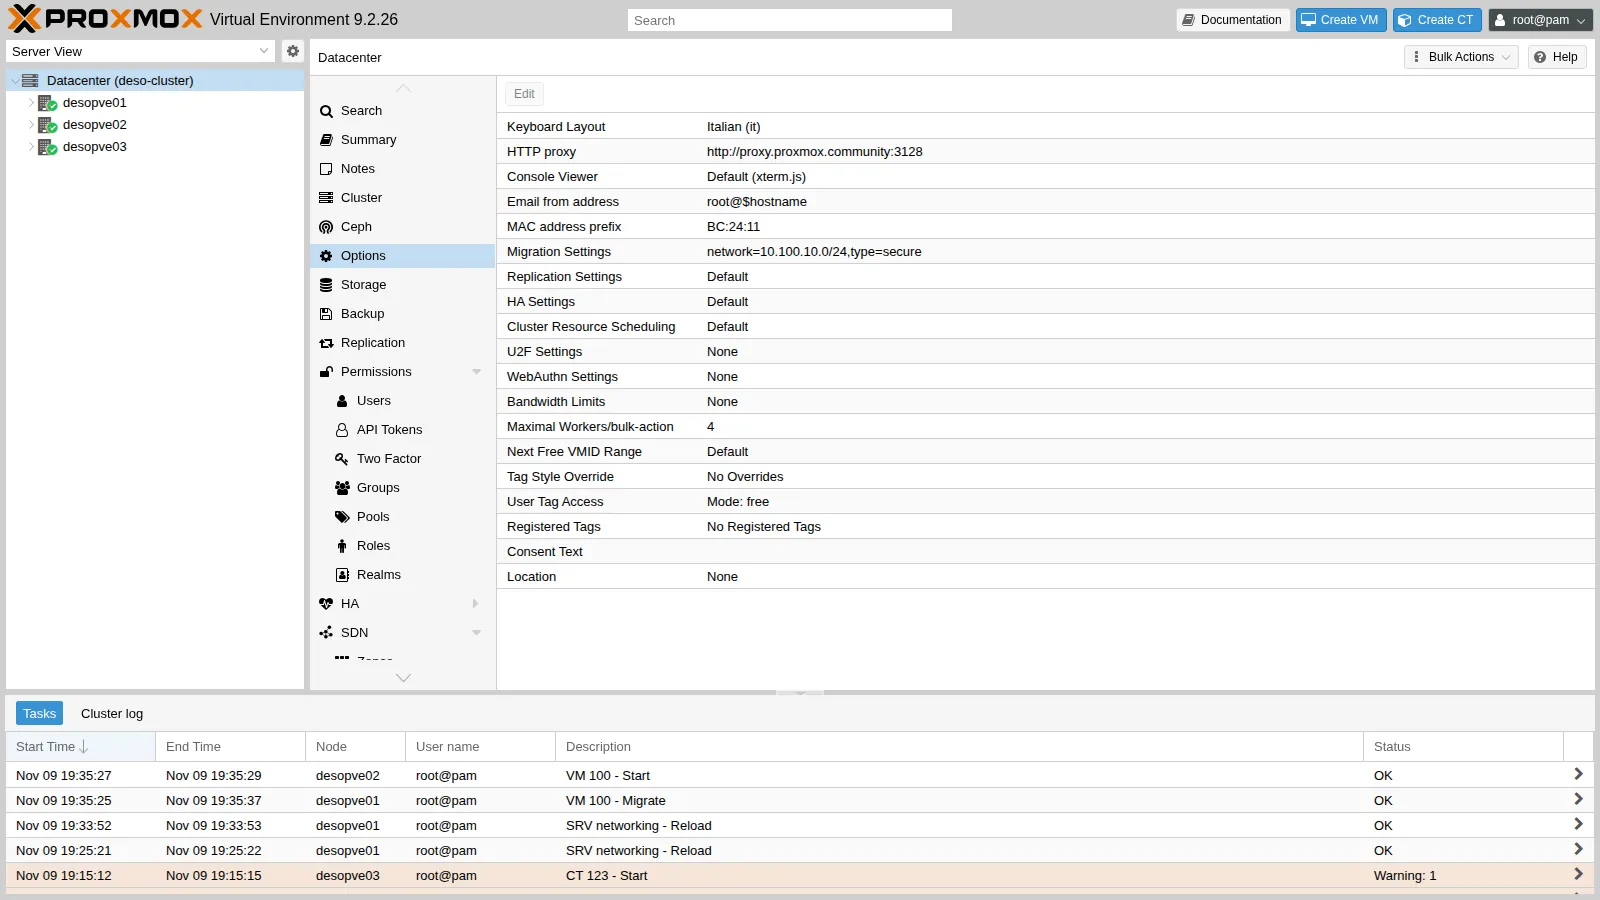
-
Dopo: la VM torna su
desopve01. Contando i byte ricevuti dalle interfacce didesopve01prima e dopo la migrazione, si vede da dove è passata:root@desopve01 cat /sys/class/net/vmbr1.100/statistics/rx_bytes /sys/class/net/vmbr0/statistics/rx_bytesroot@desopve02 qm migrate 100 desopve01 --onlineOutput ...2026-11-09 19:38:19 average migration speed: 1.0 GiB/s - downtime 9 ms2026-11-09 19:38:19 migration completed, transferred 290.4 MiB VM-state2026-11-09 19:38:24 migration finished successfully (duration 00:00:11)root@desopve01 cat /sys/class/net/vmbr1.100/statistics/rx_bytes /sys/class/net/vmbr0/statistics/rx_bytesLa differenza tra le due letture:
Interfaccia di desopve01Byte ricevuti durante la migrazione vmbr1.100(migrazione)291 MiB vmbr0(gestione)0 MiB La migrazione è passata dalla VLAN 100: 291 MiB ricevuti su
vmbr1.100, in linea con i 290,4 MiB di stato della VM indicati dal task, contro 0 MiB (arrotondati al MiB) suvmbr0.Come leggere le due migrazioni:
- Misura: sulla rete di gestione il task dura 12 s e riporta un fermo di 53 ms; sulla VLAN 100, 11 s e 9 ms. In entrambi i casi vengono trasferiti circa 290 MiB di stato su 2 GiB di RAM.
- Interpretazione: le due prove non confrontano le reti. C’è una sola prova per direzione, in direzioni opposte, i due percorsi hanno porte 10 GbE e un trasferimento di qualche centinaio di MiB è troppo breve per mostrare una differenza; anche lo scarto nel fermo non si può attribuire alla rete. Nemmeno le velocità del log misurano la rete. I 9,8 GiB/s stampati durante la copia sono più di quanto possa portare una porta da 10 Gbit/s. L’
average migration speed, 1,0 GiB/s in entrambe le prove, non è una velocità di trasferimento: come spiega il Lab 48, Proxmox VE la calcola come la RAM totale del guest divisa per la durata della fase di memoria, contata in secondi interi. Con 2 GiB di RAM, 1,0 GiB/s dice solo che la fase di memoria è durata circa 2 secondi, con la risoluzione di un secondo; il valore conta tutta la RAM, non i 290 MiB inviati davvero, e con questa risoluzione non distingue le due prove. Quello che è passato in rete lo misurano i contatori. - Cosa dà qui la rete dedicata: le migrazioni non attraversano più la rete di gestione, quella che porta il link 0 di Corosync. Se le renda anche più veloci è un’altra domanda: servono più prove per direzione, con una VM che usa molta più memoria, con e senza carico su
vmbr0. Un guadagno è da aspettarsi solo se la rete dedicata è più veloce di quella condivisa, o se quella condivisa è occupata.
5. Caduta del link dedicato di Corosync
Sezione intitolata “5. Caduta del link dedicato di Corosync”Con le priorità predefinite il link 1 è quello di riserva: spegnerlo toglie la ridondanza senza spostare il traffico di Corosync (la perdita del link 0 si prova nel Lab 06). Su desopve03 spegni solo la VLAN 40 (la scheda nic1 resta attiva, con il percorso iSCSI):
ip link set nic1.40 downcorosync-cfgtool -n | sed -n "/nodeid: 3/,\$p"nodeid: 3 reachable LINK: 0 udp (172.27.199.21->172.27.199.23) enabled connected mtu: 1397 LINK: 1 udp (10.40.10.21->10.40.10.23) enabled mtu: 1397pvecm status | grep -E "^Quorate|Total votes"Quorate: YesTotal votes: 3multipath -ll | grep -c "active ready"2Il link 1 verso desopve03 non è più connected; il nodo resta raggiungibile sul link 0 e il cluster mantiene tutti e tre i voti. multipath -ll mostra ancora attivi i due percorsi iSCSI: spegnere l’interfaccia VLAN non ha toccato nic1. Finché il link 1 non torna, però, il cluster ha un solo link verso desopve03. Riaccendi la VLAN e Corosync la riprende da solo:
ip link set nic1.40 upjournalctl -u corosync --since "-2min" --no-pager | grep "host: 3 link: 1"Nov 09 19:38:34 desopve01 corosync[120106]: [KNET ] link: host: 3 link: 1 is downNov 09 19:38:44 desopve01 corosync[120106]: [KNET ] rx: host: 3 link: 1 is upI due messaggi distano 10 secondi, ma l’intervallo comprende il tempo in cui l’interfaccia è rimasta spenta, che non è stato registrato: non è un tempo di rilevamento né un tempo di ripresa. Per misurarli, annota l’ora di ogni comando (date +%T.%N; ip link set nic1.40 down) e confrontala con l’ora dei messaggi link: 1 is down e is up. Per verificare quale link porta il traffico, leggi due volte su desopve01, a qualche secondo di distanza, i contatori di knet: corosync-cmapctl -m stats | grep -E 'node3\.link[01]\.tx_data_bytes'. Il contatore che cresce è quello del link in uso.
6. Il quadro delle reti del laboratorio
Sezione intitolata “6. Il quadro delle reti del laboratorio”flowchart LR
subgraph N["desopve01-03 (ultimo ottetto .21, .22, .23)"]
V0["vmbr0 su nic0<br/>gestione 172.27.199.x<br/>Corosync link 0"]
N1["nic1<br/>storage 172.32.199.x<br/>secondo percorso iSCSI"]
N140["nic1.40<br/>Corosync link 1<br/>10.40.10.x"]
N250["nic2.50<br/>Ceph public 10.50.10.x"]
N251["nic2.51<br/>Ceph cluster 10.51.10.x"]
V1["vmbr1 su bond0 (nic3 + nic4)<br/>VM: VLAN 10, 20, ..."]
V1100["vmbr1.100<br/>migrazione 10.100.10.x"]
end
V0 --- RTR["rtr-core<br/>172.27.199.1 / 172.32.199.1"]
N1 --- NAS["desonas<br/>172.27.199.10 / 172.32.199.10"]
V0 --- SRV["DC .20, netsvc .250<br/>PBS .40, PDM .41"]
N1 --- RTR
| Rete | VLAN | Subnet | Interfaccia sui nodi | Gateway | Uso |
|---|---|---|---|---|---|
| Gestione | senza tag | 172.27.199.0/24 | vmbr0 (nic0) |
rtr-core .1 |
GUI, SSH, DNS, NTP, proxy, Corosync link 0 |
| Storage | senza tag | 172.32.199.0/24 | nic1 |
rtr-core .1 |
secondo percorso iSCSI verso il NAS |
| Corosync link 1 | 40 | 10.40.10.0/24 | nic1.40 |
nessuno | cluster |
| Ceph public | 50 | 10.50.10.0/24 | nic2.50 |
nessuno | client, MON |
| Ceph cluster | 51 | 10.51.10.0/24 | nic2.51 |
nessuno | replica tra gli OSD |
| Migrazione | 100 | 10.100.10.0/24 | vmbr1.100 (bond0) |
nessuno | migrazioni |
| VM (prova) | 10, 20 | 10.10.10.0/24, 10.20.20.0/24 | vmbr1 (bond0) |
nessuno (fino al lab 26) | container 121-123 |
In produzione le reti più critiche avrebbero schede fisiche proprie: Corosync almeno su una porta dedicata, Ceph e storage su schede veloci separate dal traffico delle VM. Nel laboratorio sono separate con le VLAN. Una VLAN separa gli indirizzi e i domini di broadcast, e senza gateway il suo traffico non può uscirne; non separa invece la banda della porta. La VLAN 40 condivide nic1 con il secondo percorso iSCSI, la VLAN 100 condivide bond0 con le VM. Se questo conti per Corosync qui non è stato misurato: bisognerebbe osservare la latenza del link (corosync-cmapctl -m stats | grep -E 'link1\.latency_(ave|max)') mentre si satura nic1.
Verifica e test
Sezione intitolata “Verifica e test”Il lab è riuscito se il link 1 lavora sulla 10.40.10.0/24 su ogni nodo con il cluster in quorum, se il traffico della migrazione compare nei contatori di vmbr1.100 e se la perdita di nic1.40 su un nodo lascia il cluster in quorum sul link 0.
| Controllo | Risultato atteso | Osservato nella prova |
|---|---|---|
Interfacce VLAN 40 e 100 su desopve01-03 |
raggiungibili tra i nodi, nessun router | tutte raggiungibili; nessuna risposta da 10.40.10.1 |
Ricarica di corosync.conf con indirizzi nuovi |
l’indirizzo del link attivo non cambia: serve il riavvio | log: Internal value was NOT changed |
| Riavvio di Corosync un nodo alla volta | cluster in quorum | Quorate: Yes 6 s dopo ogni riavvio; link 1 su 10.40.10.0/24 |
| Migrazione sulla gestione, poi sulla VLAN 100 | completata | 12 s e 11 s (durata del task); fermo riportato dal task 53 ms e 9 ms; una prova per direzione |
| Dove passa la migrazione | byte su vmbr1.100, non su vmbr0 |
291 MiB su vmbr1.100, 0 MiB su vmbr0 |
nic1.40 spenta su desopve03 |
link 1 non connesso, cluster in quorum sul link 0, storage non coinvolto | 3 voti, quorum; 2 percorsi iSCSI attivi; link 1 ripreso da solo alla riaccensione della VLAN |
Stato finale del lab
Sezione intitolata “Stato finale del lab”- Corosync: link 0 su 172.27.199.21-23, link 1 su 10.40.10.21-23 (VLAN 40,
nic1.40),config_version6. Copia del file precedente in/root/corosync.conf.bak-lab22sudesopve01. - Migrazione:
migration: network=10.100.10.0/24,type=secureindatacenter.cfg, con interfaccevmbr1.10010.100.10.21-23. nic1: con la 172.32.199.0/24 resta la rete dello storage (secondo percorso iSCSI).- Ceph: invariato su
nic2.50/nic2.51,HEALTH_OK. - VM 100 accesa su
desopve01. CT 121-123 invariati suvmbr1(VLAN 10 e 20). - Copie della rete precedente in
/root/interfaces.bak-lab22sudesopve02edesopve03.
Cosa hai imparato
Sezione intitolata “Cosa hai imparato”- Quale link deve portare Corosync: senza priorità knet usa il link 0. Decidi quale rete ha la latenza più bassa e costante e rendila il link preferito, con il numero o con
knet_link_priority; verificalo con i contatori di knet, senza darlo per scontato. - Come cambiare un indirizzo di Corosync senza rischi: modifichi una copia, incrementi
config_version, la metti al suo posto e leggi il log. Se dice che l’indirizzo di un link attivo non è cambiato, riavvii Corosync un nodo alla volta, controllando il quorum prima di passare al successivo. - Cosa separa una VLAN e cosa no: indirizzi e domini di broadcast e, senza gateway, le strade verso altre reti; non la banda della porta. Per Corosync in produzione serve quindi una porta dedicata, non solo una VLAN dedicata.
- Come dimostrare da dove passa il traffico: confronti i contatori di byte delle interfacce prima e dopo; le velocità stampate dal task di migrazione non sono il throughput della rete.
- Quando conviene una rete di migrazione dedicata: sempre, per tenere le raffiche delle migrazioni lontane dalla rete che porta Corosync; per la velocità, solo se è più veloce di quella condivisa, e lo misuri con più prove.
Riferimenti
Sezione intitolata “Riferimenti”- Proxmox VE – Cluster network: requisiti e separazione
- Proxmox VE – Corosync redundancy e priorità dei link
- Proxmox VE – Edit corosync.conf
- Proxmox VE – Migration type: secure e insecure
- Proxmox VE – Migration network
- corosync.conf(5) –
link_modeeknet_link_priority - cmap_keys(7) – i contatori
stats.knet